



Что это?
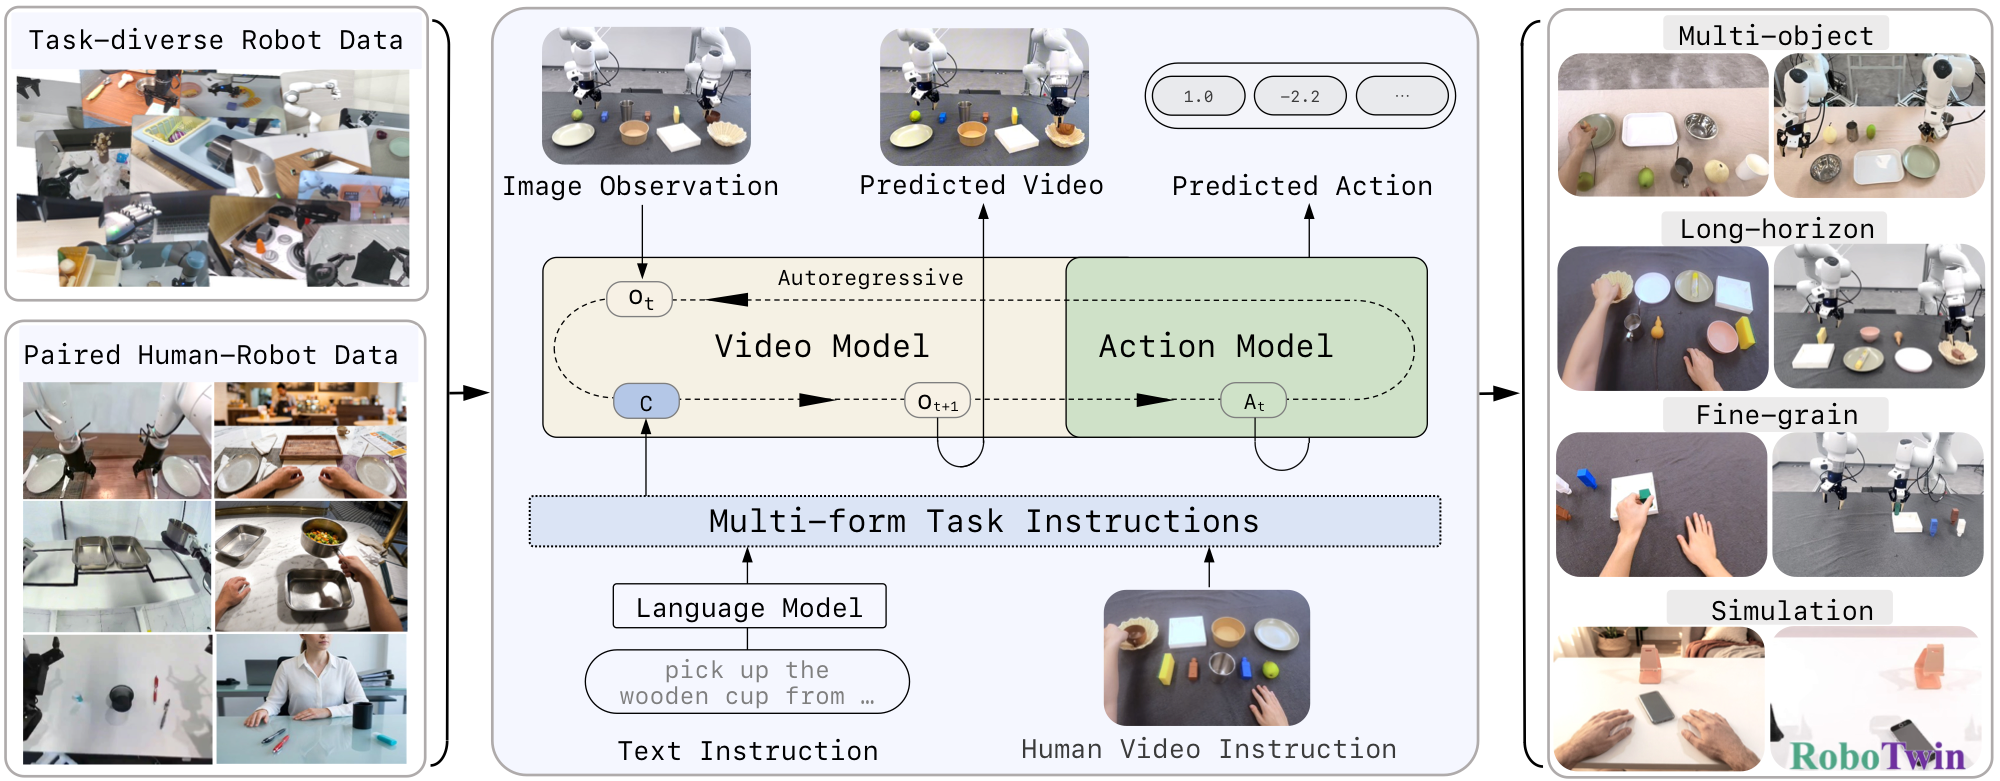
 Zero-WAM — исследовательский метод zero-shot кросс-задачной роботизированной манипуляции: причинная политика «видео—действие» (causal video-action policy), которая обучается in-context моделированию «мир—действие» и предсказывает будущие наблюдения робота и исполняемые действия по текстовым инструкциям или видео с демонстрациями человека.
Это работающая кодовая база, которую можно запустить, или пока просто статья?Пока это только статья. Код, обученная модель и данные для обучения ещё не опубликованы — всё помечено как «ожидается до 15 сентября 2026 года».
Пока это только статья. Код, обученная модель и данные для обучения ещё не опубликованы — всё помечено как «ожидается до 15 сентября 2026 года».Как мне самому попробовать Zero-WAM прямо сейчас?Пока запустить нельзя. Сейчас в репозитории размещена только статья (arXiv:2608.26103); код, веса предобученной модели и данные для обучения не были опубликованы на момент написания этого README.
Пока запустить нельзя. Сейчас в репозитории размещена только статья (arXiv:2608.26103); код, веса предобученной модели и данные для обучения не были опубликованы на момент написания этого README.А оно действительно хорошо решает любую задачу манипуляции?Нет. Хотя средний zero-shot успех подскакивает до 46,95% на семи незнакомых задачах RoboTwin 2.0, некоторые задачи остаются очень сложными: задача 'Stack blocks three' достигает лишь 9,00% успеха против 0% у базовых методов.
Нет. Хотя средний zero-shot успех подскакивает до 46,95% на семи незнакомых задачах RoboTwin 2.0, некоторые задачи остаются очень сложными: задача 'Stack blocks three' достигает лишь 9,00% успеха против 0% у базовых методов.Для кого это?Исследователи в области робототехники и машинного обучения, работающие над политиками манипуляции и in-context/видео-обучением, а не конечные пользователи, которым нужен готовый контроллер робота, — пока ничего нельзя запустить.
Исследователи в области робототехники и машинного обучения, работающие над политиками манипуляции и in-context/видео-обучением, а не конечные пользователи, которым нужен готовый контроллер робота, — пока ничего нельзя запустить.Что такое HumanGen и почему это важно?HumanGen — пайплайн данных, который превращает сэмплированные по задачам траектории робота в соответствующие видео с демонстрациями человека, создавая 74,2 тыс. пар «человек—робот» для in-context-обучения (ICL) на 8,6 тыс. задач, чтобы политика могла учиться на видеоподсказках человека без сбора новых роботизированных данных.
HumanGen — пайплайн данных, который превращает сэмплированные по задачам траектории робота в соответствующие видео с демонстрациями человека, создавая 74,2 тыс. пар «человек—робот» для in-context-обучения (ICL) на 8,6 тыс. задач, чтобы политика могла учиться на видеоподсказках человека без сбора новых роботизированных данных.Насколько хорошо Zero-WAM выступает по сравнению с предыдущими работами?На семи незнакомых задачах RoboTwin 2.0 Zero-WAM достигает среднего zero-shot успеха 46,95%, опережая LingBot-VA с его 17,45% на 29,50 процентного пункта и намного превосходя WAN-Action с его 10,98%.
На семи незнакомых задачах RoboTwin 2.0 Zero-WAM достигает среднего zero-shot успеха 46,95%, опережая LingBot-VA с его 17,45% на 29,50 процентного пункта и намного превосходя WAN-Action с его 10,98%.Зачем использовать видео человека как инструкции к задаче вместо простого текста?Видео с демонстрациями человека служат более богатой и точной визуальной спецификацией задачи, чем простой текст: причинная политика «видео—действие» может понять, что делать на незнакомых задачах, наблюдая, как их выполняет человек.
Видео с демонстрациями человека служат более богатой и точной визуальной спецификацией задачи, чем простой текст: причинная политика «видео—действие» может понять, что делать на незнакомых задачах, наблюдая, как их выполняет человек.Сколько данных для обучения использует Zero-WAM?Он объединяет ресемплинг пяти публичных роботизированных датасетов с разнообразием задач (более 6 тыс. задач, около 400 тыс. траекторий на эпоху) с 74,2 тыс. парами «человек—робот» для ICL, созданными HumanGen и охватывающими внешние, внутренние, симуляционные и реальные источники.
Он объединяет ресемплинг пяти публичных роботизированных датасетов с разнообразием задач (более 6 тыс. задач, около 400 тыс. траекторий на эпоху) с 74,2 тыс. парами «человек—робот» для ICL, созданными HumanGen и охватывающими внешние, внутренние, симуляционные и реальные источники.What are similar projects?RoboICL, OpenWAM, flex-pi, video-prediction-policy-2, Motus2, Embodied-AI-Start, Code-as-World, EasyWAM
RoboICL, OpenWAM, flex-pi, video-prediction-policy-2, Motus2, Embodied-AI-Start, Code-as-World, EasyWAMWhich topics is it in?in-context-learning, vision-language-models, world-action-model, vla, data-pipeline, robot, world-models, embodied-ai, arxiv, vision-language-model, paper, robotics
in-context-learning, vision-language-models, world-action-model, vla, data-pipeline, robot, world-models, embodied-ai, arxiv, vision-language-model, paper, robotics