19.6K ·GitHub
Что это такое?
 KTransformers — исследовательский фреймворк для эффективного инференса и дообучения больших языковых моделей с помощью гетерогенных вычислений на CPU и GPU. Он позволяет запускать огромные MoE-модели на оборудовании, где видеопамяти (VRAM) недостаточно, чтобы разместить их целиком на GPU.
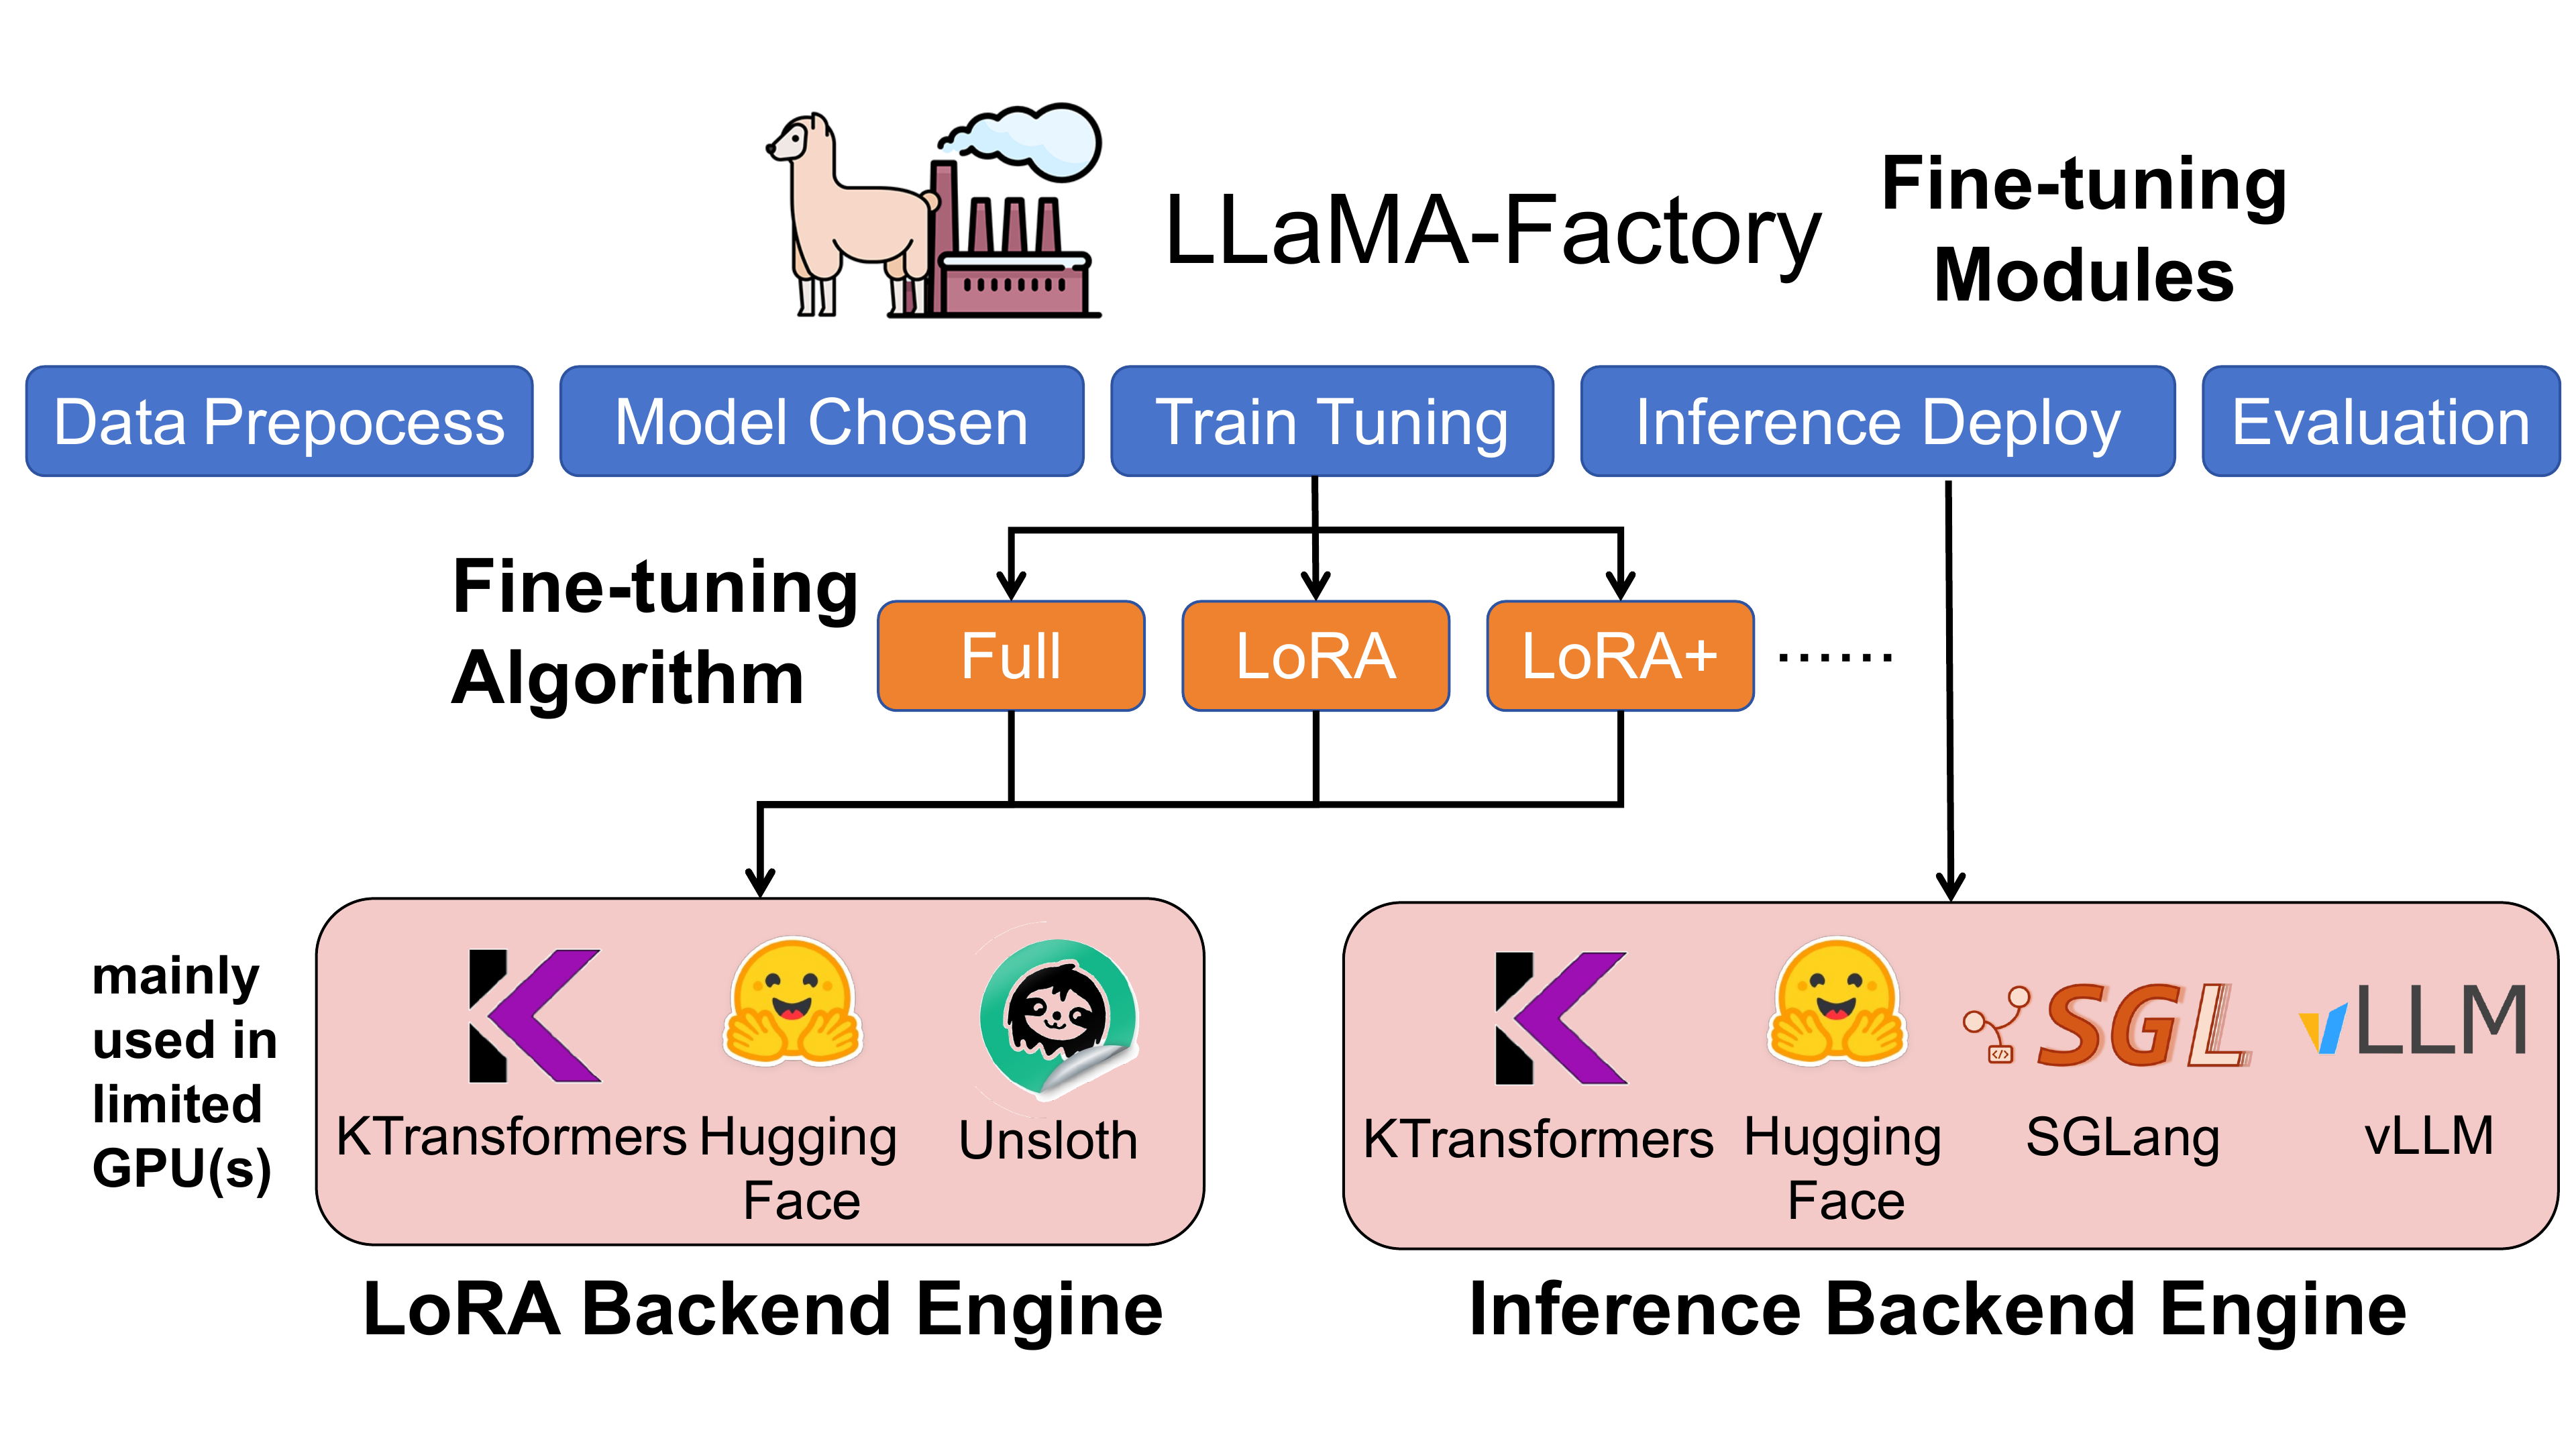
Это готовое чат-приложение или то, что я встраиваю в собственную инфраструктуру для инференса?Это фреймворк и библиотека ядра, а не приложение: вы интегрируете его Python API kt-kernel в серверы инференса, например SGLang, для обслуживания запросов, либо в LlamaFactory для дообучения.
Это фреймворк и библиотека ядра, а не приложение: вы интегрируете его Python API kt-kernel в серверы инференса, например SGLang, для обслуживания запросов, либо в LlamaFactory для дообучения.Как запустить инференс или дообучение с его помощью?В репозитории есть отдельные руководства Quick Start: для инференса (через Python API kt-kernel, часто вместе с SGLang) и для SFT (через интеграцию с LlamaFactory и MoE Fine-Tuning Cookbook).
В репозитории есть отдельные руководства Quick Start: для инференса (через Python API kt-kernel, часто вместе с SGLang) и для SFT (через интеграцию с LlamaFactory и MoE Fine-Tuning Cookbook).Какое железо нужно, чтобы этим реально пользоваться?Нужны процессоры с инструкциями AMX или AVX512/AVX2 для квантованных ядер, а также GPU (NVIDIA, AMD через ROCm, Intel Arc или Ascend NPU). Запуск самых крупных моделей, например DeepSeek-R1, может требовать до 382 ГБ памяти DRAM или нескольких GPU.
Нужны процессоры с инструкциями AMX или AVX512/AVX2 для квантованных ядер, а также GPU (NVIDIA, AMD через ROCm, Intel Arc или Ascend NPU). Запуск самых крупных моделей, например DeepSeek-R1, может требовать до 382 ГБ памяти DRAM или нескольких GPU.Есть ли аппаратные ограничения, которые стоит знать, прежде чем пробовать?Некоторые функции изначально были доступны только на процессорах Intel с AMX. LoRA-дообучение лишь недавно получило поддержку обычных x86-процессоров с AVX512 (включая серверы AMD) без AMX, поэтому старые конфигурации могут не получать новых оптимизаций.
Некоторые функции изначально были доступны только на процессорах Intel с AMX. LoRA-дообучение лишь недавно получило поддержку обычных x86-процессоров с AVX512 (включая серверы AMD) без AMX, поэтому старые конфигурации могут не получать новых оптимизаций.Работает ли это на Windows или только на Linux-серверах?Оно работает нативно как на Windows, так и на Linux и поддерживает несколько бэкендов GPU: NVIDIA, AMD (ROCm), Intel Arc и Ascend NPU.
Оно работает нативно как на Windows, так и на Linux и поддерживает несколько бэкендов GPU: NVIDIA, AMD (ROCm), Intel Arc и Ascend NPU.Какую скорость инференса можно ожидать для DeepSeek-R1?На системе с 8×L20 GPU и процессором Xeon Gold 6454S KTransformers достигает примерно 227.85 токенов/с общей пропускной способности и 87.58 токенов/с выходной пропускной способности при параллельной обработке 8 запросов для DeepSeek-R1-0528 (FP8).
На системе с 8×L20 GPU и процессором Xeon Gold 6454S KTransformers достигает примерно 227.85 токенов/с общей пропускной способности и 87.58 токенов/с выходной пропускной способности при параллельной обработке 8 запросов для DeepSeek-R1-0528 (FP8).Можно ли дообучить огромную MoE-модель на одной потребительской видеокарте?Да — Qwen3-30B-A3B можно дообучить примерно на 24 ГБ видеопамяти на одной RTX 4090, а DeepSeek-V3/R1 — примерно на 80 ГБ суммарно на 4x RTX 4090.
Да — Qwen3-30B-A3B можно дообучить примерно на 24 ГБ видеопамяти на одной RTX 4090, а DeepSeek-V3/R1 — примерно на 80 ГБ суммарно на 4x RTX 4090.Какие модели получают поддержку в день релиза?Среди недавних релизов с поддержкой day-0 — GLM-5.3-flash, MiniMax-M3, GLM-5.2, Kimi-K2.5 и GLM-5, а также продолжающаяся поддержка DeepSeek-V3/R1, Qwen3 и экспериментальной LLaMA 4.
Среди недавних релизов с поддержкой day-0 — GLM-5.3-flash, MiniMax-M3, GLM-5.2, Kimi-K2.5 и GLM-5, а также продолжающаяся поддержка DeepSeek-V3/R1, Qwen3 и экспериментальной LLaMA 4.Which topics is it in?cpu-inference, intel, sglang, amd-gpu, rocm, cpu, mixture-of-experts, moe, llama, lora, llm-inference, high-performance
cpu-inference, intel, sglang, amd-gpu, rocm, cpu, mixture-of-experts, moe, llama, lora, llm-inference, high-performance