Что это такое?
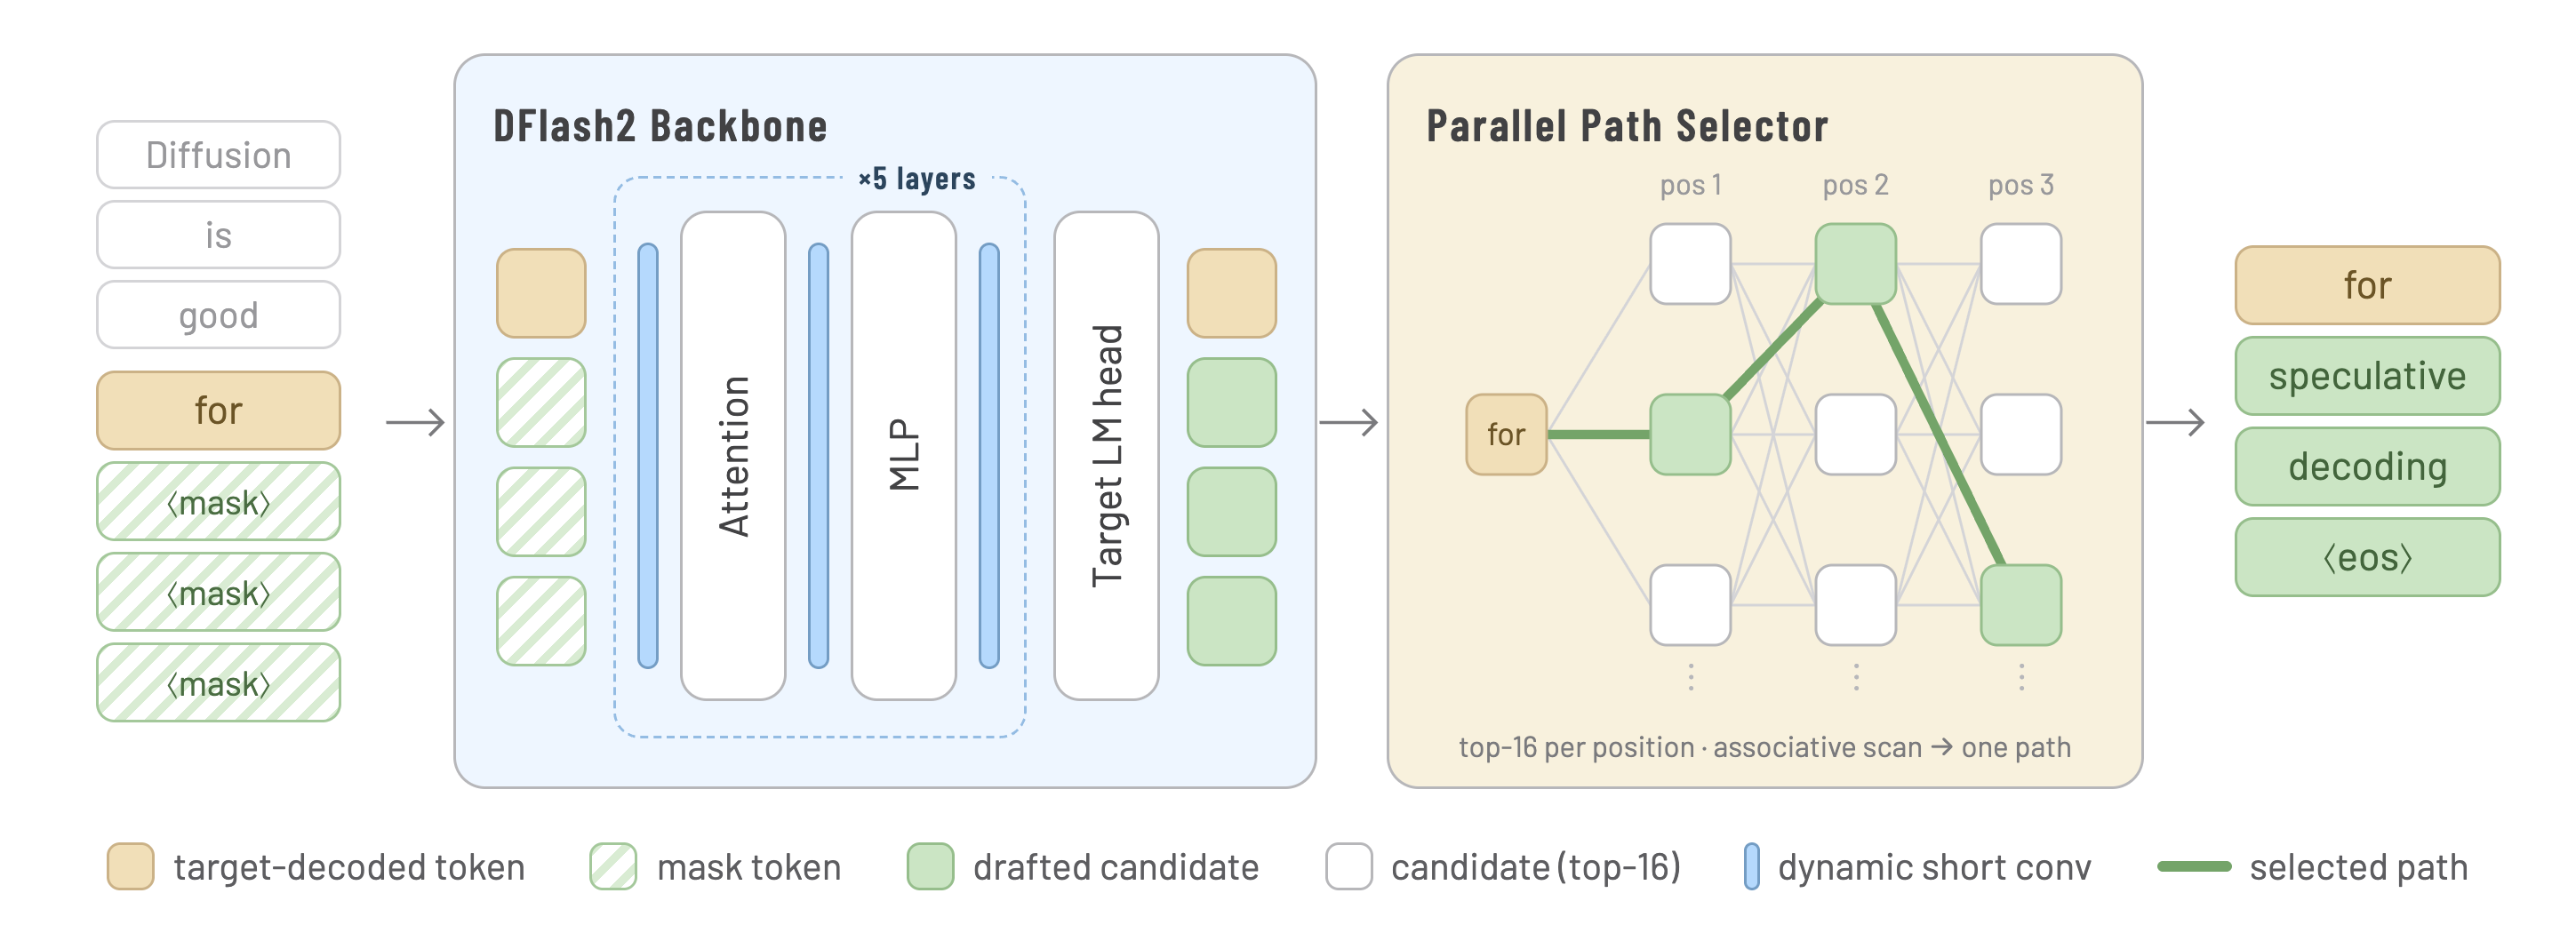
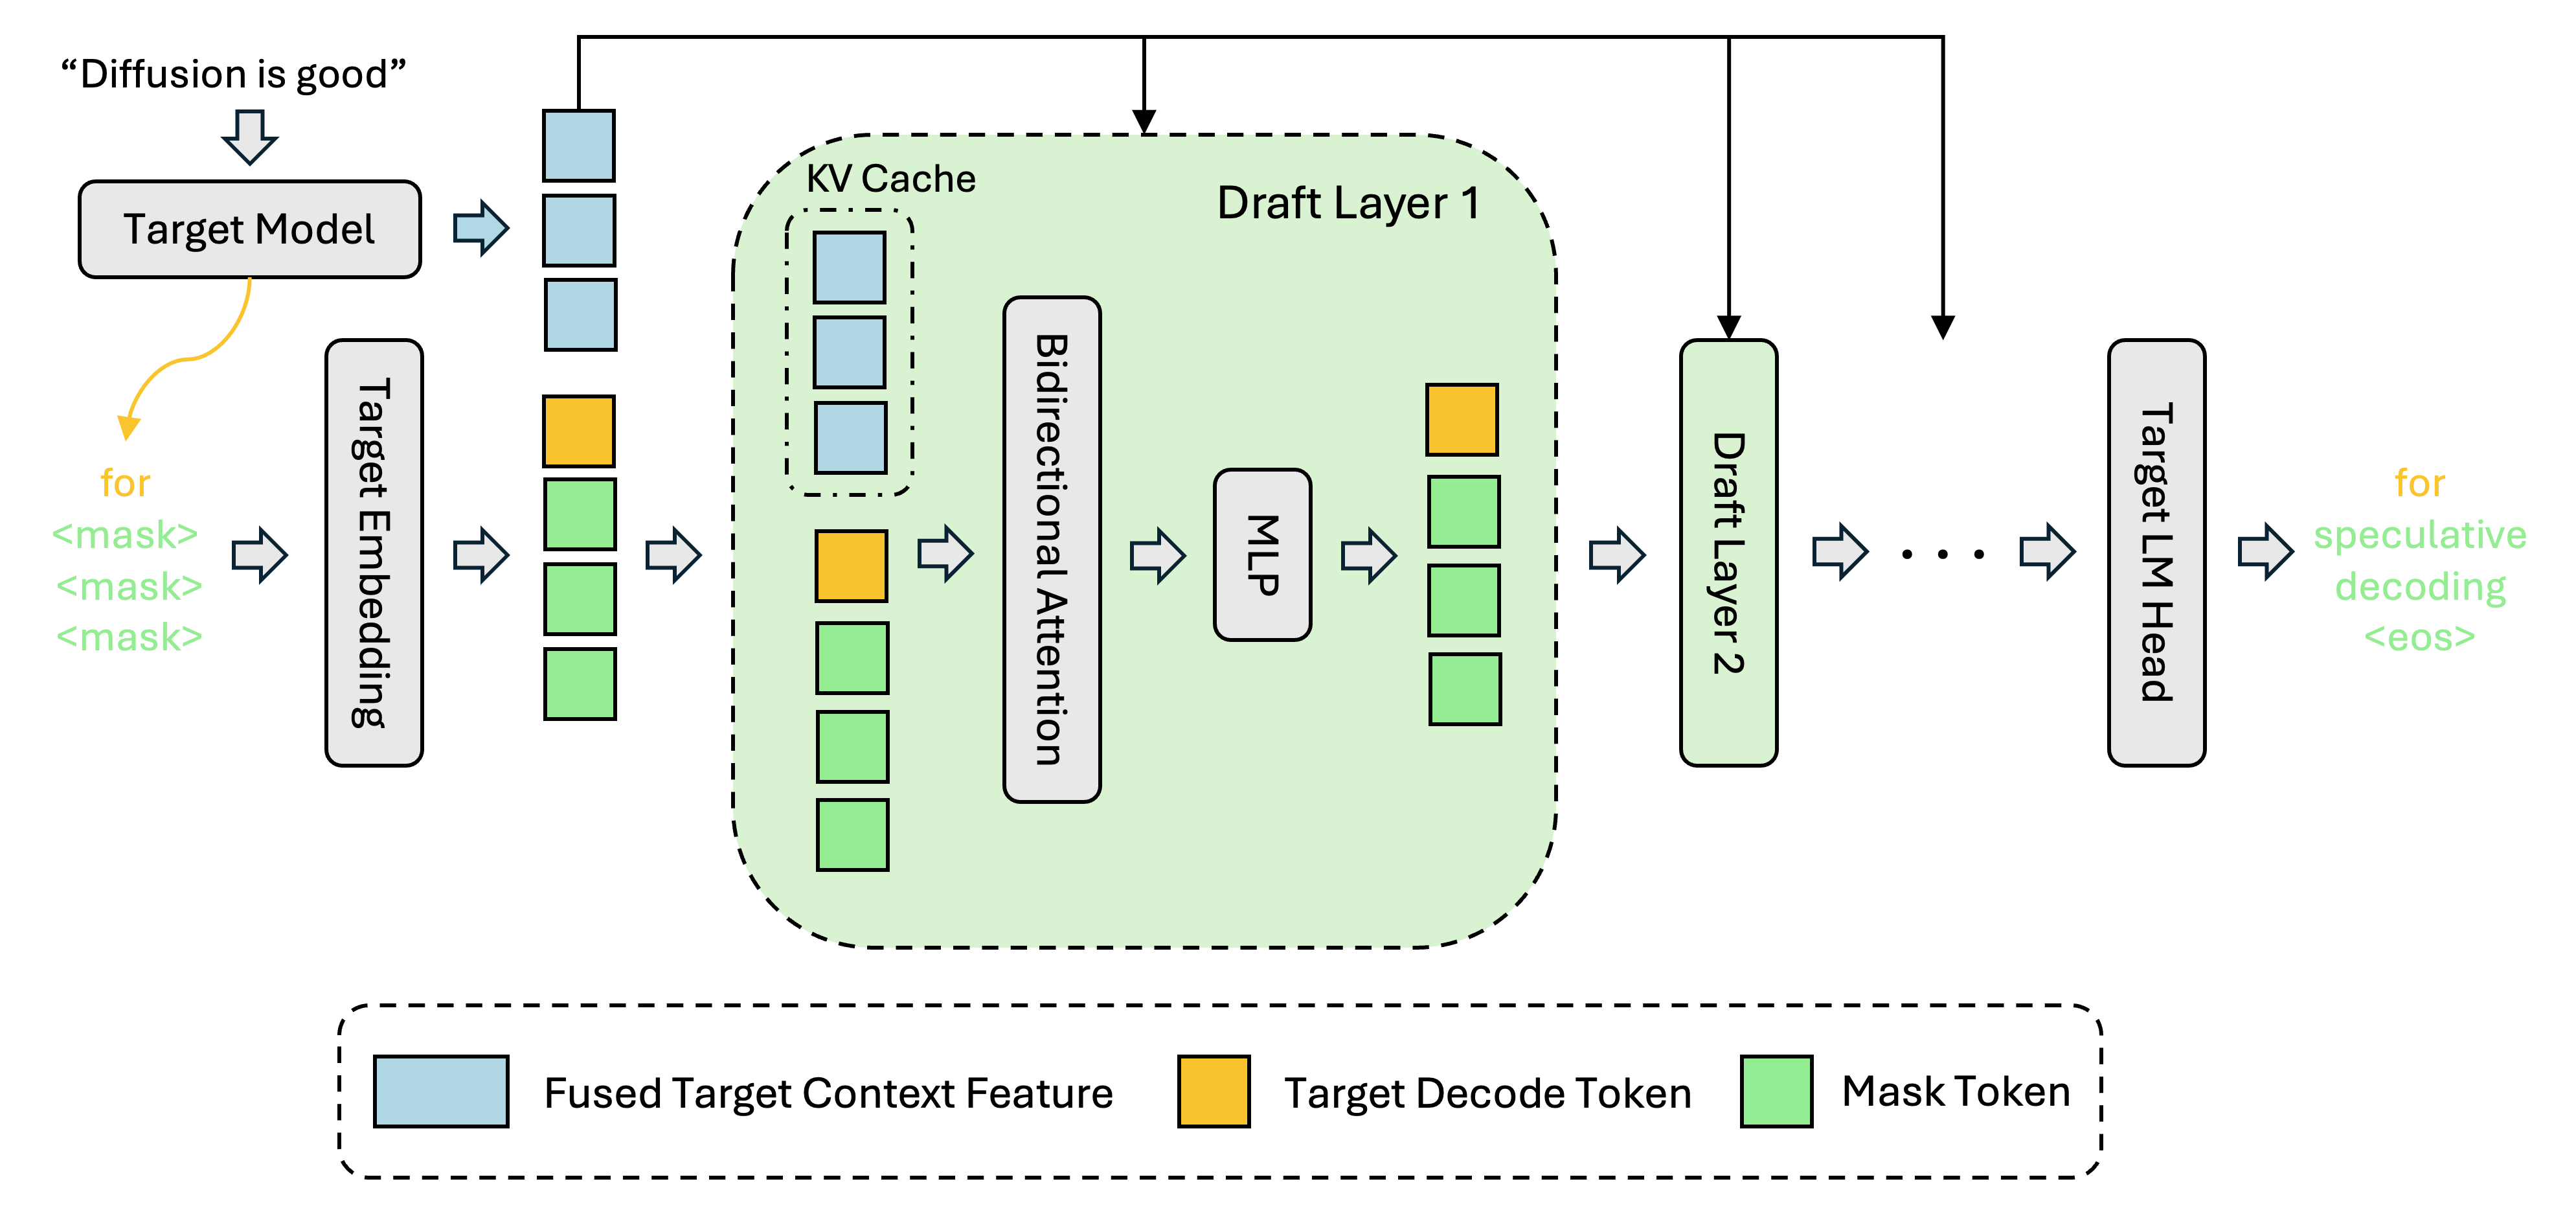
 DFlash — это легковесная модель блочной диффузии, созданная для спекулятивного декодирования. Она предлагает токены параллельными блоками, чтобы большая целевая LLM могла проверять их быстрее, чем генерируя по одному токену за раз.
DFlash — это самостоятельная модель, с которой можно общаться в чате, или она подключается к уже работающему LLM-серверу?Это вспомогательная модель, которая подключается к существующей системе развёртывания (Transformers, MLX или сервер SGLang/vLLM, совместимый с OpenAI), чтобы ускорять генерацию целевой LLM. Сама по себе она не является чат-ботом.
Это вспомогательная модель, которая подключается к существующей системе развёртывания (Transformers, MLX или сервер SGLang/vLLM, совместимый с OpenAI), чтобы ускорять генерацию целевой LLM. Сама по себе она не является чат-ботом.Как это запустить?Установите базовый пакет для работы с сервером, совместимым с OpenAI, или установите вариант с зависимостями для локального инференса: на Apple Silicon используется MLX, на Linux — Transformers. Для тестов производительности сервера отдельно установите поддерживаемую сборку SGLang, vLLM, oMLX или llama.cpp и укажите DFlash её --base-url.
Установите базовый пакет для работы с сервером, совместимым с OpenAI, или установите вариант с зависимостями для локального инференса: на Apple Silicon используется MLX, на Linux — Transformers. Для тестов производительности сервера отдельно установите поддерживаемую сборку SGLang, vLLM, oMLX или llama.cpp и укажите DFlash её --base-url.Какие модели и бэкенды DFlash реально поддерживает?Публичные чекпойнты охватывают семейства Qwen, Gemma, MiniMax, Kimi, GPT-OSS, Llama-3.1-8B, GLM и Alpamayo. Для этих семейств DFlash работает через бэкенды Transformers или MLX, а для других чекпойнтов — через любой сервер SGLang/vLLM, совместимый с OpenAI.
Публичные чекпойнты охватывают семейства Qwen, Gemma, MiniMax, Kimi, GPT-OSS, Llama-3.1-8B, GLM и Alpamayo. Для этих семейств DFlash работает через бэкенды Transformers или MLX, а для других чекпойнтов — через любой сервер SGLang/vLLM, совместимый с OpenAI.Есть ли подводные камни при работе с квантованными моделями?На MLX квантованные целевые или вспомогательные модели должны использовать размер блока 5 или меньше, потому что текущее ядро квантованного умножения матриц становится менее эффективным при больших ширинах проверки.
На MLX квантованные целевые или вспомогательные модели должны использовать размер блока 5 или меньше, потому что текущее ядро квантованного умножения матриц становится менее эффективным при больших ширинах проверки.Одинаково ли это работает на Linux и на Mac?Локальный инференс разделён по платформам: на Linux используется Transformers, а на Mac с Apple Silicon — MLX. Оба варианта поддерживаются через один и тот же путь локальной установки.
Локальный инференс разделён по платформам: на Linux используется Transformers, а на Mac с Apple Silicon — MLX. Оба варианта поддерживаются через один и тот же путь локальной установки.Как оценивается DFlash?Замеры проводятся через сервер SGLang/vLLM, совместимый с OpenAI, а также через Transformers или MLX. Все они используют одни и те же датасеты: gsm8k, math500, humaneval, mbpp и mt-bench, которые кэшируются через Hugging Face Datasets.
Замеры проводятся через сервер SGLang/vLLM, совместимый с OpenAI, а также через Transformers или MLX. Все они используют одни и те же датасеты: gsm8k, math500, humaneval, mbpp и mt-bench, которые кэшируются через Hugging Face Datasets.Что нового в DFlash 2?DFlash 2 добавляет чекпойнты Muse-Glimmer-30B и Qwen3.8-27B с настраиваемой интенсивностью рассуждений (reasoningstrength для Muse, reasoningeffort для Qwen3.8). Они работают на бэкендах Transformers и MLX.
DFlash 2 добавляет чекпойнты Muse-Glimmer-30B и Qwen3.8-27B с настраиваемой интенсивностью рассуждений (reasoningstrength для Muse, reasoningeffort для Qwen3.8). Они работают на бэкендах Transformers и MLX.Кто помог внедрить DFlash в популярные серверные движки?Команда DFlash благодарит инженеров из Modal Labs за интеграцию DFlash в SGLang и участника из NVIDIA за добавление поддержки в vLLM.
Команда DFlash благодарит инженеров из Modal Labs за интеграцию DFlash в SGLang и участника из NVIDIA за добавление поддержки в vLLM.Which topics is it in?gpt-oss, gemma, minimax, sglang, glm, kimi, mlx, speculative-decoding, model-serving, llama, transformers, vllm
gpt-oss, gemma, minimax, sglang, glm, kimi, mlx, speculative-decoding, model-serving, llama, transformers, vllm