Что это такое?
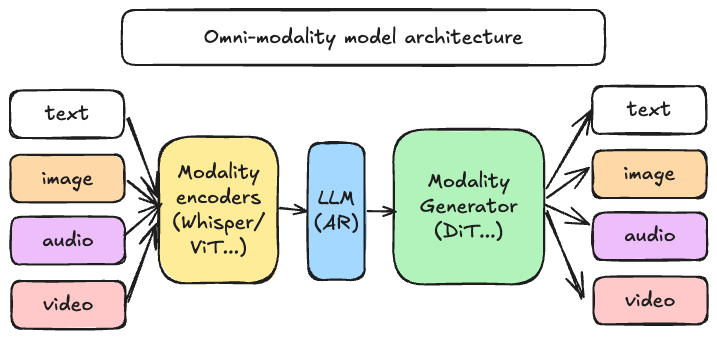
 vLLM-Omni — это фреймворк для инференса и запуска моделей в виде сервиса, который расширяет vLLM за пределы текстовых LLM и поддерживает омнимодальные модели, обрабатывающие на выходе текст, изображения, аудио, видео и действия.
Это фреймворк, который можно развернуть у себя, или облачный сервис?Это фреймворк для собственного развёртывания: вы запускаете его сами, и он открывает сервер API, совместимый с OpenAI, а не является облачным сервисом, на который нужно подписываться.
Это фреймворк для собственного развёртывания: вы запускаете его сами, и он открывает сервер API, совместимый с OpenAI, а не является облачным сервисом, на который нужно подписываться.Как его запустить?Следуйте инструкциям из документации проекта по установке (Installation) и быстрому старту (Quickstart); также для быстрого развёртывания предоставляются ночные Docker-образы с CUDA, собранные из последней ветки main.
Следуйте инструкциям из документации проекта по установке (Installation) и быстрому старту (Quickstart); также для быстрого развёртывания предоставляются ночные Docker-образы с CUDA, собранные из последней ветки main.Какое оборудование нужно, чтобы это запустить?Нужен GPU для инференса моделей; фреймворк в первую очередь ориентирован на CUDA, но также имеет широкую поддержку ROCm, XPU и NPU и внутри использует PyTorch.
Нужен GPU для инференса моделей; фреймворк в первую очередь ориентирован на CUDA, но также имеет широкую поддержку ROCm, XPU и NPU и внутри использует PyTorch.Насколько стабильны релизы?Релизы тесно привязаны к основному vLLM: начиная с версии 0.14.0 выходит стабильная сборка для каждого минорного релиза vLLM с чётным номером, поэтому нужно следить за графиком версий самого vLLM.
Релизы тесно привязаны к основному vLLM: начиная с версии 0.14.0 выходит стабильная сборка для каждого минорного релиза vLLM с чётным номером, поэтому нужно следить за графиком версий самого vLLM.Какие типы моделей оно может запускать?Поддерживаются омнимодальные модели, например Qwen3-Omni, MiniCPM-o, Cosmos3, HunyuanImage и BAGEL, а также TTS-модели (синтез речи: Qwen3-TTS, CosyVoice3), диффузионные модели для изображений и видео (LTX-2, Wan2.2) и модели-политики для роботов, управляющие действиями, такие как π0 и GR00T-N1.7.
Поддерживаются омнимодальные модели, например Qwen3-Omni, MiniCPM-o, Cosmos3, HunyuanImage и BAGEL, а также TTS-модели (синтез речи: Qwen3-TTS, CosyVoice3), диффузионные модели для изображений и видео (LTX-2, Wan2.2) и модели-политики для роботов, управляющие действиями, такие как π0 и GR00T-N1.7.Зачем нужен не просто обычный vLLM?Обычный vLLM умеет только авторегрессионную генерацию текста, а vLLM-Omni добавляет поддержку неавторегрессионных Diffusion Transformers и разнородных мультимодальных конвейеров (текст, изображения, аудио, видео, действия), сохраняя при этом эффективность KV-кэша vLLM.
Обычный vLLM умеет только авторегрессионную генерацию текста, а vLLM-Omni добавляет поддержку неавторегрессионных Diffusion Transformers и разнородных мультимодальных конвейеров (текст, изображения, аудио, видео, действия), сохраняя при этом эффективность KV-кэша vLLM.Может ли оно вести голосовые разговоры в реальном времени?Да, оно реализует полнодуплексную работу в реальном времени с потоковым входом и выходом аудио; например, это используется с серией MiniCPM-o.
Да, оно реализует полнодуплексную работу в реальном времени с потоковым входом и выходом аудио; например, это используется с серией MiniCPM-o.What are similar projects?GLM-5.3-Flash-EXL3-2x-DGX-Sparks-TensorFold, Qwen3.8-Flash-Next-Dual-DGX-Sparks, ZDTaichu5.0-9B, vllm, dgx-spark-qwen38, text-generation-inference, GLM-5.3-Flash-NVFP4-DFlash2-2x-DGX-Spark, Model-Optimizer
GLM-5.3-Flash-EXL3-2x-DGX-Sparks-TensorFold, Qwen3.8-Flash-Next-Dual-DGX-Sparks, ZDTaichu5.0-9B, vllm, dgx-spark-qwen38, text-generation-inference, GLM-5.3-Flash-NVFP4-DFlash2-2x-DGX-Spark, Model-OptimizerWhich topics is it in?world-model, world-models, diffusion, model-serving, audio-generation, robotics, llm-inference, tts, vllm, quantization, multimodal, video-generation
world-model, world-models, diffusion, model-serving, audio-generation, robotics, llm-inference, tts, vllm, quantization, multimodal, video-generation