Что это?
 Сопроводительный исследовательский репозиторий со слитными megakernel-реализациями декодирования для двух моделей на Google TPU: Kimi K3 со спекулятивным декодированием DSpark и Qwen3.8-27B со спекулятивным декодированием DFlash2; написан в дополнение к блогпосту '700 TPS on Kimi K3: A Case for TPU Megakernels'.
Это универсальная библиотека инференса или демо-бенчмарк для этих двух моделей?Это демо-код, построенный специально вокруг двух модельных пайплайнов, а не универсальная библиотека для сервинга: у каждой модели своё слитое TPU-ядро плюс интерактивный режим в терминале и HTTP-сервер, совместимый с OpenAI API.
Это демо-код, построенный специально вокруг двух модельных пайплайнов, а не универсальная библиотека для сервинга: у каждой модели своё слитое TPU-ядро плюс интерактивный режим в терминале и HTTP-сервер, совместимый с OpenAI API.Как это запустить?Разверните окружение Python/JAX из корня репозитория, убедитесь, что снапшоты моделей Hugging Face закэшированы (лаунчеры запускают HF в офлайн-режиме), затем запустите demokimidspark.py или demoqwendflash.py интерактивно либо с --serve, чтобы поднять HTTP API.
Разверните окружение Python/JAX из корня репозитория, убедитесь, что снапшоты моделей Hugging Face закэшированы (лаунчеры запускают HF в офлайн-режиме), затем запустите demokimidspark.py или demoqwendflash.py интерактивно либо с --serve, чтобы поднять HTTP API.Нужно ли настоящее TPU-железо (и кластер Slurm), чтобы это запустить?Да — Kimi K3 требует выделения Slurm из четырёх узлов с восемью TPU-устройствами на хост (всего 32), а Qwen3.8-27B — одного хоста с восемью TPU-устройствами; тесты корректности на CPU есть, но реальное исполнение на TPU они не проверяют.
Да — Kimi K3 требует выделения Slurm из четырёх узлов с восемью TPU-устройствами на хост (всего 32), а Qwen3.8-27B — одного хоста с восемью TPU-устройствами; тесты корректности на CPU есть, но реальное исполнение на TPU они не проверяют.Доказывают ли CPU-тесты, что TPU-ядра реально корректно работают на железе?Нет — набор тестов на CPU/интерпретаторе проверяет только численную корректность; он не проверяет специфичные для TPU понижение (lowering) в Mosaic, раскладки памяти, ёмкость VMEM, планирование DMA, коллективные операции и реальную производительность.
Нет — набор тестов на CPU/интерпретаторе проверяет только численную корректность; он не проверяет специфичные для TPU понижение (lowering) в Mosaic, раскладки памяти, ёмкость VMEM, планирование DMA, коллективные операции и реальную производительность.Это работает на GPU или только на Google TPU?Работает только на устройствах Google TPU; GPU GB200 фигурируют лишь как базовая линия производительности, с которой сравниваются мегаядра, а не как поддерживаемая цель исполнения.
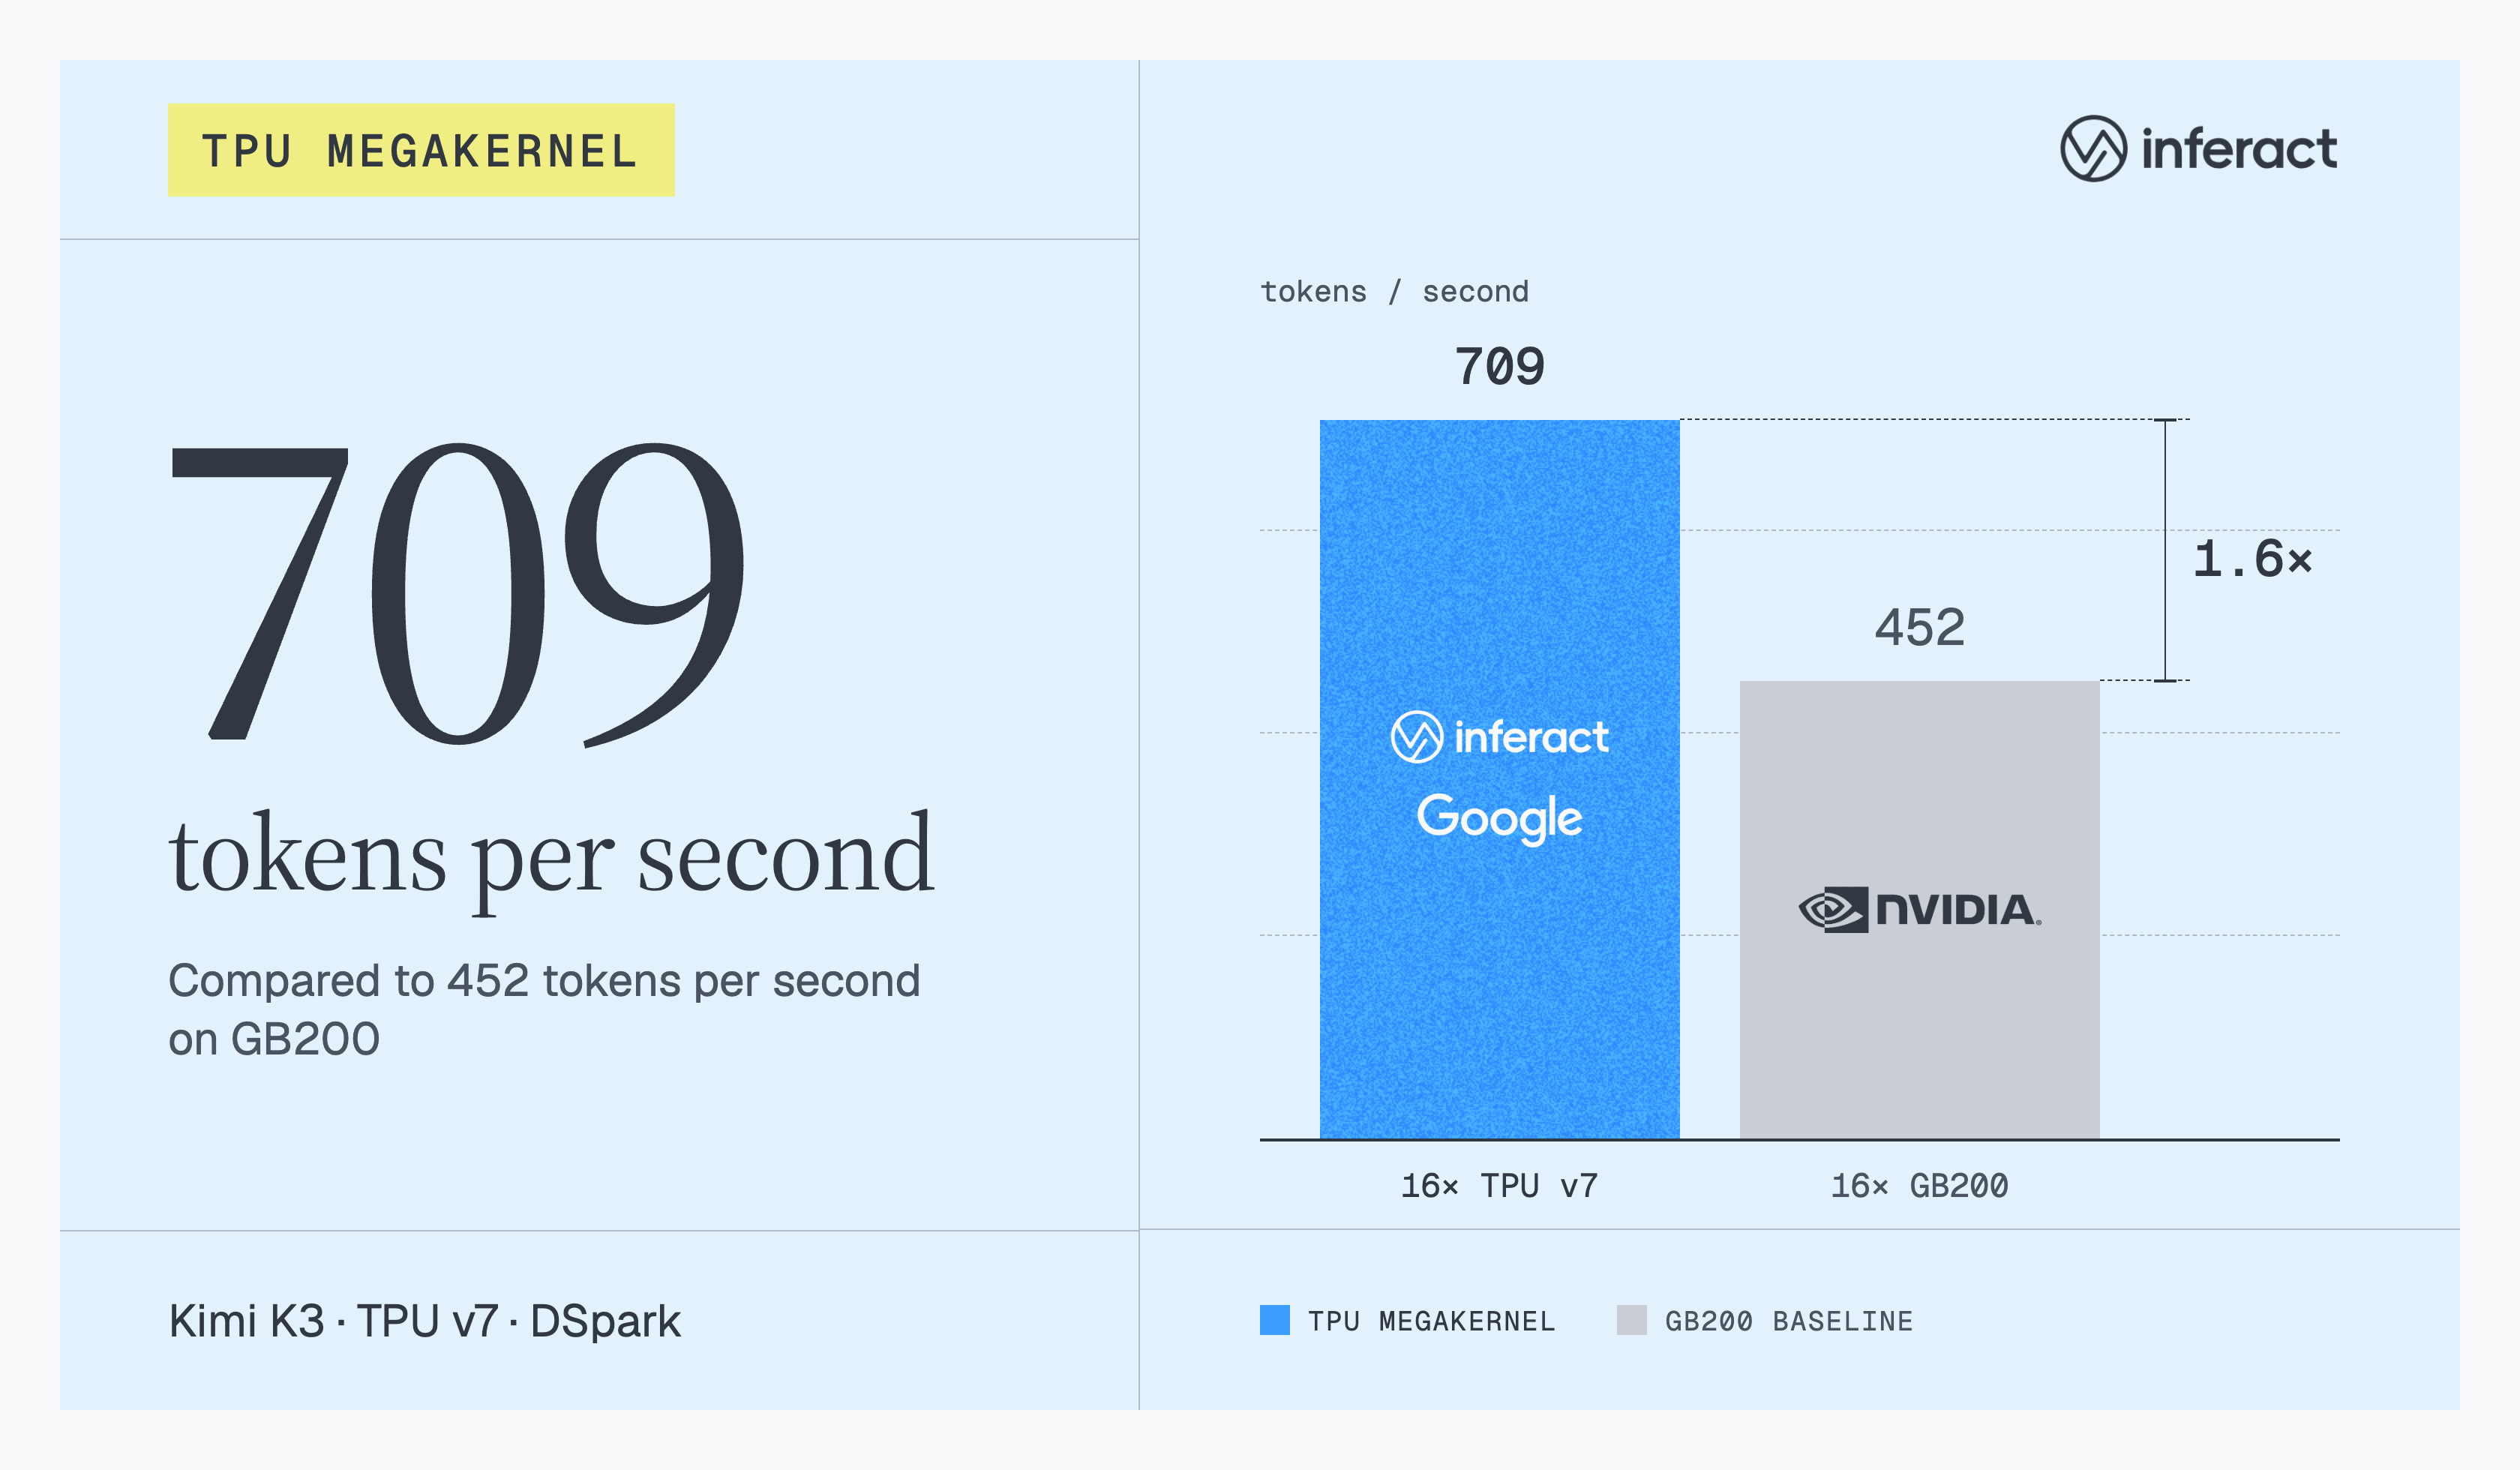
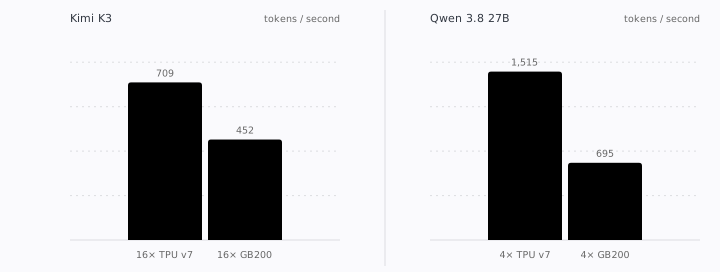
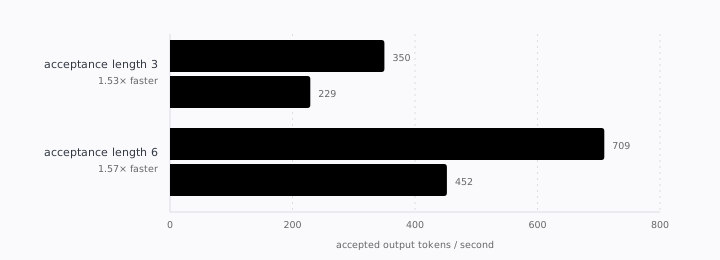
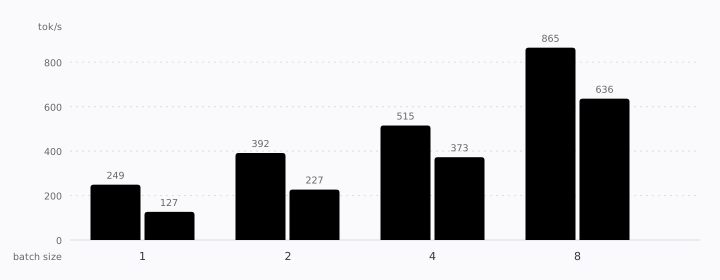
Работает только на устройствах Google TPU; GPU GB200 фигурируют лишь как базовая линия производительности, с которой сравниваются мегаядра, а не как поддерживаемая цель исполнения.Насколько эти мегаядра быстрее GPU?Со спекулятивным декодированием Kimi K3 выдаёт 709 принятых токенов/с на 16x TPU v7 против базовой линии из 16x GB200 (ускорение 1.57x), а Qwen3.8-27B — 1 515 токенов/с на 4x TPU v7 против 4x GB200 (2.18x). Без спекуляции TPU-ядра всё равно дают примерно в 1.4–2 раза большую пропускную способность декодирования, чем GB200, при размерах батча 1–8.
Со спекулятивным декодированием Kimi K3 выдаёт 709 принятых токенов/с на 16x TPU v7 против базовой линии из 16x GB200 (ускорение 1.57x), а Qwen3.8-27B — 1 515 токенов/с на 4x TPU v7 против 4x GB200 (2.18x). Без спекуляции TPU-ядра всё равно дают примерно в 1.4–2 раза большую пропускную способность декодирования, чем GB200, при размерах батча 1–8.Что такое DSpark и DFlash2?Это слитые схемы спекулятивного декодирования, идущие в комплекте с каждой моделью: DSpark сочетает Kimi K3 с одной якорной и семью черновыми строками, а DFlash2 добавляет плотному BF16-декодеру Qwen3.8-27B опциональный слитый цикл черновика и спекуляции.
Это слитые схемы спекулятивного декодирования, идущие в комплекте с каждой моделью: DSpark сочетает Kimi K3 с одной якорной и семью черновыми строками, а DFlash2 добавляет плотному BF16-декодеру Qwen3.8-27B опциональный слитый цикл черновика и спекуляции.Что предоставляет сервер, совместимый с OpenAI?Каждый сервер предоставляет GET /health, GET /v1/models, POST /tokenize, POST /detokenize, POST /v1/completions и POST /v1/chat/completions, то есть к нему можно обращаться как к стандартному эндпоинту OpenAI API.
Каждый сервер предоставляет GET /health, GET /v1/models, POST /tokenize, POST /detokenize, POST /v1/completions и POST /v1/chat/completions, то есть к нему можно обращаться как к стандартному эндпоинту OpenAI API.Зачем писать собственные TPU-мегаядра вместо стандартного фреймворка инференса?Слияние всего шага декодирования — внимания (attention), MoE, нормализации, остаточных связей и коллективных операций — в единое TPU-ядро снижает накладные расходы на диспетчеризацию каждой операции, позволяя чипам TPU v7 догонять или обгонять GPU GB200 по пропускной способности декодирования; подробности — в сопроводительном блогпосте.
Слияние всего шага декодирования — внимания (attention), MoE, нормализации, остаточных связей и коллективных операций — в единое TPU-ядро снижает накладные расходы на диспетчеризацию каждой операции, позволяя чипам TPU v7 догонять или обгонять GPU GB200 по пропускной способности декодирования; подробности — в сопроводительном блогпосте.What are similar projects?vllm, deltafin, DMI, jeeves, v100-skinny, kaggle-tpu-lab, TensorFold, sglang
vllm, deltafin, DMI, jeeves, v100-skinny, kaggle-tpu-lab, TensorFold, sglangWhich topics is it in?qwen3, jax, http-server, llm-serving, kimi, speculative-decoding, inference-engine, attention-mechanism, moe, llm-inference, high-performance, google
qwen3, jax, http-server, llm-serving, kimi, speculative-decoding, inference-engine, attention-mechanism, moe, llm-inference, high-performance, google