


25.2K ·GitHub
这是什么?
 这是一个中文的大语言模型工程深度教程合集:涵盖训练、微调、分布式训练、推理、压缩、评估、数据工程、LLMOps 和 AI 基础设施,以一份大索引的形式组织,链接到作者的系列文章,其中很多都附有配套代码。
这是可以安装的库或工具,还是别的东西?都不是——它是一份精心整理的阅读索引,不是软件。内容是中文 markdown 文章,加上每个实验对应的配套代码仓库链接;这个仓库本身没有任何需要安装或运行的东西。
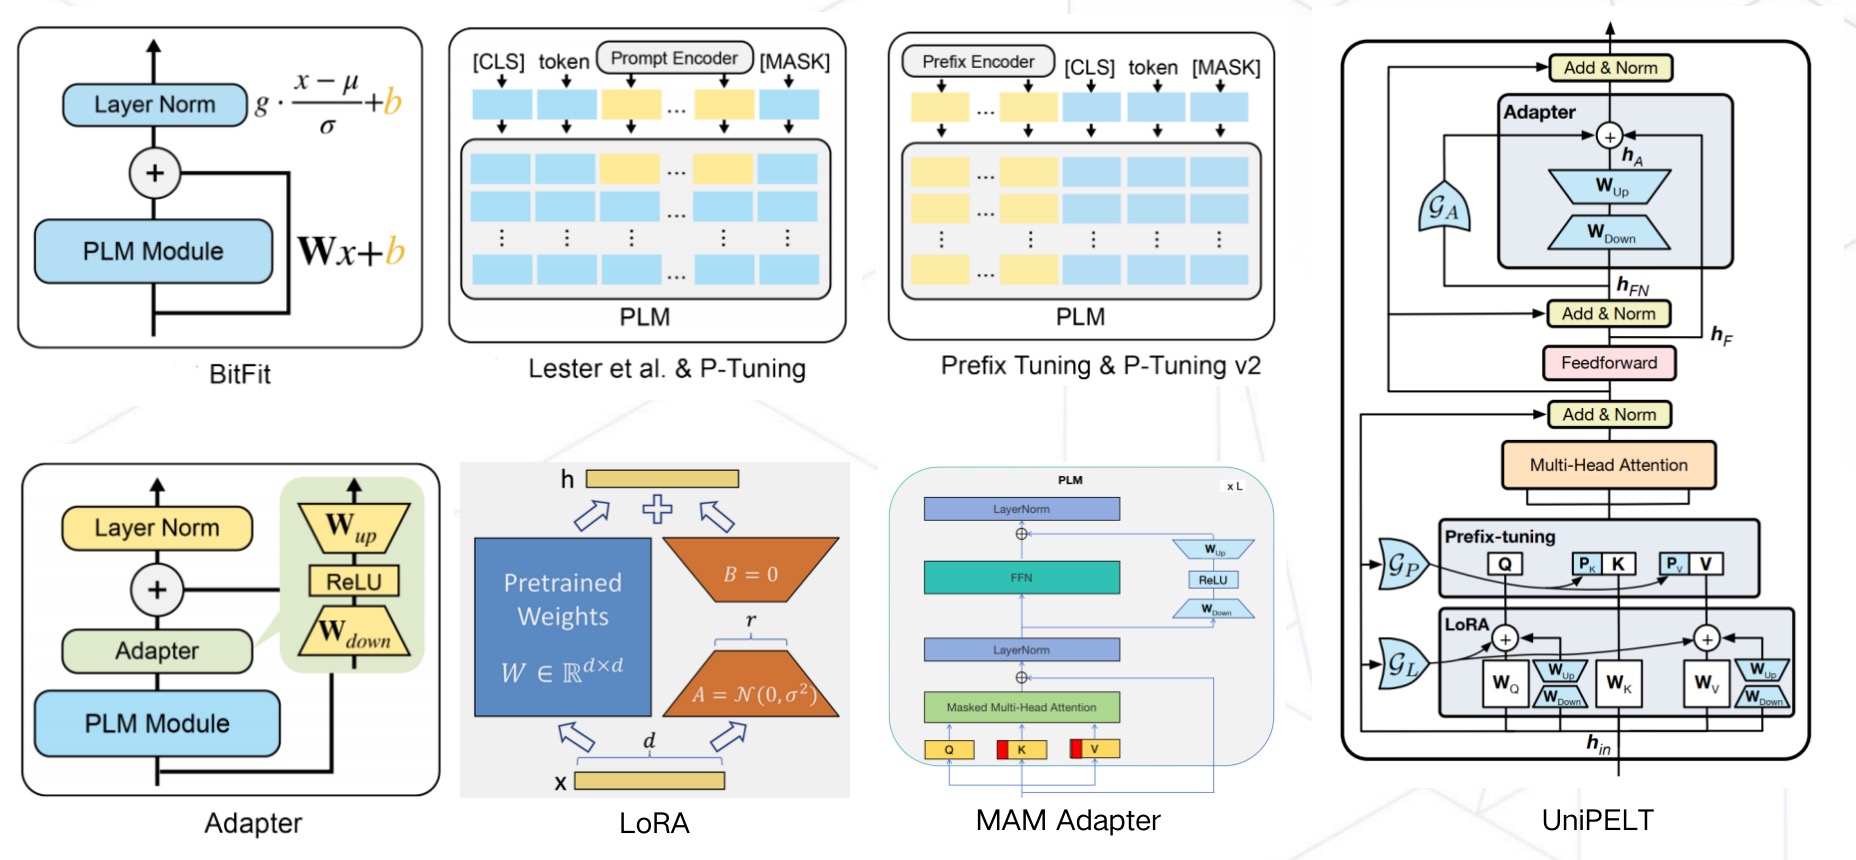
都不是——它是一份精心整理的阅读索引,不是软件。内容是中文 markdown 文章,加上每个实验对应的配套代码仓库链接;这个仓库本身没有任何需要安装或运行的东西。刚接触大模型工程的新手应该从这里哪里入手?先看 README 顶部的目录。一个自然的路线是:先看 7 篇的参数高效微调系列(BitFit、P-Tuning、LoRA、QLoRA 等),再看 9 篇的分布式训练并行系列,然后是推理和部署。
先看 README 顶部的目录。一个自然的路线是:先看 7 篇的参数高效微调系列(BitFit、P-Tuning、LoRA、QLoRA 等),再看 9 篇的分布式训练并行系列,然后是推理和部署。这些教程基于哪些框架和工具?动手微调系列基于 HuggingFace PEFT(配合 bitsandbytes 支持 INT8/FP4/NF4);训练教程使用 PyTorch、Megatron-LM 和 DeepSpeed;推理方面涵盖 vLLM、SGLang、TensorRT-LLM 和 Triton 服务框架。
动手微调系列基于 HuggingFace PEFT(配合 bitsandbytes 支持 INT8/FP4/NF4);训练教程使用 PyTorch、Megatron-LM 和 DeepSpeed;推理方面涵盖 vLLM、SGLang、TensorRT-LLM 和 Triton 服务框架。这个合集是完整的,还在陆续补充中?它是一个持续更新的文档,还在不断扩充:分布式训练的网络通信部分明确标注了'待更新',所以目录里承诺的内容并不是每一项都已经写好。
它是一个持续更新的文档,还在不断扩充:分布式训练的网络通信部分明确标注了'待更新',所以目录里承诺的内容并不是每一项都已经写好。它是面向研究人员的,还是普通开发者也能受益?两者都适合。作者提到,参数高效微调的存在正是为了让普通研究者和开发者也能微调大模型,所以新手可以从 PEFT 入手,而分布式训练和部署部分的内容则适合进阶读者。
两者都适合。作者提到,参数高效微调的存在正是为了让普通研究者和开发者也能微调大模型,所以新手可以从 PEFT 入手,而分布式训练和部署部分的内容则适合进阶读者。跟着学需要很强的 GPU 配置吗?只有动手实践的部分需要,而且不一定非要集群:LLaMA-65B 的 QLoRA 微调 48GB 显存就够,GaLore 甚至能在单张 RTX 4090 上预训练 LLaMA-7B;分布式训练系列则面向多卡和多机的环境。
只有动手实践的部分需要,而且不一定非要集群:LLaMA-65B 的 QLoRA 微调 48GB 显存就够,GaLore 甚至能在单张 RTX 4090 上预训练 LLaMA-7B;分布式训练系列则面向多卡和多机的环境。在生产环境部署方面,它介绍了哪些推理引擎?它把 vLLM 和 SGLang 视为生产级推理引擎,还介绍了 LMDeploy、LightLLM、MNN-LLM 以及端侧多模态引擎 mllm,另有手把手的 TensorRT-LLM 教程和 Triton 服务框架的三篇系列指南。
它把 vLLM 和 SGLang 视为生产级推理引擎,还介绍了 LMDeploy、LightLLM、MNN-LLM 以及端侧多模态引擎 mllm,另有手把手的 TensorRT-LLM 教程和 Triton 服务框架的三篇系列指南。有没有讲解推理引擎内部原理的学习材料?有——它链接了 Nano-vLLM(一个带注释的轻量级 vLLM 复现)和 Mini-SGLang(一个精简的 SGLang 实现),两者都被认为非常适合阅读源码学习。
有——它链接了 Nano-vLLM(一个带注释的轻量级 vLLM 复现)和 Mini-SGLang(一个精简的 SGLang 实现),两者都被认为非常适合阅读源码学习。它对准备大模型岗位的面试有帮助吗?有——专门设有一个大模型面试题板块,此外还有服务器环境配置指南和一个用于交流大模型工程的微信学习群。
有——专门设有一个大模型面试题板块,此外还有服务器环境配置指南和一个用于交流大模型工程的微信学习群。它涵盖在国产 AI 硬件上运行大模型的内容吗?涵盖——索引中包含大模型适配国产硬件、AI 加速卡、AI 编译器、AI 基础设施和 AI 集群网络等板块。
涵盖——索引中包含大模型适配国产硬件、AI 加速卡、AI 编译器、AI 基础设施和 AI 集群网络等板块。Which topics is it in?peft, ai-infrastructure, knowledge-distillation, llm-training, rlhf, llm-serving, llmops, llm-evaluation, data-engineering, lora, llm-inference, vllm
peft, ai-infrastructure, knowledge-distillation, llm-training, rlhf, llm-serving, llmops, llm-evaluation, data-engineering, lora, llm-inference, vllm