


25.2K ·GitHub
Что это такое?
 Это китайскоязычный центр подробных руководств по инженерии больших языковых моделей: обучение, дообучение, распределённое обучение, инференс, сжатие, оценка качества, работа с данными, LLMOps и ИИ-инфраструктура. Всё организовано как большой указатель со ссылками на серии статей автора, часто вместе с сопутствующим кодом.
Это библиотека или инструмент, который можно установить, или что-то другое?Ни то, ни другое — это подобранный указатель для чтения, а не программа. Содержимое — китайские статьи в формате markdown плюс ссылки на репозитории с кодом для каждого эксперимента; в самом репозитории нет ничего, что нужно устанавливать или запускать.
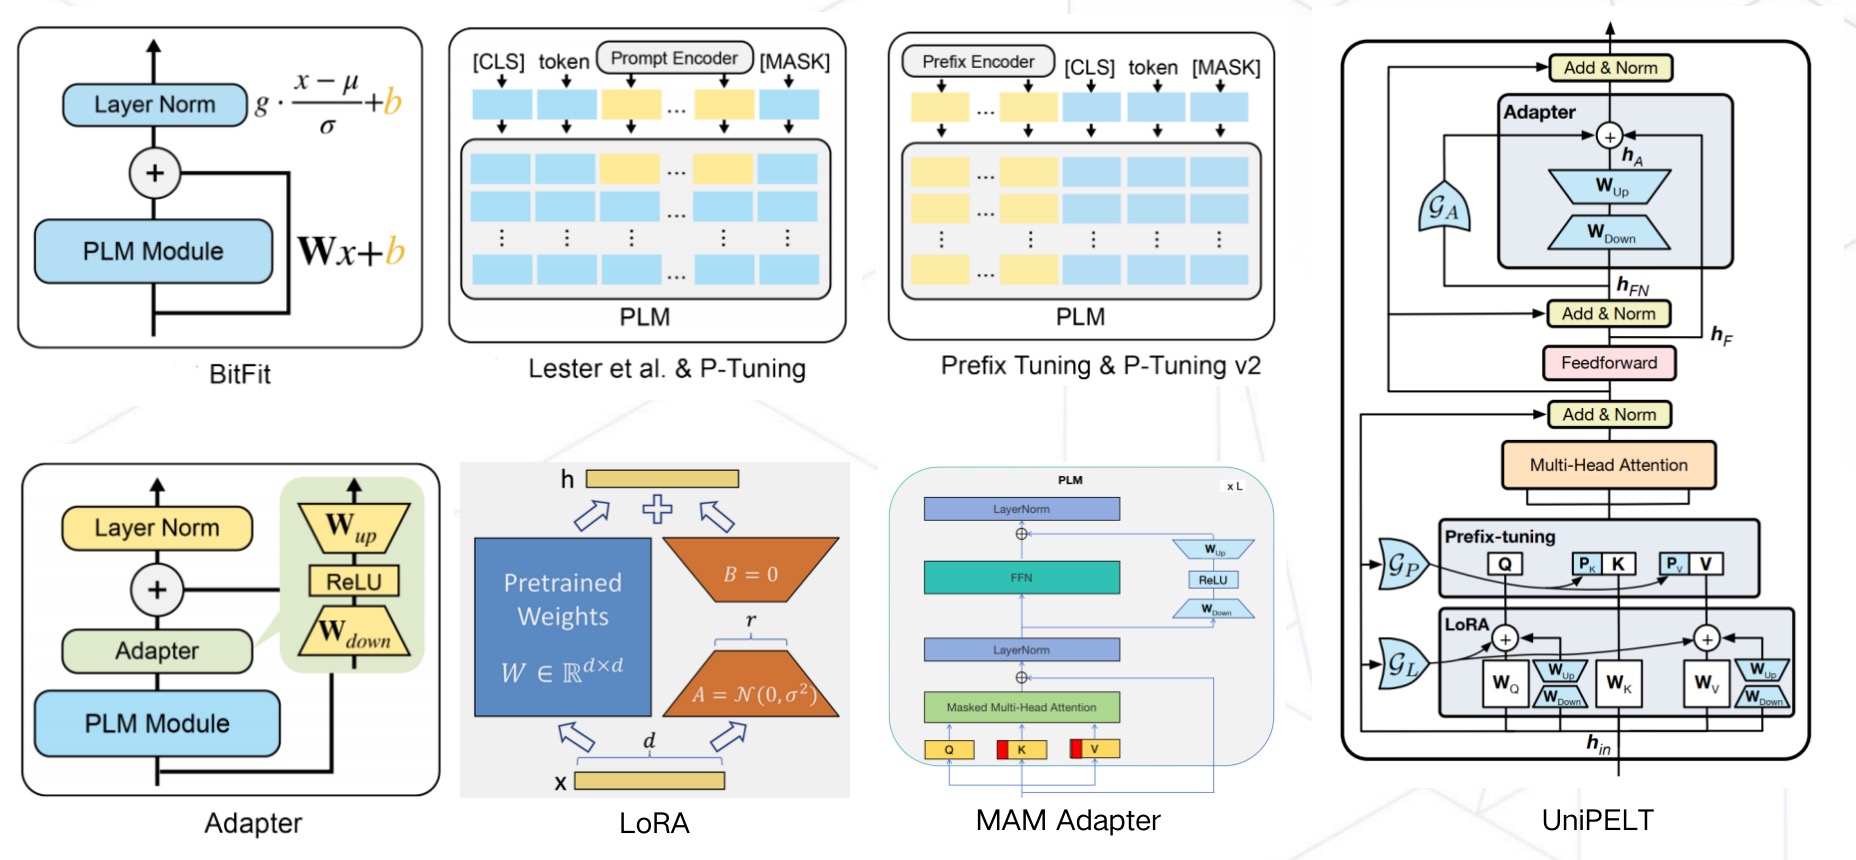
Ни то, ни другое — это подобранный указатель для чтения, а не программа. Содержимое — китайские статьи в формате markdown плюс ссылки на репозитории с кодом для каждого эксперимента; в самом репозитории нет ничего, что нужно устанавливать или запускать.С чего новичку в инженерии LLM стоит начать здесь?Начните с оглавления в начале README. Естественный путь — серия из 7 статей о параметр-эффективном дообучении (BitFit, P-Tuning, LoRA, QLoRA и другие), затем серия из 9 статей о параллелизме при распределённом обучении, а дальше — инференс и развёртывание моделей.
Начните с оглавления в начале README. Естественный путь — серия из 7 статей о параметр-эффективном дообучении (BitFit, P-Tuning, LoRA, QLoRA и другие), затем серия из 9 статей о параллелизме при распределённом обучении, а дальше — инференс и развёртывание моделей.На каких фреймворках и инструментах строятся эти руководства?Практическая серия по дообучению построена на HuggingFace PEFT (плюс bitsandbytes для INT8/FP4/NF4); руководства по обучению используют PyTorch, Megatron-LM и DeepSpeed; в части инференса рассматриваются vLLM, SGLang, TensorRT-LLM и серверный фреймворк Triton.
Практическая серия по дообучению построена на HuggingFace PEFT (плюс bitsandbytes для INT8/FP4/NF4); руководства по обучению используют PyTorch, Megatron-LM и DeepSpeed; в части инференса рассматриваются vLLM, SGLang, TensorRT-LLM и серверный фреймворк Triton.Подборка полная или всё ещё дополняется?Это живой документ, который продолжает расти: раздел о сетевом взаимодействии при распределённом обучении прямо помечен как «подлежит обновлению» (待更新), так что заполнены ещё не все пункты, обещанные в оглавлении.
Это живой документ, который продолжает расти: раздел о сетевом взаимодействии при распределённом обучении прямо помечен как «подлежит обновлению» (待更新), так что заполнены ещё не все пункты, обещанные в оглавлении.Это для исследователей или обычному разработчику тоже будет полезно?И тем, и другим. Автор отмечает, что параметр-эффективное дообучение существует именно для того, чтобы обычные исследователи и разработчики могли дообучать большие модели, поэтому новичкам стоит начать с PEFT, а материалы по распределённому обучению и развёртыванию рассчитаны на опытных специалистов.
И тем, и другим. Автор отмечает, что параметр-эффективное дообучение существует именно для того, чтобы обычные исследователи и разработчики могли дообучать большие модели, поэтому новичкам стоит начать с PEFT, а материалы по распределённому обучению и развёртыванию рассчитаны на опытных специалистов.Мне нужен мощный GPU, чтобы повторять примеры?Только для практической части, и кластер нужен не всегда: дообучение LLaMA-65B методом QLoRA умещается в 48 ГБ видеопамяти, а GaLore может обучать LLaMA-7B с нуля на одной RTX 4090. Серия о распределённом обучении рассчитана на конфигурации с несколькими GPU и несколькими узлами.
Только для практической части, и кластер нужен не всегда: дообучение LLaMA-65B методом QLoRA умещается в 48 ГБ видеопамяти, а GaLore может обучать LLaMA-7B с нуля на одной RTX 4090. Серия о распределённом обучении рассчитана на конфигурации с несколькими GPU и несколькими узлами.Какие движки инференса для боевого развёртывания здесь рассматриваются?vLLM и SGLang описаны как движки продакшн-уровня; также рассматриваются LMDeploy, LightLLM, MNN-LLM и мультимодальный движок для устройств mllm, плюс пошаговые руководства по TensorRT-LLM и серия из трёх частей о серверном фреймворке Triton.
vLLM и SGLang описаны как движки продакшн-уровня; также рассматриваются LMDeploy, LightLLM, MNN-LLM и мультимодальный движок для устройств mllm, плюс пошаговые руководства по TensorRT-LLM и серия из трёх частей о серверном фреймворке Triton.Есть ли материалы о том, как движки инференса устроены внутри?Да — там есть ссылки на Nano-vLLM, аннотированную облегчённую реализацию vLLM, и на Mini-SGLang, компактную реализацию SGLang; оба проекта описаны как очень подходящие для изучения исходного кода.
Да — там есть ссылки на Nano-vLLM, аннотированную облегчённую реализацию vLLM, и на Mini-SGLang, компактную реализацию SGLang; оба проекта описаны как очень подходящие для изучения исходного кода.Поможет ли это подготовиться к собеседованиям по LLM?Да — там есть отдельный раздел с вопросами для собеседований по LLM, а также руководство по настройке серверного окружения и группа в WeChat для обсуждения инженерии LLM.
Да — там есть отдельный раздел с вопросами для собеседований по LLM, а также руководство по настройке серверного окружения и группа в WeChat для обсуждения инженерии LLM.Рассматривается ли запуск LLM на китайском ИИ-оборудовании?Да — в указатель входят разделы об адаптации LLM к отечественному (китайскому) оборудованию, ИИ-ускорителях, ИИ-компиляторах, ИИ-инфраструктуре и сетях ИИ-кластеров.
Да — в указатель входят разделы об адаптации LLM к отечественному (китайскому) оборудованию, ИИ-ускорителях, ИИ-компиляторах, ИИ-инфраструктуре и сетях ИИ-кластеров.Which topics is it in?peft, ai-infrastructure, knowledge-distillation, llm-training, rlhf, llm-serving, llmops, llm-evaluation, data-engineering, lora, llm-inference, vllm
peft, ai-infrastructure, knowledge-distillation, llm-training, rlhf, llm-serving, llmops, llm-evaluation, data-engineering, lora, llm-inference, vllm