
312 ·GitHub
Что это такое?
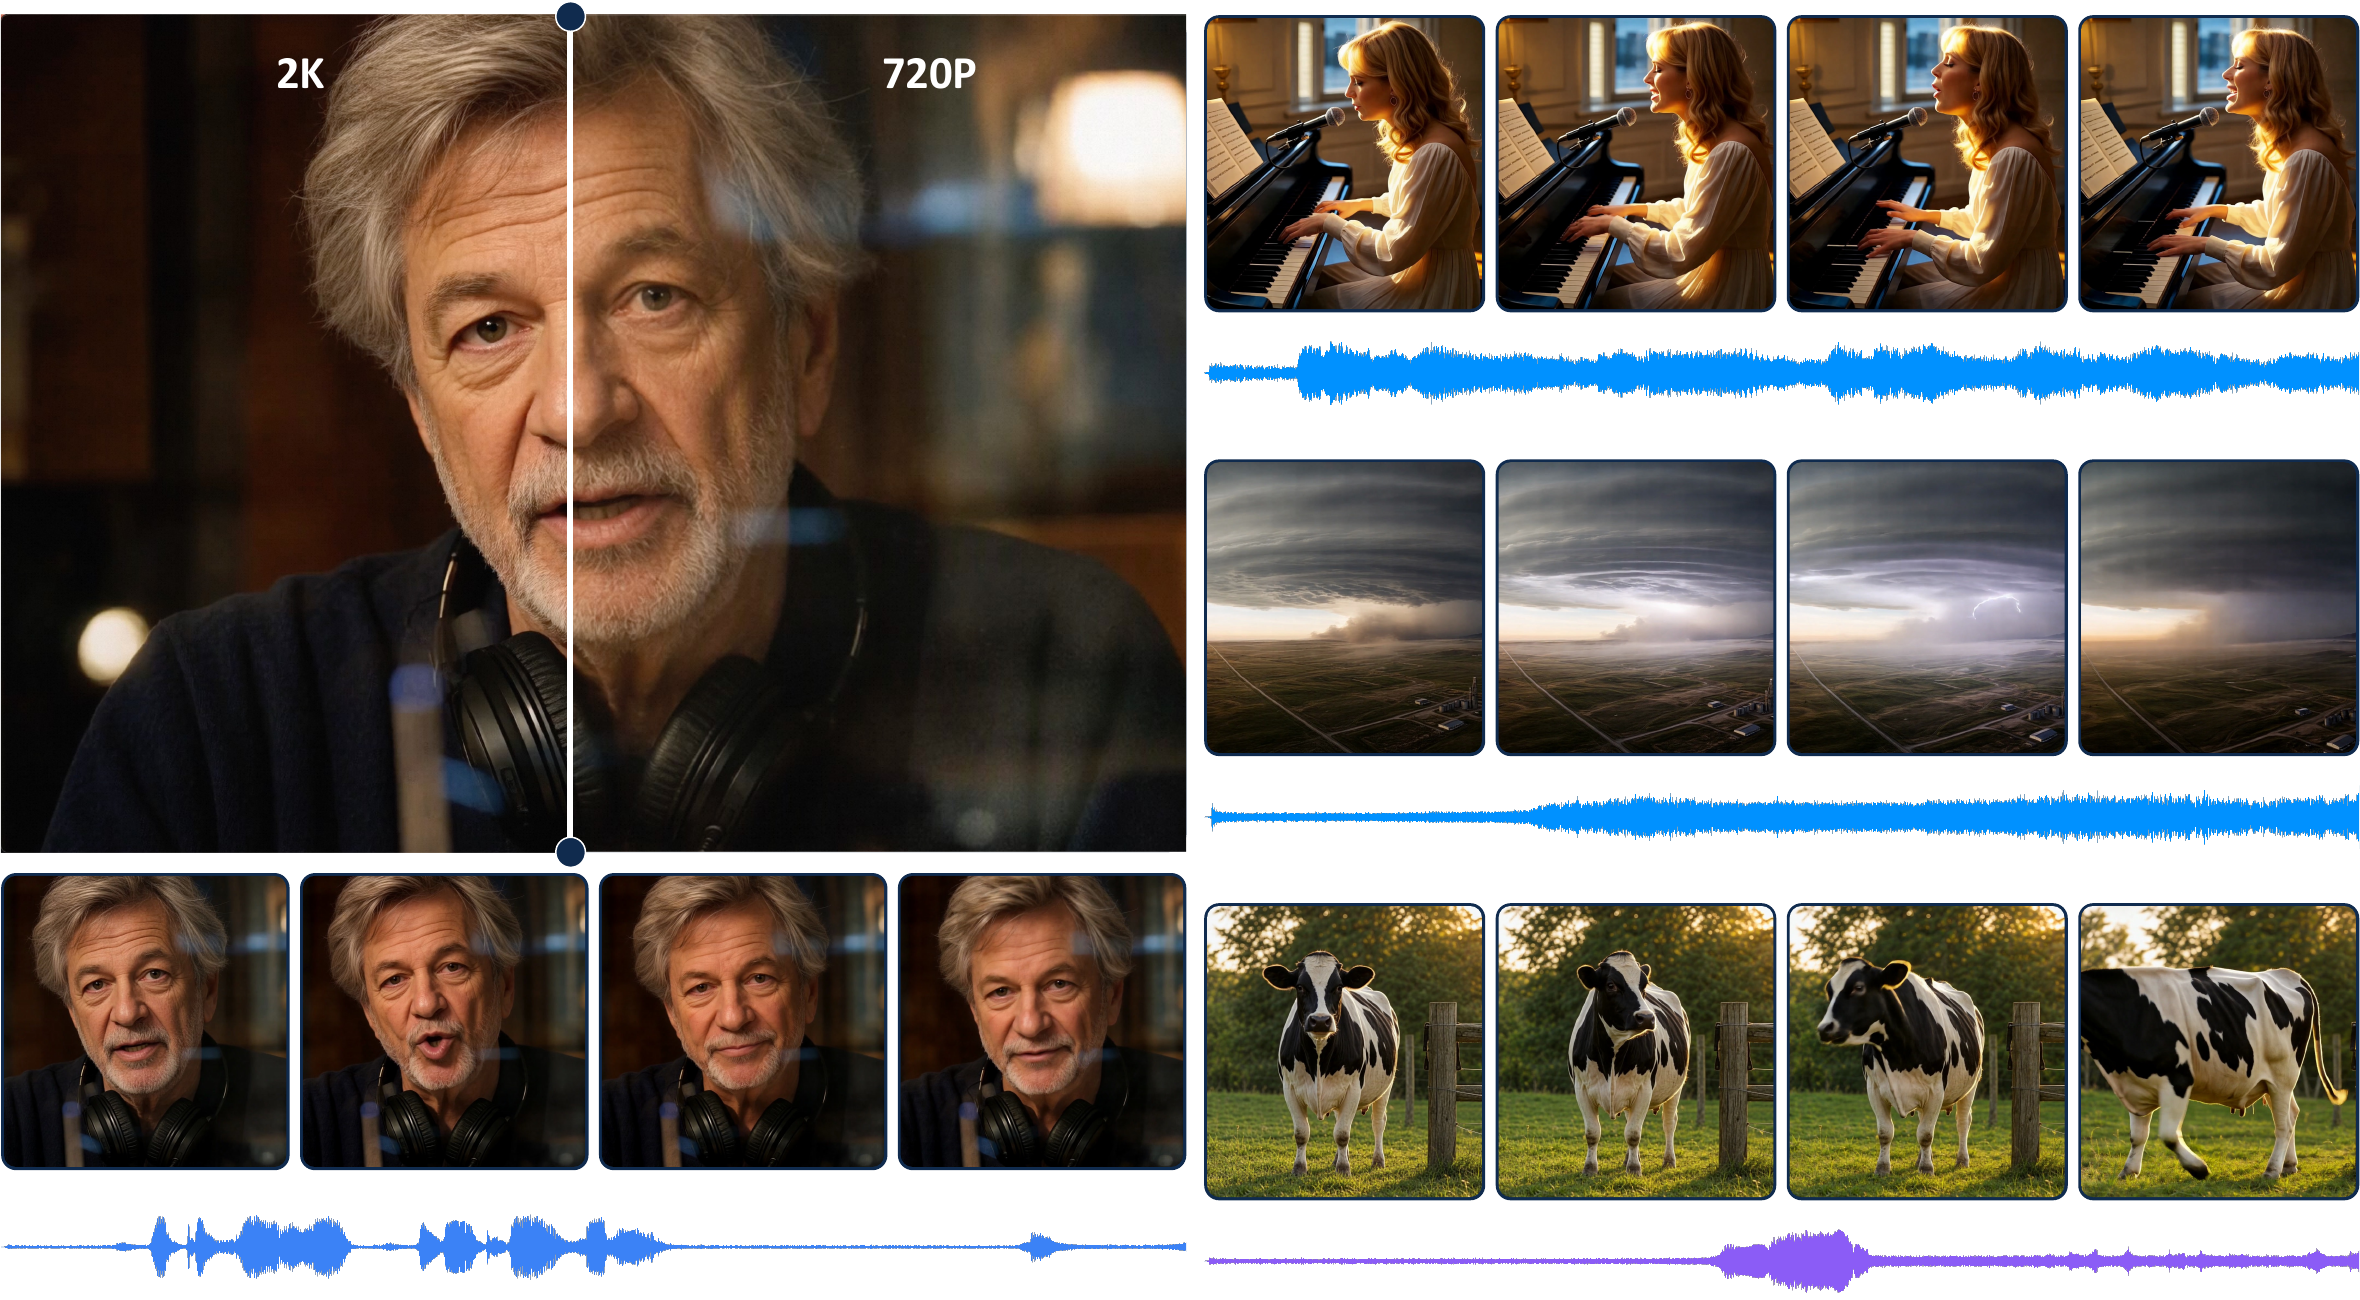
 DreamX-Creator — это опенсорсная исследовательская платформа для нативной совместной генерации аудио и видео: она создаёт видео и синхронизированную звуковую дорожку одновременно, доводя результат до разрешения 2K.
Что нужно на входе и что получится на выходе?Вы даёте первый кадр и текстовый запрос; генератор на 7B возвращает видео со звуковой дорожкой, соответствующей картинке, а рефайнер SR-DiT 5B затем повышает качество результата до 2K.
Вы даёте первый кадр и текстовый запрос; генератор на 7B возвращает видео со звуковой дорожкой, соответствующей картинке, а рефайнер SR-DiT 5B затем повышает качество результата до 2K.Как его запустить?Каждый компонент (audiovideogeneration/, videorefiner/) — это самостоятельная папка со своим requirements.txt и README: установите окружение, скачайте веса в checkpoints/, затем запустите скрипты инференса.
Каждый компонент (audiovideogeneration/, videorefiner/) — это самостоятельная папка со своим requirements.txt и README: установите окружение, скачайте веса в checkpoints/, затем запустите скрипты инференса.Какие веса моделей мне нужны и где их взять?С HuggingFace или ModelScope: генератор аудио и видео DreamX 7B, рефайнер SR-DiT 5B и Wan-AI/Wan2.2-TI2V-5B — всё кладётся в checkpoints/, как описано в его README.
С HuggingFace или ModelScope: генератор аудио и видео DreamX 7B, рефайнер SR-DiT 5B и Wan-AI/Wan2.2-TI2V-5B — всё кладётся в checkpoints/, как описано в его README.Всё ли из технического отчёта реально доступно?Только инференс: опубликованные веса и код покрывают генератор 7B и одношаговый рефайнер 2K, а дистиллированные, более быстрые модели с меньшим числом шагов сэмплирования пока остаются пунктами дорожной карты без гарантии.
Только инференс: опубликованные веса и код покрывают генератор 7B и одношаговый рефайнер 2K, а дистиллированные, более быстрые модели с меньшим числом шагов сэмплирования пока остаются пунктами дорожной карты без гарантии.Можно ли пользоваться свободно, в том числе в коммерческих целях?Да — Apache 2.0 разрешает использовать, изменять и распространять проект, в том числе в коммерческих продуктах, при условии сохранения лицензии.
Да — Apache 2.0 разрешает использовать, изменять и распространять проект, в том числе в коммерческих продуктах, при условии сохранения лицензии.Он запустится на обычном компьютере или нужна серьёзная видеокарта?Генератор 7B рассчитан на работу на одной видеокарте, есть опции CPU-offload и настройки потребления памяти для слабых конфигураций, а также опциональный многопоточный (multi-GPU) инференс с sequence parallel для ускорения.
Генератор 7B рассчитан на работу на одной видеокарте, есть опции CPU-offload и настройки потребления памяти для слабых конфигураций, а также опциональный многопоточный (multi-GPU) инференс с sequence parallel для ускорения.Как достигается синхронизация звука и видео?Генератор использует Gated Cross-Modal Attention с прогрессивным совместным обучением для двунаправленного взаимодействия аудио и видео, а общий пайплайн добавляет обучение с подкреплением для аудио и видео с обратной связью, учитывающей модальности, — это улучшает синхронизацию, согласованность и качество.
Генератор использует Gated Cross-Modal Attention с прогрессивным совместным обучением для двунаправленного взаимодействия аудио и видео, а общий пайплайн добавляет обучение с подкреплением для аудио и видео с обратной связью, учитывающей модальности, — это улучшает синхронизацию, согласованность и качество.Зачем нужен первый кадр, а не просто текстовый запрос?Опубликованный базовый генератор работает с условием по изображению: первый кадр задаёт сцену, а запрос управляет движением и звуком. В README режим работы только по текстовому запросу не упоминается.
Опубликованный базовый генератор работает с условием по изображению: первый кадр задаёт сцену, а запрос управляет движением и звуком. В README режим работы только по текстовому запросу не упоминается.Он построен на других опенсорсных наработках?Да — авторы благодарят команды Wan, OpenMOSS и VideoX-Fun и используют веса Wan2.2-TI2V-5B; есть и технический отчёт, который можно процитировать, если платформа пригодится в вашем исследовании.
Да — авторы благодарят команды Wan, OpenMOSS и VideoX-Fun и используют веса Wan2.2-TI2V-5B; есть и технический отчёт, который можно процитировать, если платформа пригодится в вашем исследовании.What are similar projects?LTX-Video, hyperflow, DiffSynth-Studio, LTX-2, diffusers, Open-Sora, MiniMax-H3, CogVideo
LTX-Video, hyperflow, DiffSynth-Studio, LTX-2, diffusers, Open-Sora, MiniMax-H3, CogVideoWhich topics is it in?wan, super-resolution, diffusion, image-to-video, audio-generation, attention-mechanism, text-to-video, reinforcement-learning, multimodal, video-generation, audio, video
wan, super-resolution, diffusion, image-to-video, audio-generation, attention-mechanism, text-to-video, reinforcement-learning, multimodal, video-generation, audio, video