

Что это такое?
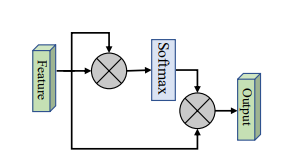
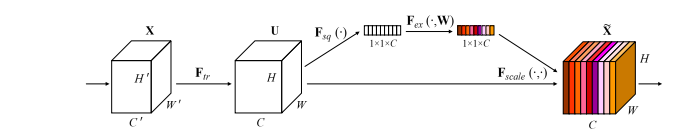
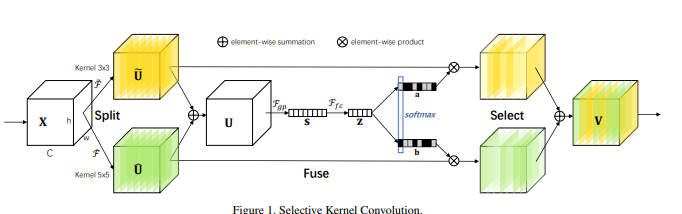
 Коллекция реализаций на PyTorch модулей Attention, Backbone, MLP, Re-parameter и Convolution из научных статей, которая помогает разобраться в статьях, глядя на механизмы, написанные в коде.
Это библиотека, которую я импортирую, или просто справочный код?И то, и другое: её можно установить как пакет через pip (fightingcv-attention), а также использовать как репозиторий отдельных модулей, которые можно скопировать в свой код модели.
И то, и другое: её можно установить как пакет через pip (fightingcv-attention), а также использовать как репозиторий отдельных модулей, которые можно скопировать в свой код модели.Как начать использовать из неё модуль?Установите через pip или клонируйте репозиторий, затем импортируйте нужный класс attention/backbone/MLP (например, External Attention, CBAM, SE) и вызывайте его как любой nn.Module.
Установите через pip или клонируйте репозиторий, затем импортируйте нужный класс attention/backbone/MLP (например, External Attention, CBAM, SE) и вызывайте его как любой nn.Module.Нужен ли мне PyTorch, чтобы это использовать?Да, каждый модуль реализован как nn.Module из PyTorch, поэтому в вашем окружении должен быть установлен PyTorch.
Да, каждый модуль реализован как nn.Module из PyTorch, поэтому в вашем окружении должен быть установлен PyTorch.Все ли модули одинаково готовы к продакшену?Прямо об этом не сказано, но репозиторий организован исключительно как перереализации статей для обучения и справки, а не как набор обученных моделей или бенчмарков: ни предобученные веса, ни скрипты обучения не упоминаются.
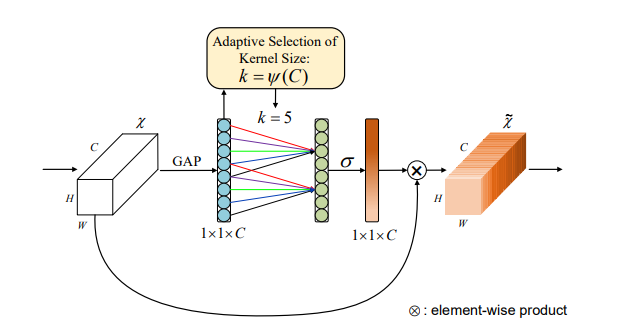
Прямо об этом не сказано, но репозиторий организован исключительно как перереализации статей для обучения и справки, а не как набор обученных моделей или бенчмарков: ни предобученные веса, ни скрипты обучения не упоминаются.Сколько механизмов включено?Несколько десятков в четырёх сериях: 37 модулей Attention (например, External, Self, CBAM, SE, ECA, Shuffle), 25 Backbone (ResNet, PVT, DeiT, VOLO...), 6 вариантов MLP, 3 метода Re-parameter и 5 вариантов Convolution.
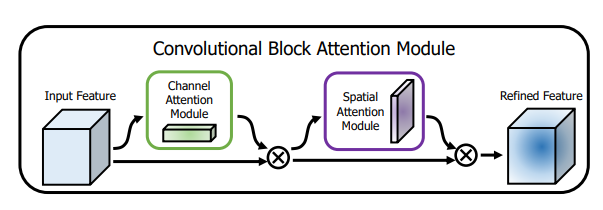
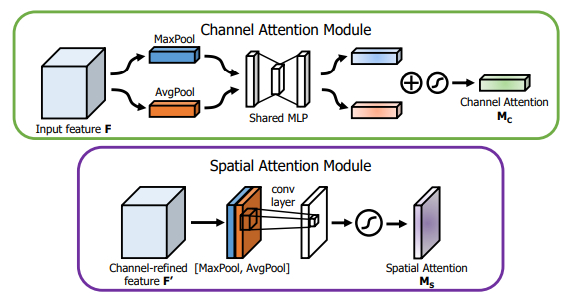
Несколько десятков в четырёх сериях: 37 модулей Attention (например, External, Self, CBAM, SE, ECA, Shuffle), 25 Backbone (ResNet, PVT, DeiT, VOLO...), 6 вариантов MLP, 3 метода Re-parameter и 5 вариантов Convolution.Что такое CBAM в этом репозитории?CBAM (Convolutional Block Attention Module) — одна из включённых реализаций attention, воспроизводящая статью ECCV2018, которая объединяет канальное и пространственное внимание.
CBAM (Convolutional Block Attention Module) — одна из включённых реализаций attention, воспроизводящая статью ECCV2018, которая объединяет канальное и пространственное внимание.Могу ли я использовать модуль напрямую в своей модели?Да, каждый модуль — самостоятельный класс PyTorch с примером использования в README, поэтому его можно сразу встроить в свою нейросетевую архитектуру.
Да, каждый модуль — самостоятельный класс PyTorch с примером использования в README, поэтому его можно сразу встроить в свою нейросетевую архитектуру.Есть ли китайская версия документации?Да, README доступен на упрощённом китайском и на английском языках.
Да, README доступен на упрощённом китайском и на английском языках.What are similar projects?deep-learning-for-image-processing, nnUNet_att_position_correction, Attention-Residuals, DeepLearning, vit-pytorch, llama3-from-scratch, Deep-Learning-Papers-Reading-Roadmap, VisionHOPE
deep-learning-for-image-processing, nnUNet_att_position_correction, Attention-Residuals, DeepLearning, vit-pytorch, llama3-from-scratch, Deep-Learning-Papers-Reading-Roadmap, VisionHOPEWhich topics is it in?convolutional-neural-networks, attention, image-classification, attention-mechanism, paper, academic, neural-network, transformer, computer-vision, pytorch, deep-learning, research
convolutional-neural-networks, attention, image-classification, attention-mechanism, paper, academic, neural-network, transformer, computer-vision, pytorch, deep-learning, research