


Что это такое?
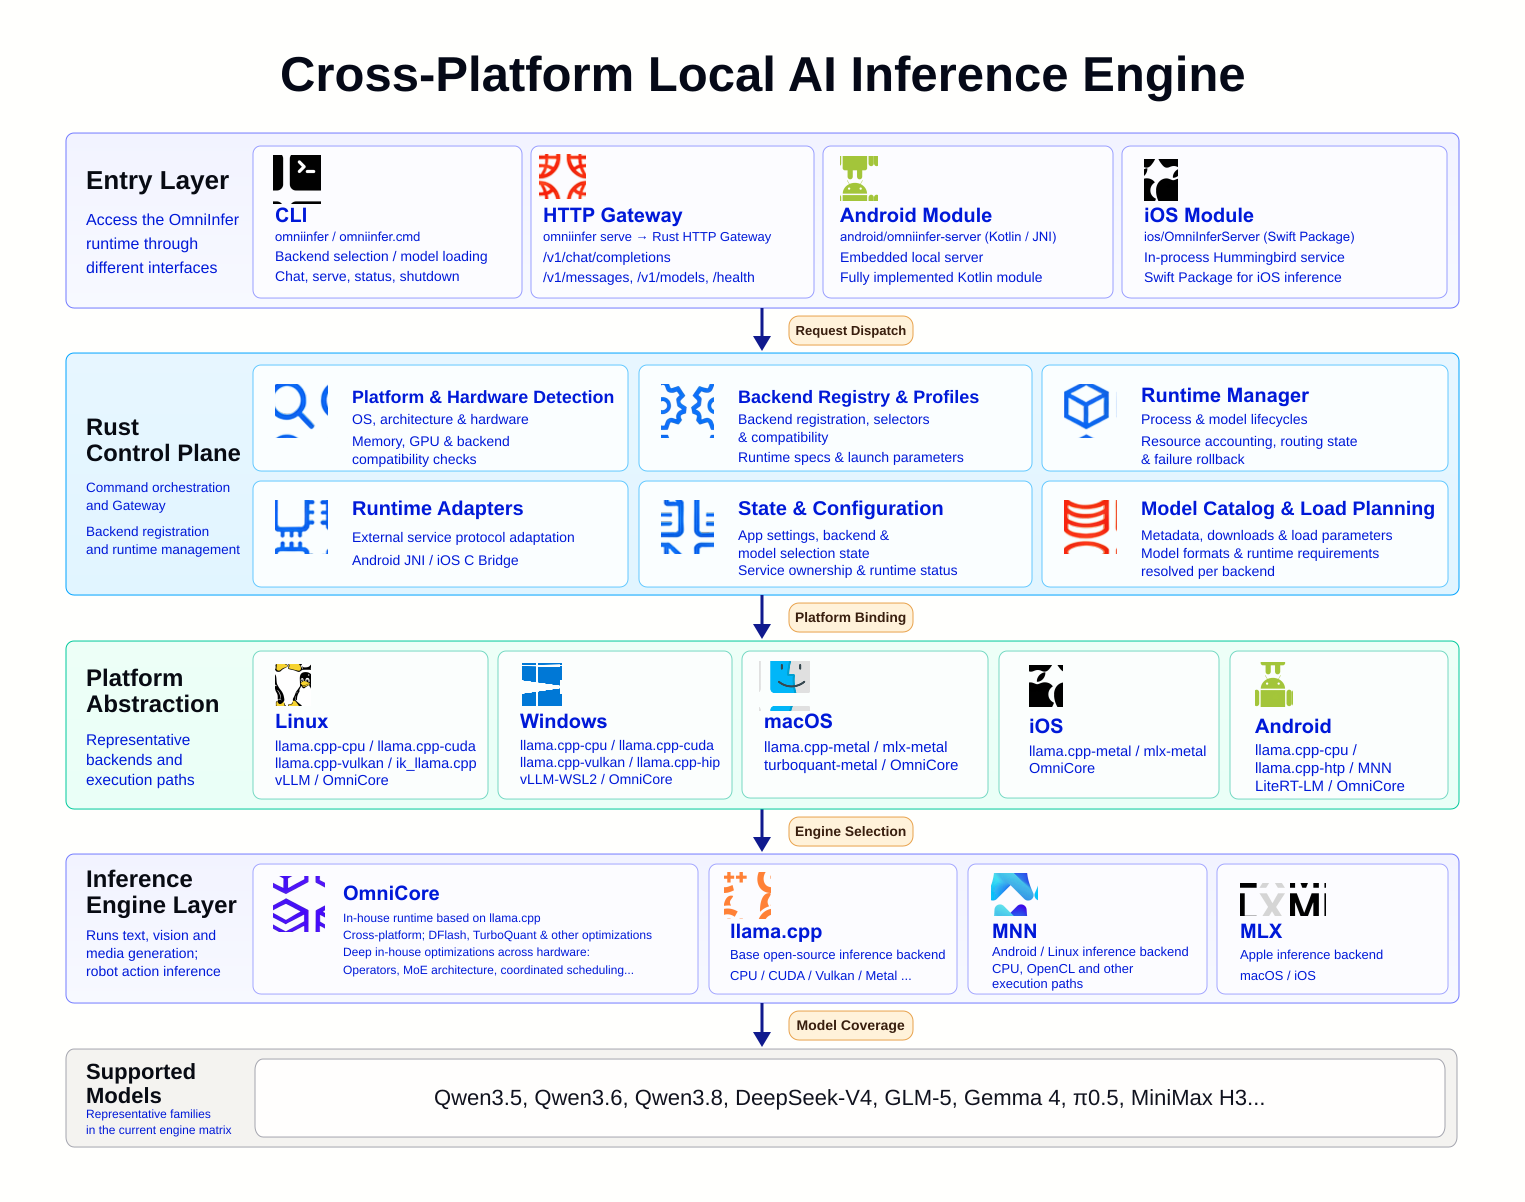
 OmniInfer — кроссплатформенный движок инференса для локального запуска больших языковых моделей (LLM) и визуально-языковых моделей (VLM) на устройстве. Он служит слоем инференса для платформы оркестрации моделей Omni Studio.
Это приложение с графическим интерфейсом или инструмент командной строки?Это CLI со встроенным терминальным интерфейсом (TUI). Команда omniinfer открывает TUI, в котором выбирается бэкенд и загружается модель для чата, а omniinfer serve открывает HTTP API, совместимый с OpenAI и Anthropic.
Это CLI со встроенным терминальным интерфейсом (TUI). Команда omniinfer открывает TUI, в котором выбирается бэкенд и загружается модель для чата, а omniinfer serve открывает HTTP API, совместимый с OpenAI и Anthropic.Как установить и начать пользоваться?Установите через скрипт для своей платформы (curl -fsSL ... | bash на Linux/macOS, irm ... | iex в PowerShell на Windows), затем запустите omniinfer, дайте ему выбрать совместимый бэкенд, выберите локальную модель и начните общение.
Установите через скрипт для своей платформы (curl -fsSL ... | bash на Linux/macOS, irm ... | iex в PowerShell на Windows), затем запустите omniinfer, дайте ему выбрать совместимый бэкенд, выберите локальную модель и начните общение.Нужно ли самому устанавливать бэкенды инференса?Обычно нет: TUI может сам установить подходящую готовую среду выполнения из движков вроде llama.cpp, MNN, MLX или TurboQuant. Самые новые модели могут требовать бэкенда, собранного вручную из исходного кода, пока не выйдет подходящая готовая сборка.
Обычно нет: TUI может сам установить подходящую готовую среду выполнения из движков вроде llama.cpp, MNN, MLX или TurboQuant. Самые новые модели могут требовать бэкенда, собранного вручную из исходного кода, пока не выйдет подходящая готовая сборка.Работает ли каждый бэкенд и среда выполнения на любом устройстве?Нет: доступность среды выполнения зависит от устройства и ускорителя, поэтому проверяйте её командой omniinfer backend list. Поддержка моделей в день выхода иногда работает только через бэкенд, собранный из исходного кода, до того как появится подходящая готовая среда выполнения.
Нет: доступность среды выполнения зависит от устройства и ускорителя, поэтому проверяйте её командой omniinfer backend list. Поддержка моделей в день выхода иногда работает только через бэкенд, собранный из исходного кода, до того как появится подходящая готовая среда выполнения.Можно ли встроить это в мобильное приложение?Да: помимо десктопного и серверного CLI для Linux, macOS и Windows, OmniInfer включает модуль Android Gradle и пакет Swift для iOS, чтобы встраивать нативный локальный инференс прямо в мобильные приложения.
Да: помимо десктопного и серверного CLI для Linux, macOS и Windows, OmniInfer включает модуль Android Gradle и пакет Swift для iOS, чтобы встраивать нативный локальный инференс прямо в мобильные приложения.Мои данные когда-нибудь покидают устройство?Нет: OmniInfer создан для приватного, полностью локального инференса LLM и VLM. На самом устройстве он открывает только локальный API, совместимый с OpenAI и Anthropic.
Нет: OmniInfer создан для приватного, полностью локального инференса LLM и VLM. На самом устройстве он открывает только локальный API, совместимый с OpenAI и Anthropic.Зачем нужен API, совместимый с OpenAI и Anthropic?Команда omniinfer serve открывает локальную HTTP-конечную точку, имитирующую API OpenAI и Anthropic. Поэтому существующие инструменты и SDK, созданные для этих сервисов, могут обращаться к вашим локальным моделям.
Команда omniinfer serve открывает локальную HTTP-конечную точку, имитирующую API OpenAI и Anthropic. Поэтому существующие инструменты и SDK, созданные для этих сервисов, могут обращаться к вашим локальным моделям.Что такое демо vla-libero?Это необязательный пример, который запускает политику vision-language-action SmolVLA через среду выполнения vla.cpp OmniInfer внутри симулятора LIBERO. Он показывает виды с камер, предсказанные действия и задержку на панели мониторинга в браузере.
Это необязательный пример, который запускает политику vision-language-action SmolVLA через среду выполнения vla.cpp OmniInfer внутри симулятора LIBERO. Он показывает виды с камер, предсказанные действия и задержку на панели мониторинга в браузере.Зачем OmniInfer поддерживает так много движков бэкенда?Разные сочетания оборудования и ОС подходят для разных сред выполнения (llama.cpp, MLX, MNN, TurboQuant и других), поэтому OmniInfer автоматически переключается на тот движок, который лучше всего работает на конкретном устройстве.
Разные сочетания оборудования и ОС подходят для разных сред выполнения (llama.cpp, MLX, MNN, TurboQuant и других), поэтому OmniInfer автоматически переключается на тот движок, который лучше всего работает на конкретном устройстве.Что такое Omni Studio?Это единая платформа оркестрации моделей, упомянутая в README. OmniInfer служит её базовым слоем инференса и отвечает за непосредственный запуск моделей на устройстве.
Это единая платформа оркестрации моделей, упомянутая в README. OmniInfer служит её базовым слоем инференса и отвечает за непосредственный запуск моделей на устройстве.Какие есть похожие проекты?turbo-fieldfare, GLM-5.3-Flash-EXL3-2x-DGX-Sparks-TensorFold, xn-ptts, Strata, project-maya, uzu, nobodywho, Janus
turbo-fieldfare, GLM-5.3-Flash-EXL3-2x-DGX-Sparks-TensorFold, xn-ptts, Strata, project-maya, uzu, nobodywho, JanusВ каких он темах?vla, vision-language-model, edge-ai, llm-inference, multimodal, tui, local-llm, openai-compatible, inference, offline, mobile, anthropic
vla, vision-language-model, edge-ai, llm-inference, multimodal, tui, local-llm, openai-compatible, inference, offline, mobile, anthropic- Автор
- omnimind-ai
- Размер
- 105.8 MB
- Звёзды
- 1.9K
- Обновлён
- КоммитNov 10Релизv0.3.31Oct 21
- Возраст
- 7 мес
- Коммиты · 90 дней