Что это?
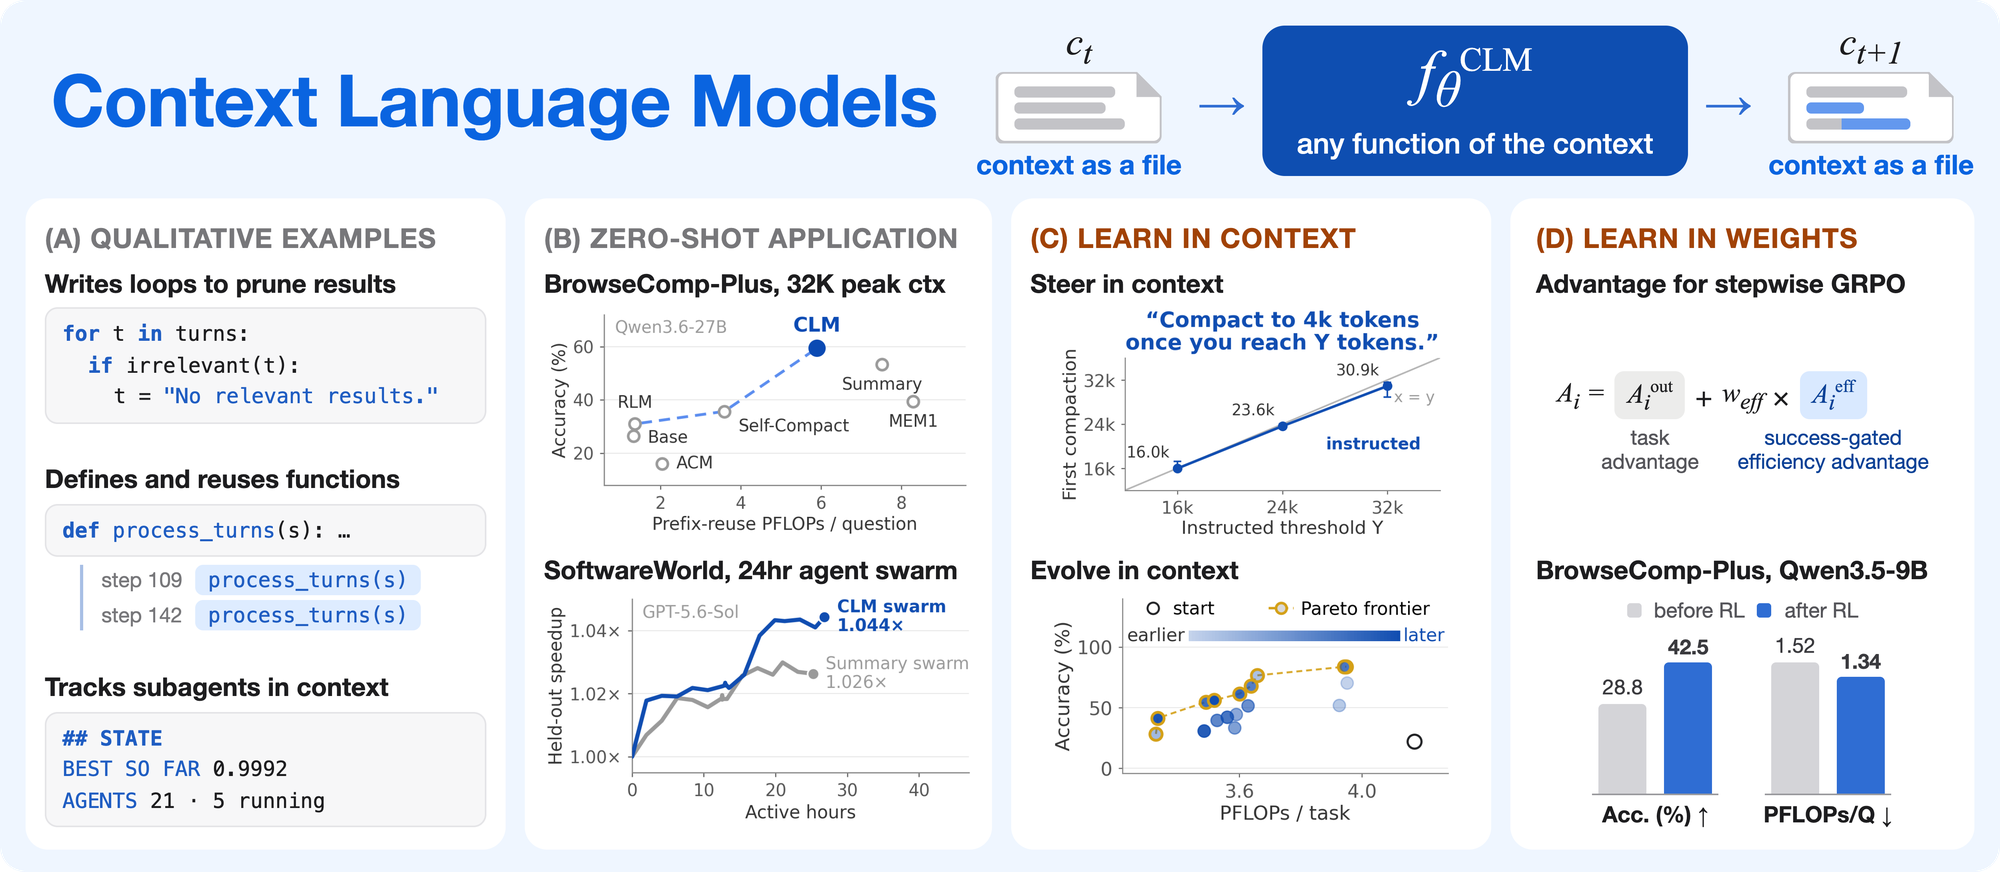
 Это официальный релиз кода исследования «Context Language Models (CLMs)» от University of Washington, Meta Superintelligence Labs, MIT и Trillium Labs. CLM — языковые модели, которые изначально сами управляют своим контекстом, обращаясь с ним как с файлом, который можно свободно редактировать; это естественно распространяется на мультиагентные сценарии, где контекст каждого агента — его собственный файл.
Это готовый инструмент или исследовательский код для воспроизведения экспериментов из статьи?Это исследовательский код к статье о CLM, а не отполированный продукт: в репозитории реализации на базе Harbor (clmharness, clmicl, clmrl) плюс компонент сервинга с повторным использованием суффиксных кэшей — всё для запуска и воспроизведения экспериментов из статьи.
Это исследовательский код к статье о CLM, а не отполированный продукт: в репозитории реализации на базе Harbor (clmharness, clmicl, clmrl) плюс компонент сервинга с повторным использованием суффиксных кэшей — всё для запуска и воспроизведения экспериментов из статьи.Как запустить CLM?Запустите минимального CLM-агента на любой задаче Harbor через CLI clm-harbor с флагом «-a clm-minimal»; детали конфигурации и сервинга описаны в clm/clmharness.
Запустите минимального CLM-агента на любой задаче Harbor через CLI clm-harbor с флагом «-a clm-minimal»; детали конфигурации и сервинга описаны в clm/clmharness.Нужен ли фреймворк Harbor для его использования?Да, CLM построены поверх Harbor и вызываются через CLI clm-harbor, а не запускаются отдельно.
Да, CLM построены поверх Harbor и вызываются через CLI clm-harbor, а не запускаются отдельно.Всё ли из статьи уже доступно здесь?Не совсем: ContextBench — бенчмарк, упомянутый для оценки CLM, — всё ещё значится как «coming soon» и в репозиторий пока не включён.
Не совсем: ContextBench — бенчмарк, упомянутый для оценки CLM, — всё ещё значится как «coming soon» и в репозиторий пока не включён.Можно ли использовать это в коммерческих целях?Нет, проект выпущен под CC BY-NC 4.0, которая допускает только исследования и некоммерческое использование.
Нет, проект выпущен под CC BY-NC 4.0, которая допускает только исследования и некоммерческое использование.Насколько CLM лучше стандартных подходов к управлению контекстом?В zero-shot тестах CLM показывают точность на 11,4% выше при 21,5% меньше FLOPs на BrowseComp-Plus, баллы на 5% выше при 59% меньше FLOPs на 12-часовом EdgeBench и улучшение на 65% больше при равных вычислениях на 24-часовой мультирепозиторной задаче с роем агентов.
В zero-shot тестах CLM показывают точность на 11,4% выше при 21,5% меньше FLOPs на BrowseComp-Plus, баллы на 5% выше при 59% меньше FLOPs на 12-часовом EdgeBench и улучшение на 65% больше при равных вычислениях на 24-часовой мультирепозиторной задаче с роем агентов.Можно ли настраивать поведение CLM без переобучения модели?Да, clm/clmicl показывает, что CLM можно направлять инструкциями на естественном языке, эволюционировавшими через цикл оптимизации skills, повышая точность на отложенных данных до 35,9 пункта в задаче управления контекстом при меньших вычислениях.
Да, clm/clmicl показывает, что CLM можно направлять инструкциями на естественном языке, эволюционировавшими через цикл оптимизации skills, повышая точность на отложенных данных до 35,9 пункта в задаче управления контекстом при меньших вычислениях.Есть ли в репозитории метод обучения с подкреплением для CLM?Да, clm/clmrl реализует метод online RL, который улучшил результат Qwen3.5-9B на BrowseComp-Plus на 47,6%, используя на 12% меньше FLOPs.
Да, clm/clmrl реализует метод online RL, который улучшил результат Qwen3.5-9B на BrowseComp-Plus на 47,6%, используя на 12% меньше FLOPs.Для чего нужен suffixcachereuse?Это компонент для эффективного сервинга CLM за счёт повторного использования суффиксных кэшей; цель — снизить вычислительную стоимость работы CLM в условиях, близких к продакшену.
Это компонент для эффективного сервинга CLM за счёт повторного использования суффиксных кэшей; цель — снизить вычислительную стоимость работы CLM в условиях, близких к продакшену.What are similar projects?MSA, Awesome-Graph-Engineering, Raven, awesome-rsi, Tiersense, GVS5H, jeeves, Attention-Residuals
MSA, Awesome-Graph-Engineering, Raven, awesome-rsi, Tiersense, GVS5H, jeeves, Attention-ResidualsWhich topics is it in?arxiv, foundation-models, long-term-memory, multi-agent-systems, llm-agents, paper, training, natural-language-processing, context-engineering, academic, harness, agent-framework
arxiv, foundation-models, long-term-memory, multi-agent-systems, llm-agents, paper, training, natural-language-processing, context-engineering, academic, harness, agent-framework