



Что это такое?
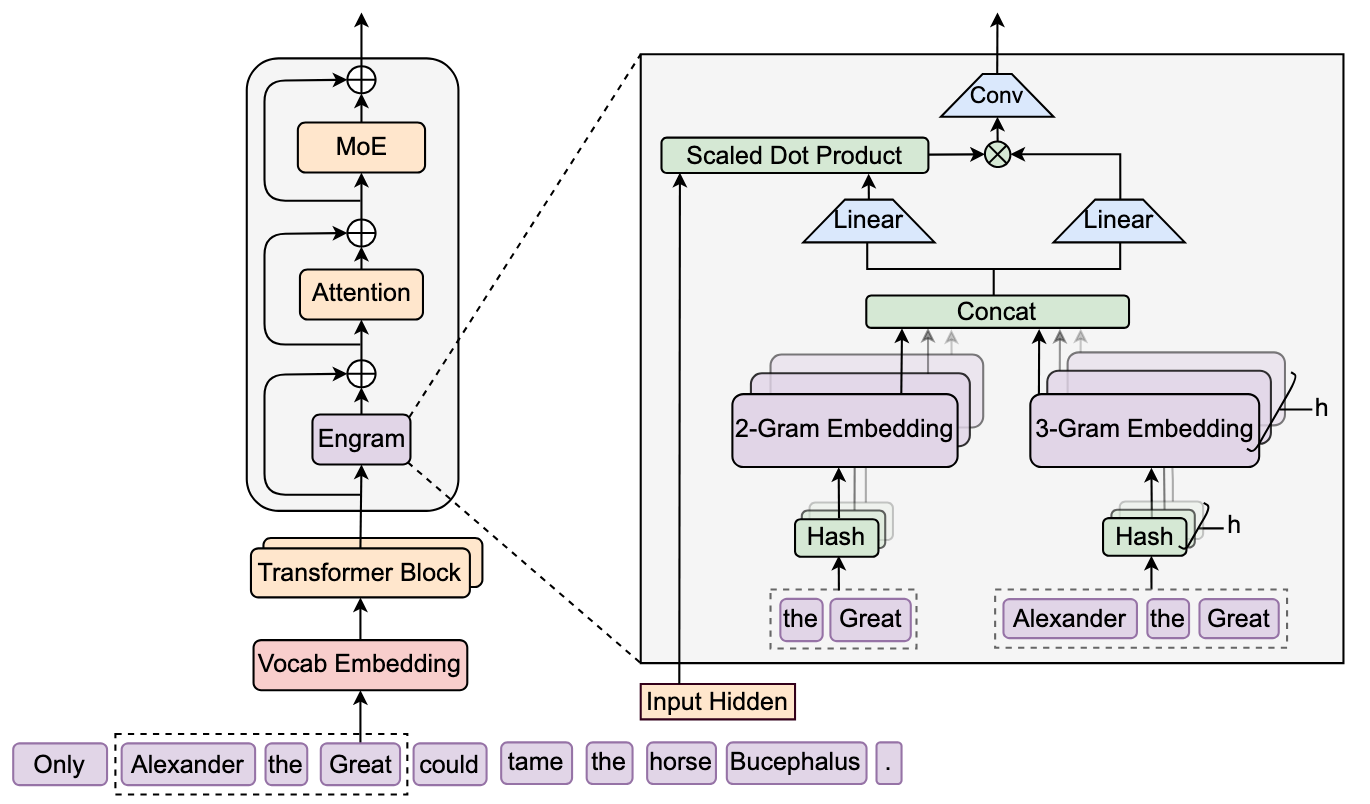
 Это официальный релиз кода к статье DeepSeek 'Conditional Memory via Scalable Lookup', представляющий Engram — модуль, который даёт трансформерам нативный примитив поиска знаний, модернизируя классические N-gram-эмбеддинги для выборки за O(1), в дополнение к разреженности Mixture-of-Experts.
Это полноценная обучаемая модель или просто демо-код?Это автономная демонстрационная реализация, призванная показать поток данных модуля Engram; она имитирует окружающие компоненты вроде Attention, MoE и mHC, а не предоставляет полную обучаемую модель.
Это автономная демонстрационная реализация, призванная показать поток данных модуля Engram; она имитирует окружающие компоненты вроде Attention, MoE и mHC, а не предоставляет полную обучаемую модель.Как попробовать код?Установите Python 3.8+ и PyTorch, затем запустите автономный скрипт из репозитория, демонстрирующий ключевую логику модуля Engram и поток данных.
Установите Python 3.8+ и PyTorch, затем запустите автономный скрипт из репозитория, демонстрирующий ключевую логику модуля Engram и поток данных.Что должно быть установлено для запуска?Только Python 3.8 или новее и PyTorch; другого окружения для демо-кода не описано.
Только Python 3.8 или новее и PyTorch; другого окружения для демо-кода не описано.Входит ли сюда полная модель Engram-27B или конвейер обучения?Нет, выпущен только упрощённый автономный демо-пример модуля Engram; использованная в статье предобучающая настройка Engram-27B, базовые модели MoE и настоящие компоненты Attention/mHC здесь не предоставляются.
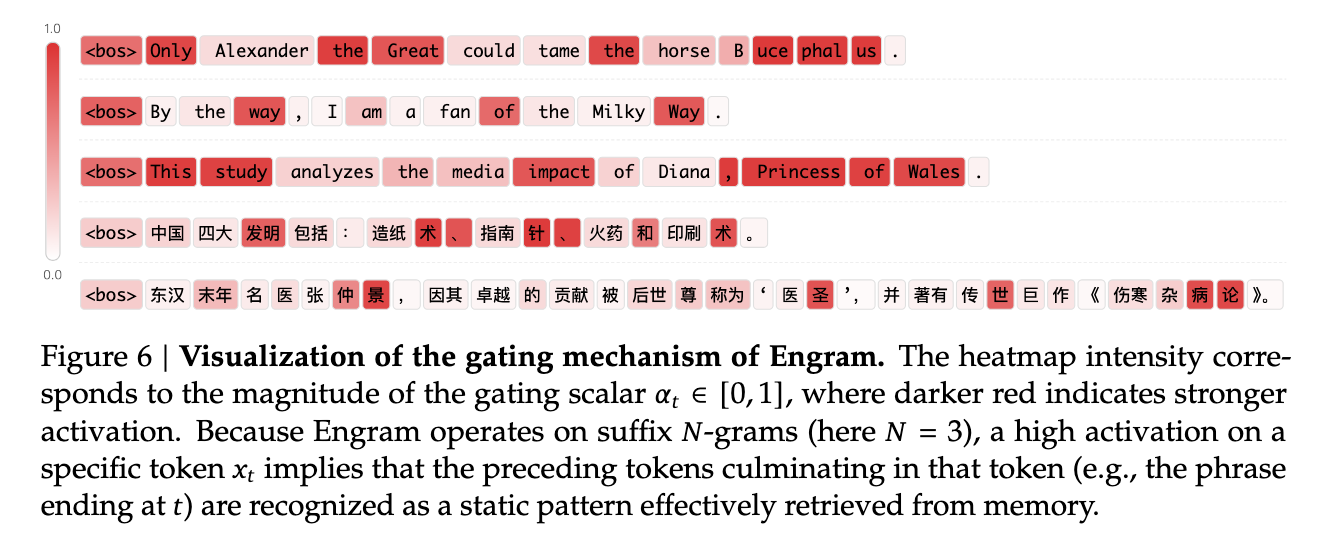
Нет, выпущен только упрощённый автономный демо-пример модуля Engram; использованная в статье предобучающая настройка Engram-27B, базовые модели MoE и настоящие компоненты Attention/mHC здесь не предоставляются.Что именно делает модуль Engram?Он извлекает статическую память на основе N-gram через детерминированную выборку и сливает её с динамическими скрытыми состояниями модели, давая трансформеру механизм условной памяти в дополнение к методам условных вычислений вроде MoE.
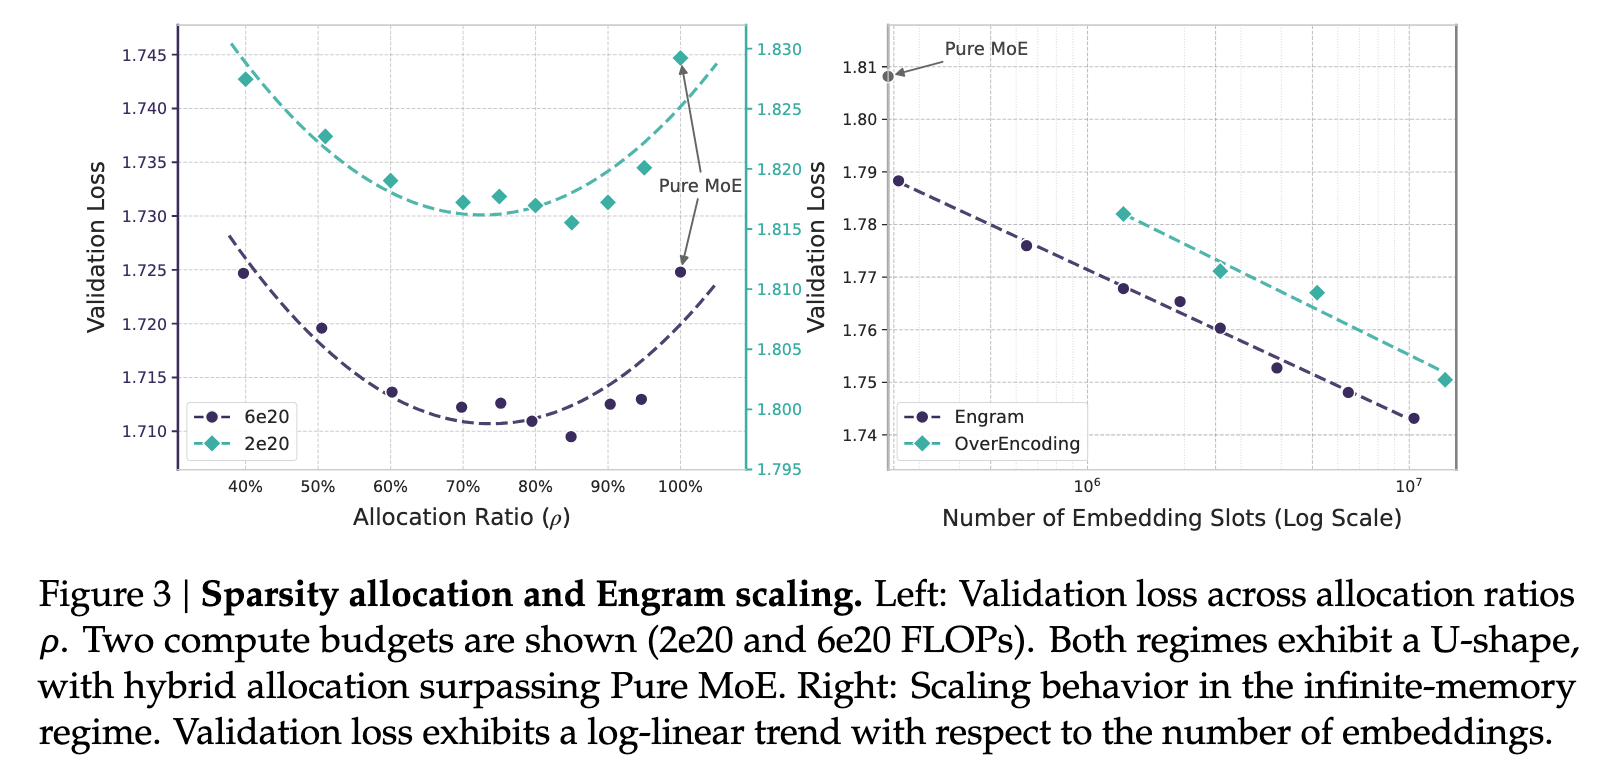
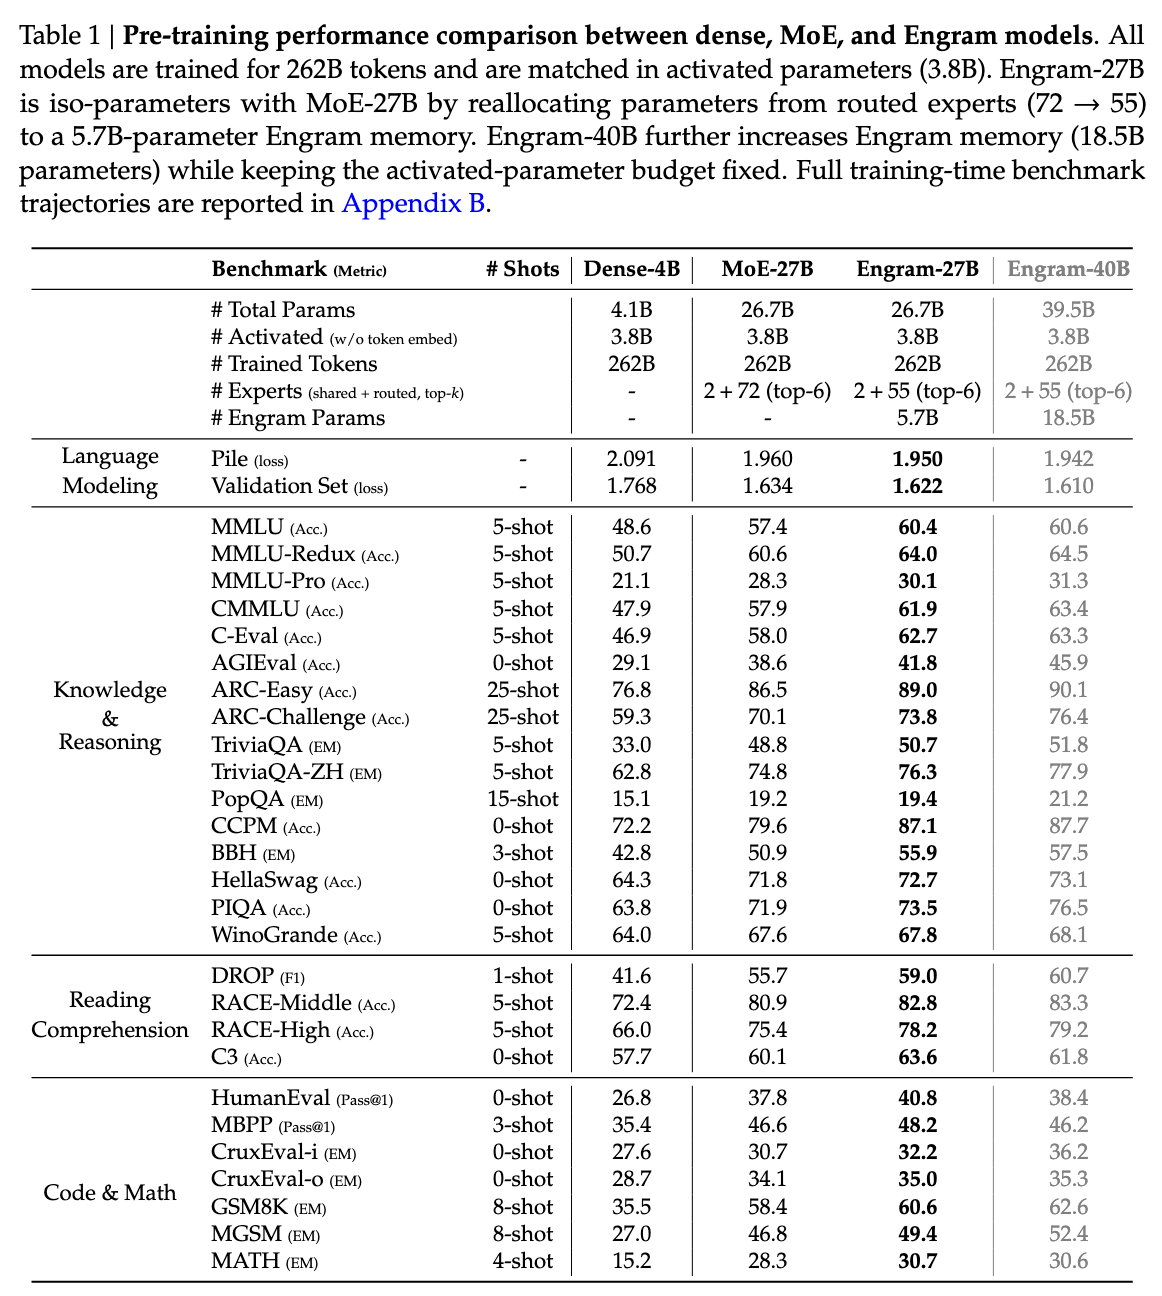
Он извлекает статическую память на основе N-gram через детерминированную выборку и сливает её с динамическими скрытыми состояниями модели, давая трансформеру механизм условной памяти в дополнение к методам условных вычислений вроде MoE.Как Engram соотносится с Mixture-of-Experts?При сопоставимых бюджетах параметров и FLOPs модель Engram-27B стабильно превосходит базовые модели MoE на задачах знаний, рассуждений, кода и математики, а в статье выводится U-образный закон масштабирования для распределения ёмкости между вычислениями MoE и памятью Engram.
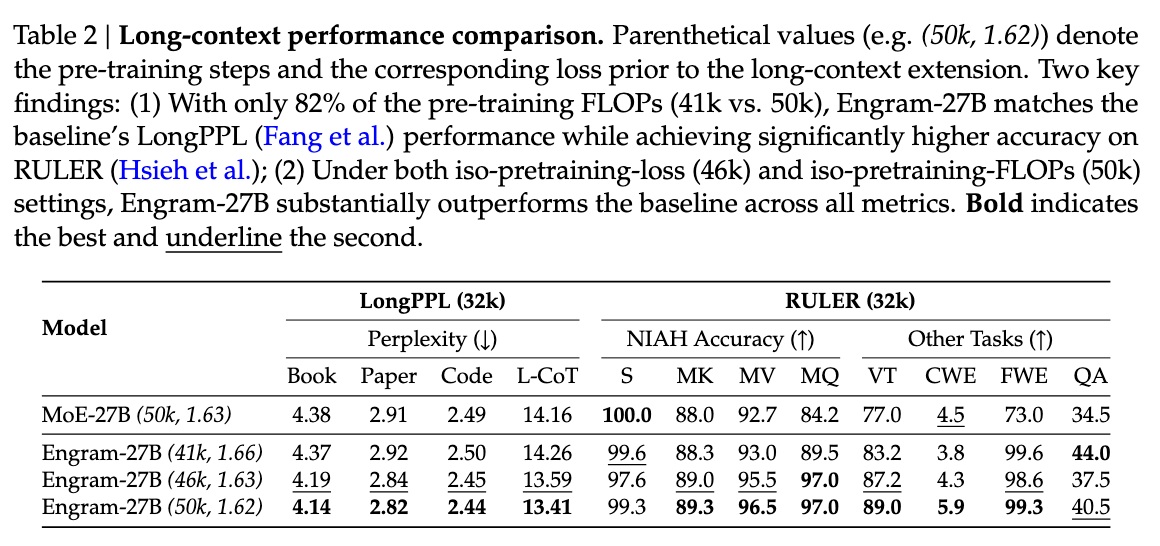
При сопоставимых бюджетах параметров и FLOPs модель Engram-27B стабильно превосходит базовые модели MoE на задачах знаний, рассуждений, кода и математики, а в статье выводится U-образный закон масштабирования для распределения ёмкости между вычислениями MoE и памятью Engram.Почему Engram эффективен на инференсе?Поскольку его адресация детерминирована, большие таблицы эмбеддингов, на которые он опирается, можно выгружать в память хоста с минимальными накладными расходами на инференсе; к тому же он освобождает ранние слои от запоминания статических паттернов, сохраняя эффективную глубину для рассуждений.
Поскольку его адресация детерминирована, большие таблицы эмбеддингов, на которые он опирается, можно выгружать в память хоста с минимальными накладными расходами на инференсе; к тому же он освобождает ранние слои от запоминания статических паттернов, сохраняя эффективную глубину для рассуждений.What are similar projects?Attention-Residuals, bdh, llama3-from-scratch, MSA, DeepGEMM, llm-architecture-from-scratch, minGPT, Chinese-BERT-wwm
Attention-Residuals, bdh, llama3-from-scratch, MSA, DeepGEMM, llm-architecture-from-scratch, minGPT, Chinese-BERT-wwmWhich topics is it in?mixture-of-experts, attention-mechanism, papers, paper, embeddings, neural-network, academic-research, large-language-models, transformer, nlp, artificial-intelligence, deepseek
mixture-of-experts, attention-mechanism, papers, paper, embeddings, neural-network, academic-research, large-language-models, transformer, nlp, artificial-intelligence, deepseek