


24K ·GitHub
Что это такое?
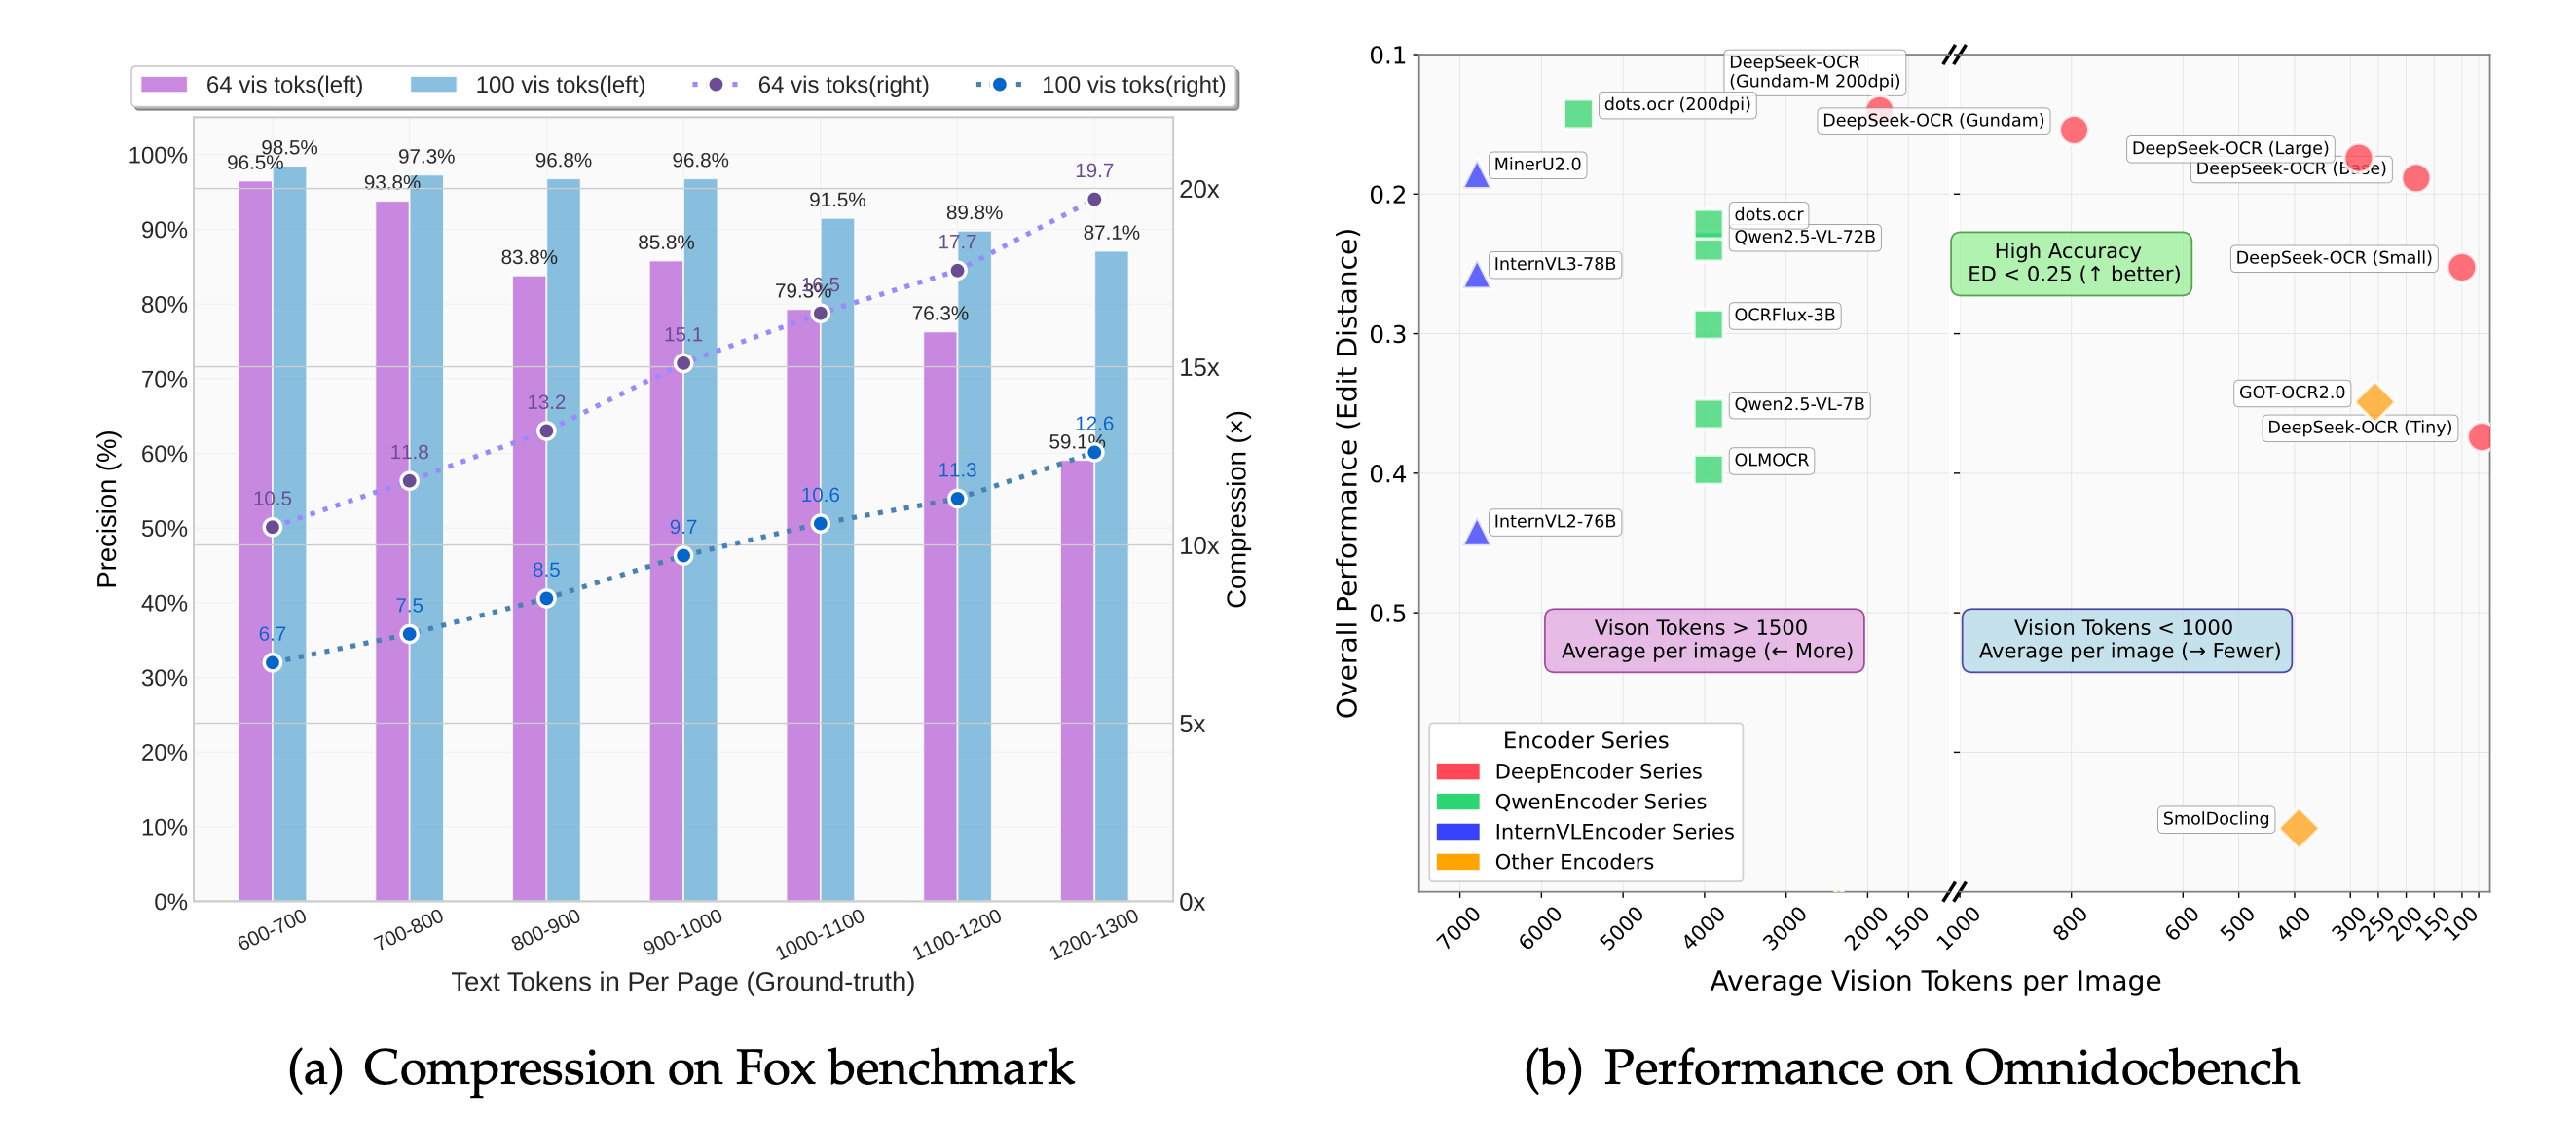
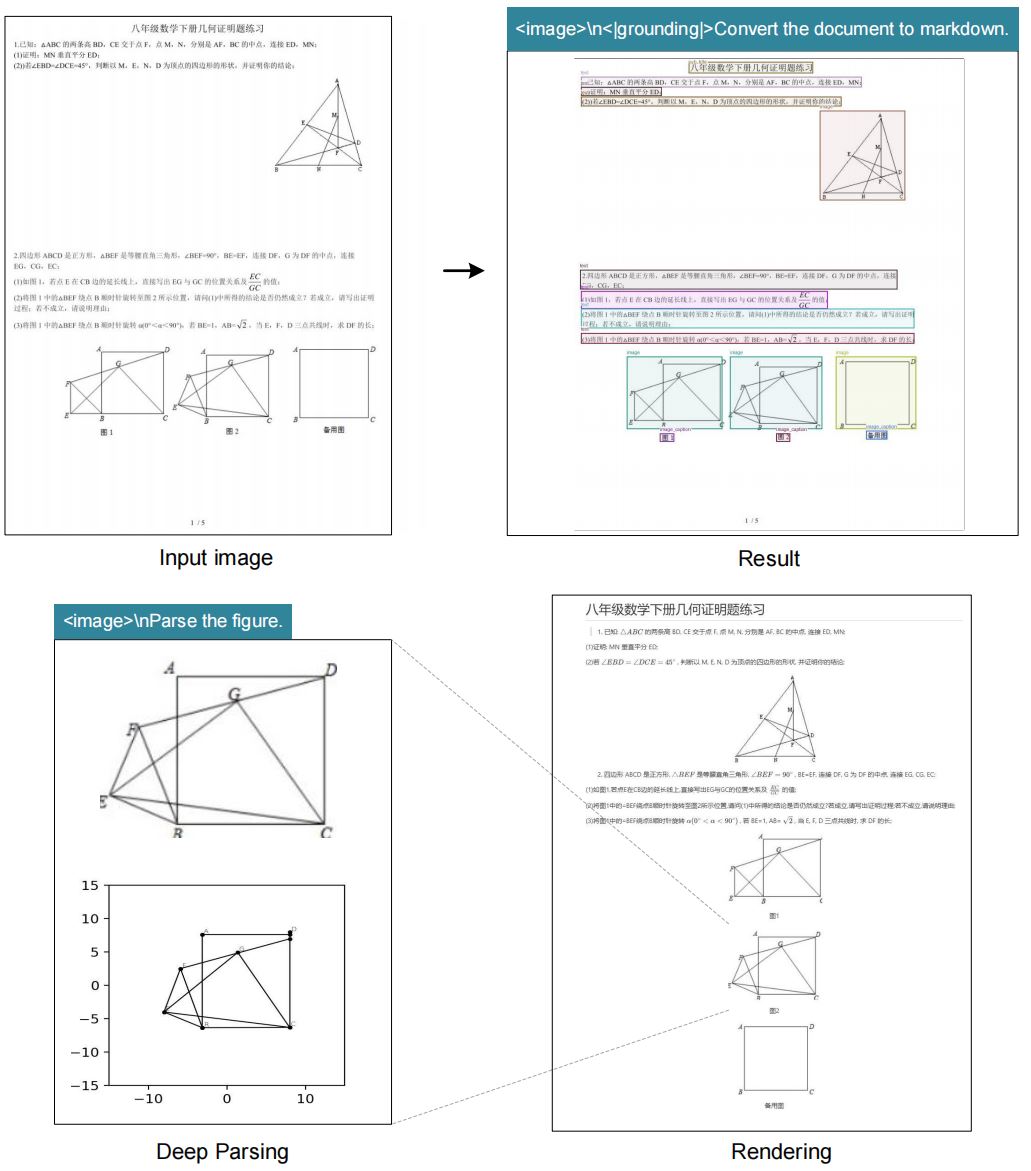
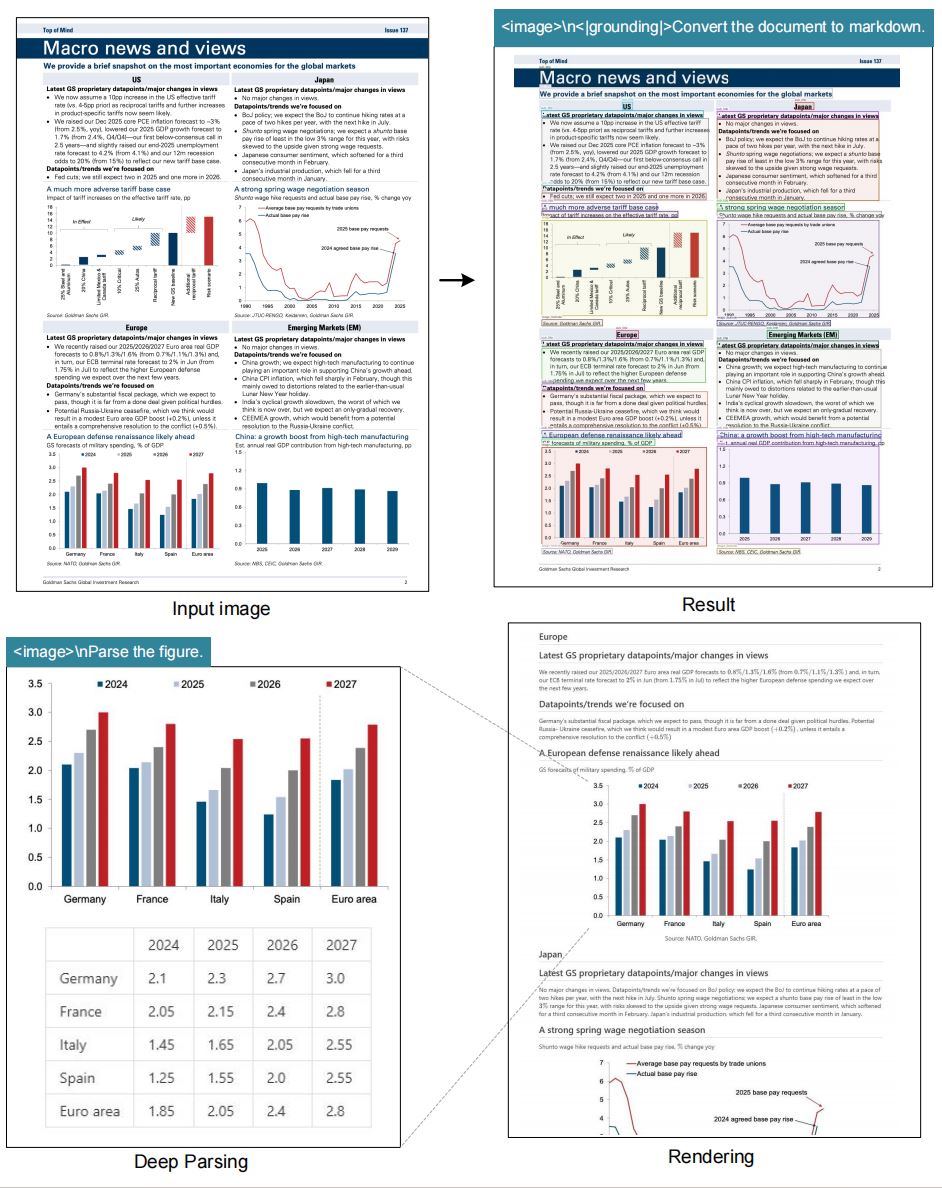
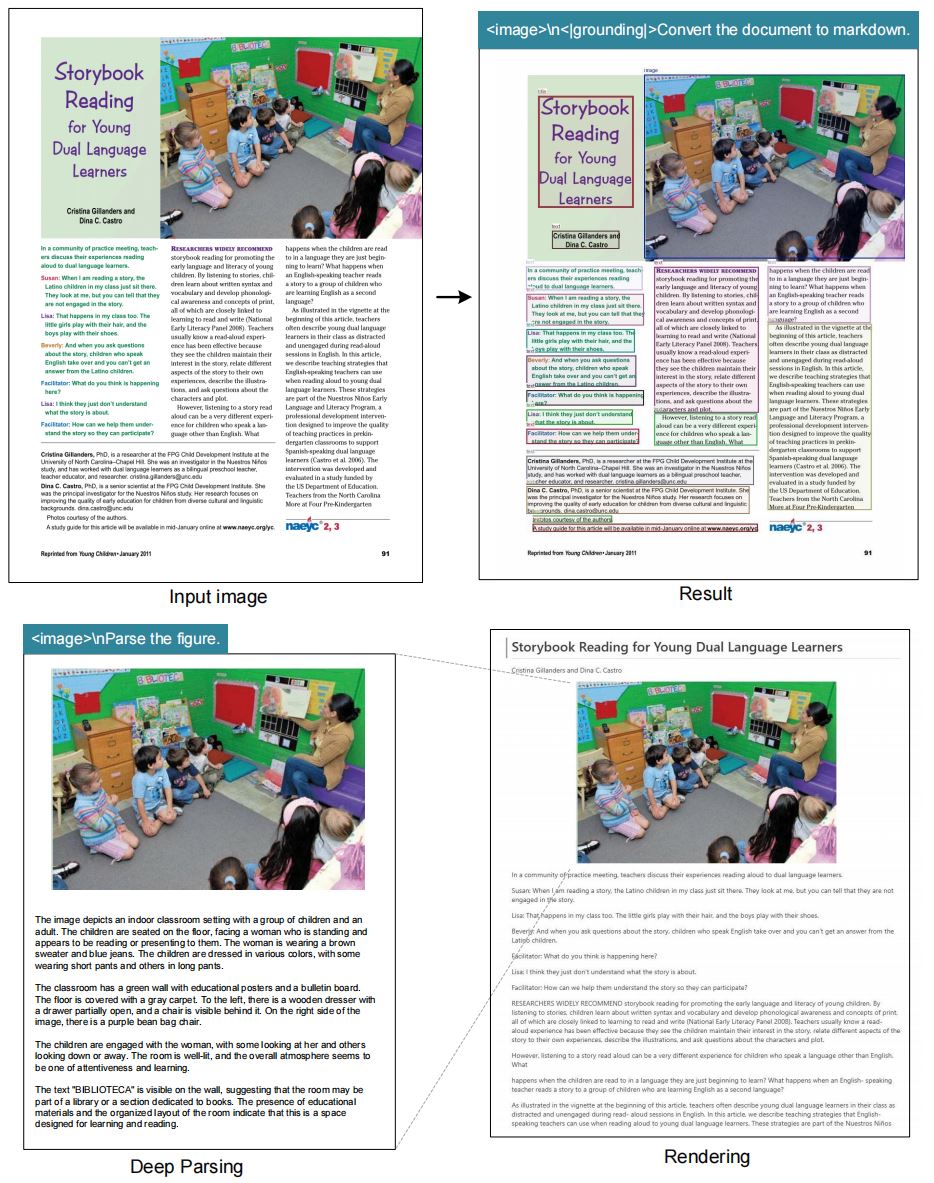
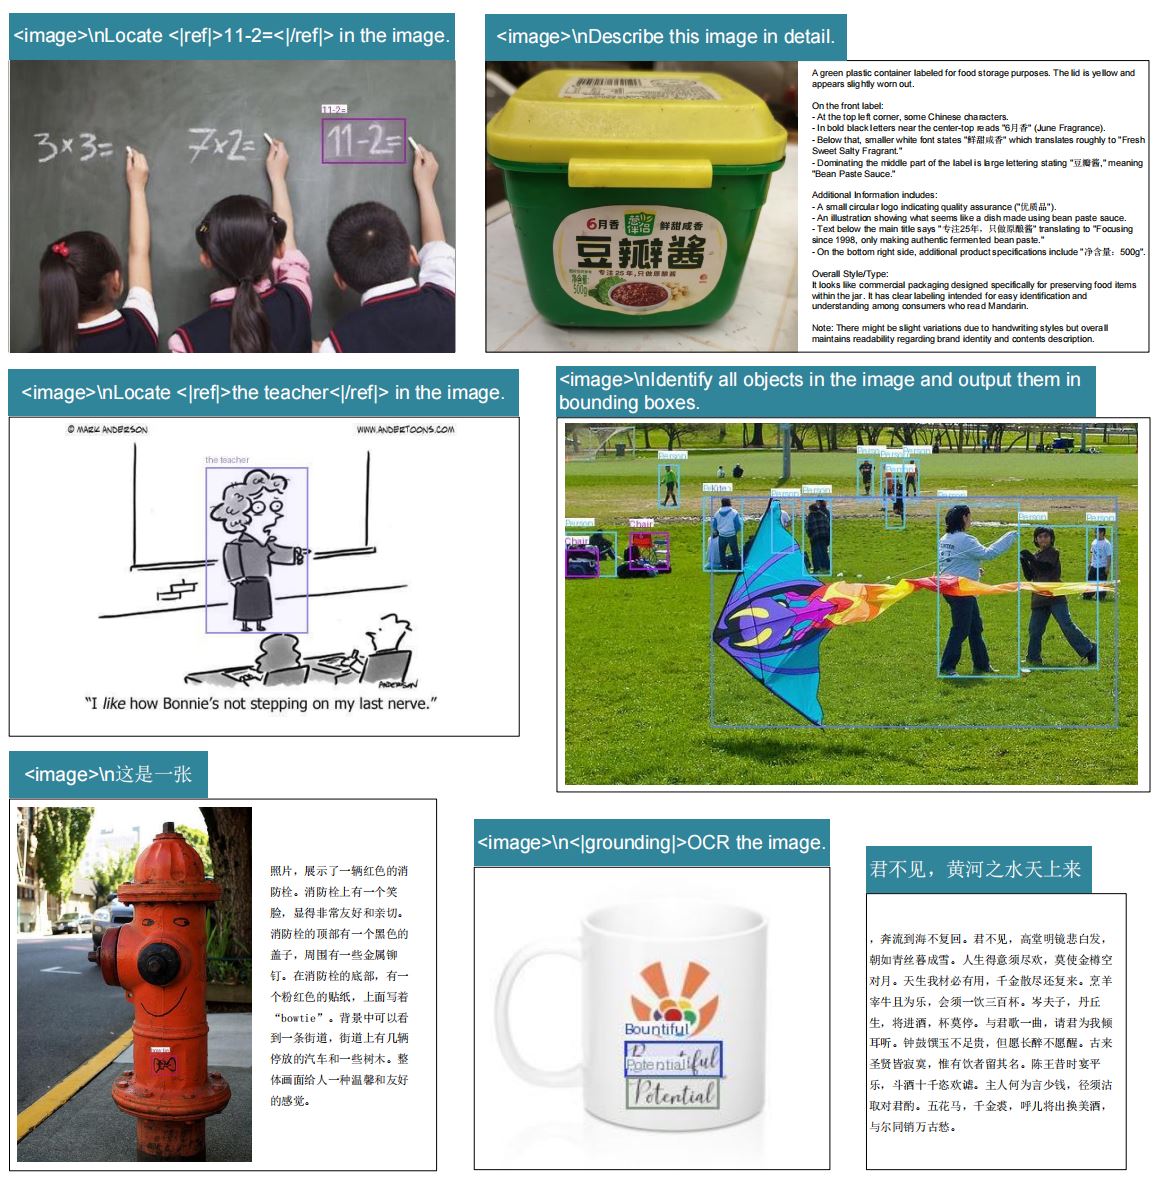
 DeepSeek-OCR — это мультимодальная модель «зрение и язык», созданная для исследования «оптического сжатия контекстов». Речь о том, чтобы сжимать изображения документов с большим объёмом текста в небольшое количество визуальных токенов, из которых LLM всё ещё может точно прочитать текст обратно. Это исследовательский эксперимент: он показывает, сколько текста визуальный энкодер способен передать в визуальном виде.
Это готовое OCR-приложение или то, что я запускаю из кода?Это открытая исследовательская модель, а не готовое приложение. Её нужно запускать самостоятельно через скрипты инференса vLLM или Hugging Face Transformers, которые входят в репозиторий.
Это открытая исследовательская модель, а не готовое приложение. Её нужно запускать самостоятельно через скрипты инференса vLLM или Hugging Face Transformers, которые входят в репозиторий.Как мне его запустить?Клонируйте репозиторий, создайте окружение Conda, установите нужные пакеты, включая конкретный wheel vllm-0.8.5, затем запустите либо скрипт инференса vLLM (для потоковой обработки изображений или пакетной обработки PDF), либо скрипт инференса Transformers.
Клонируйте репозиторий, создайте окружение Conda, установите нужные пакеты, включая конкретный wheel vllm-0.8.5, затем запустите либо скрипт инференса vLLM (для потоковой обработки изображений или пакетной обработки PDF), либо скрипт инференса Transformers.Нужна ли мне видеокарта с CUDA, чтобы его запустить?Да — эталонное окружение использует cuda11.8+torch2.6.0, а показатели пропускной способности в бенчмарках измерялись на GPU A100-40G.
Да — эталонное окружение использует cuda11.8+torch2.6.0, а показатели пропускной способности в бенчмарках измерялись на GPU A100-40G.Есть ли подводные камни при установке?Если запускать инференс vLLM и Transformers вместе в одном окружении, может возникнуть конфликт зависимостей: vllm 0.8.5+cu118 требует transformers>=4.51.1. README заранее предупреждает именно об этой ошибке.
Если запускать инференс vLLM и Transformers вместе в одном окружении, может возникнуть конфликт зависимостей: vllm 0.8.5+cu118 требует transformers>=4.51.1. README заранее предупреждает именно об этой ошибке.Какие режимы разрешения он поддерживает?Доступны четыре фиксированных нативных разрешения: Tiny 512x512 с 64 визуальными токенами, Small 640x640 со 100 токенами, Base 1024x1024 с 256 токенами и Large 1280x1280 с 400 токенами. Кроме того, есть динамический режим «Gundam», который объединяет несколько тайлов 640x640 и один тайл 1024x1024.
Доступны четыре фиксированных нативных разрешения: Tiny 512x512 с 64 визуальными токенами, Small 640x640 со 100 токенами, Base 1024x1024 с 256 токенами и Large 1280x1280 с 400 токенами. Кроме того, есть динамический режим «Gundam», который объединяет несколько тайлов 640x640 и один тайл 1024x1024.Насколько он быстрый на реальных документах?При пакетной оценке PDF-файлов модель достигает около 2500 токенов в секунду на одном GPU A100-40G.
При пакетной оценке PDF-файлов модель достигает около 2500 токенов в секунду на одном GPU A100-40G.Почему это называется «оптическим сжатием»?Идея в том, чтобы передавать большие объёмы текста в визуальном виде, используя гораздо меньше визуальных токенов, чем эквивалентных текстовых, и проверить, сколько модель может восстановить из сильно сжатого визуального представления документа.
Идея в том, чтобы передавать большие объёмы текста в визуальном виде, используя гораздо меньше визуальных токенов, чем эквивалентных текстовых, и проверить, сколько модель может восстановить из сильно сжатого визуального представления документа.Есть ли более новая версия?Да — DeepSeek-OCR2 был анонсирован 2026/01/27 как преемник. Этот репозиторий охватывает первоначальный релиз DeepSeek-OCR от октября 2025 года, который теперь официально поддерживается в основном проекте vLLM.
Да — DeepSeek-OCR2 был анонсирован 2026/01/27 как преемник. Этот репозиторий охватывает первоначальный релиз DeepSeek-OCR от октября 2025 года, который теперь официально поддерживается в основном проекте vLLM.What are similar projects?ZDTaichu5.0-9B, Unlimited-OCR, InternVL, OraRL, UniVR, TeleOCR, halo, Intern-Decision
ZDTaichu5.0-9B, Unlimited-OCR, InternVL, OraRL, UniVR, TeleOCR, halo, Intern-DecisionWhich topics is it in?vision-language-model, natural-language-processing, transformers, vllm, ocr, document-processing, multimodal, huggingface, computer-vision, cuda, pytorch, benchmark
vision-language-model, natural-language-processing, transformers, vllm, ocr, document-processing, multimodal, huggingface, computer-vision, cuda, pytorch, benchmark