





Что это такое?
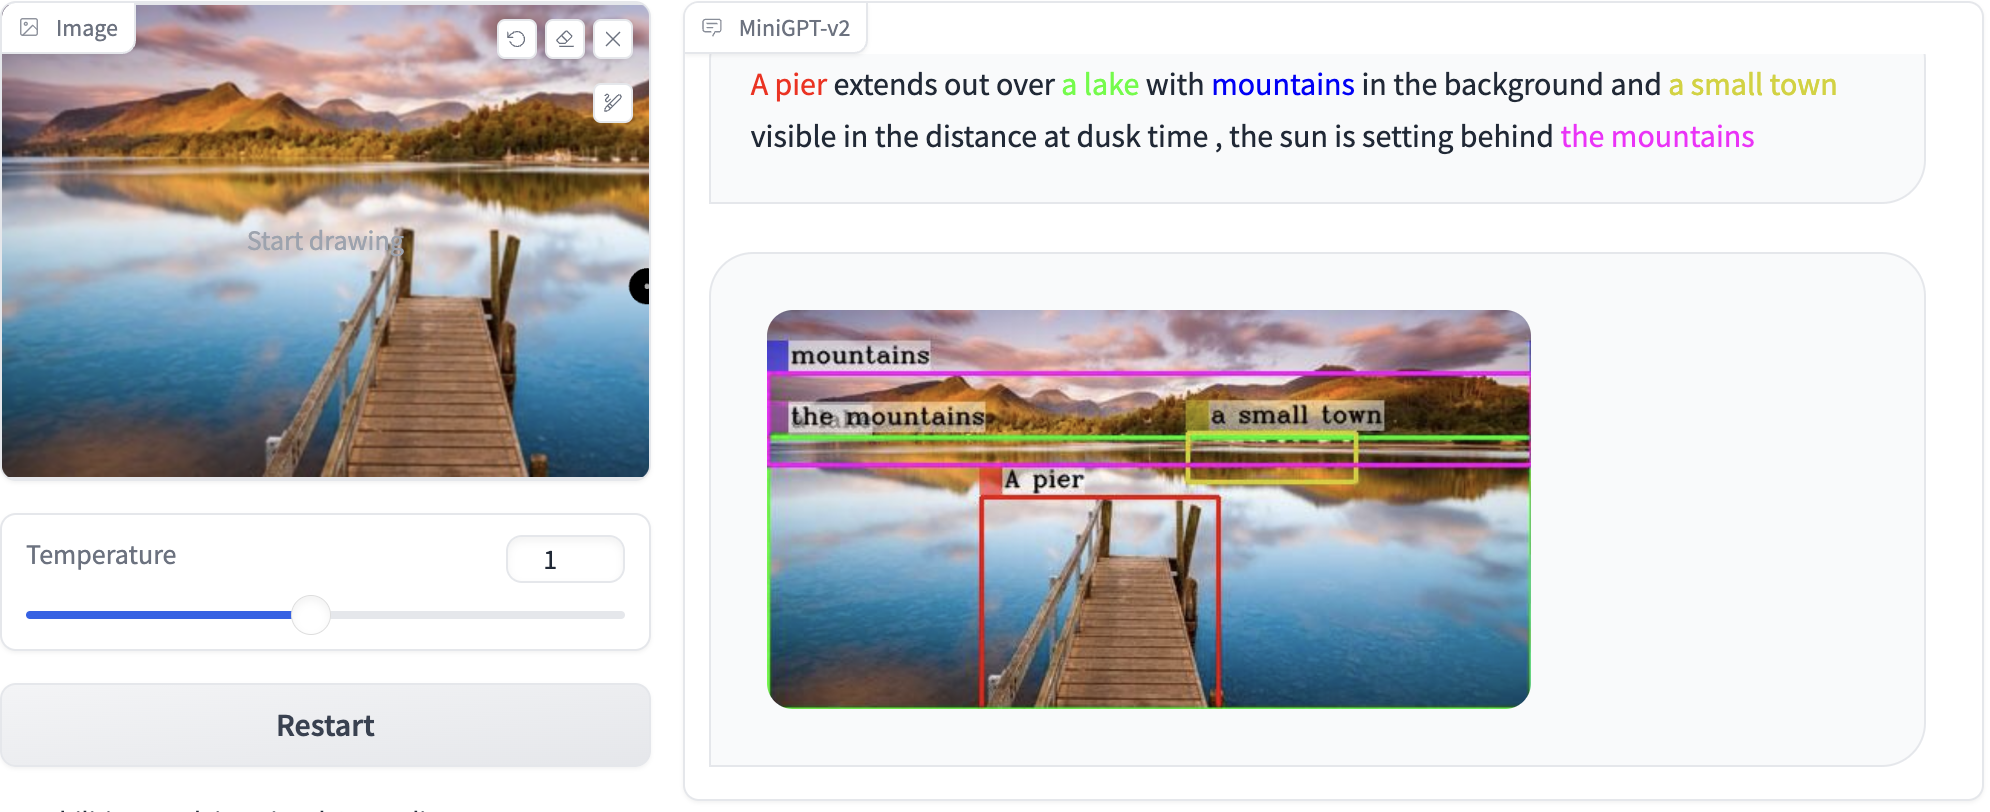
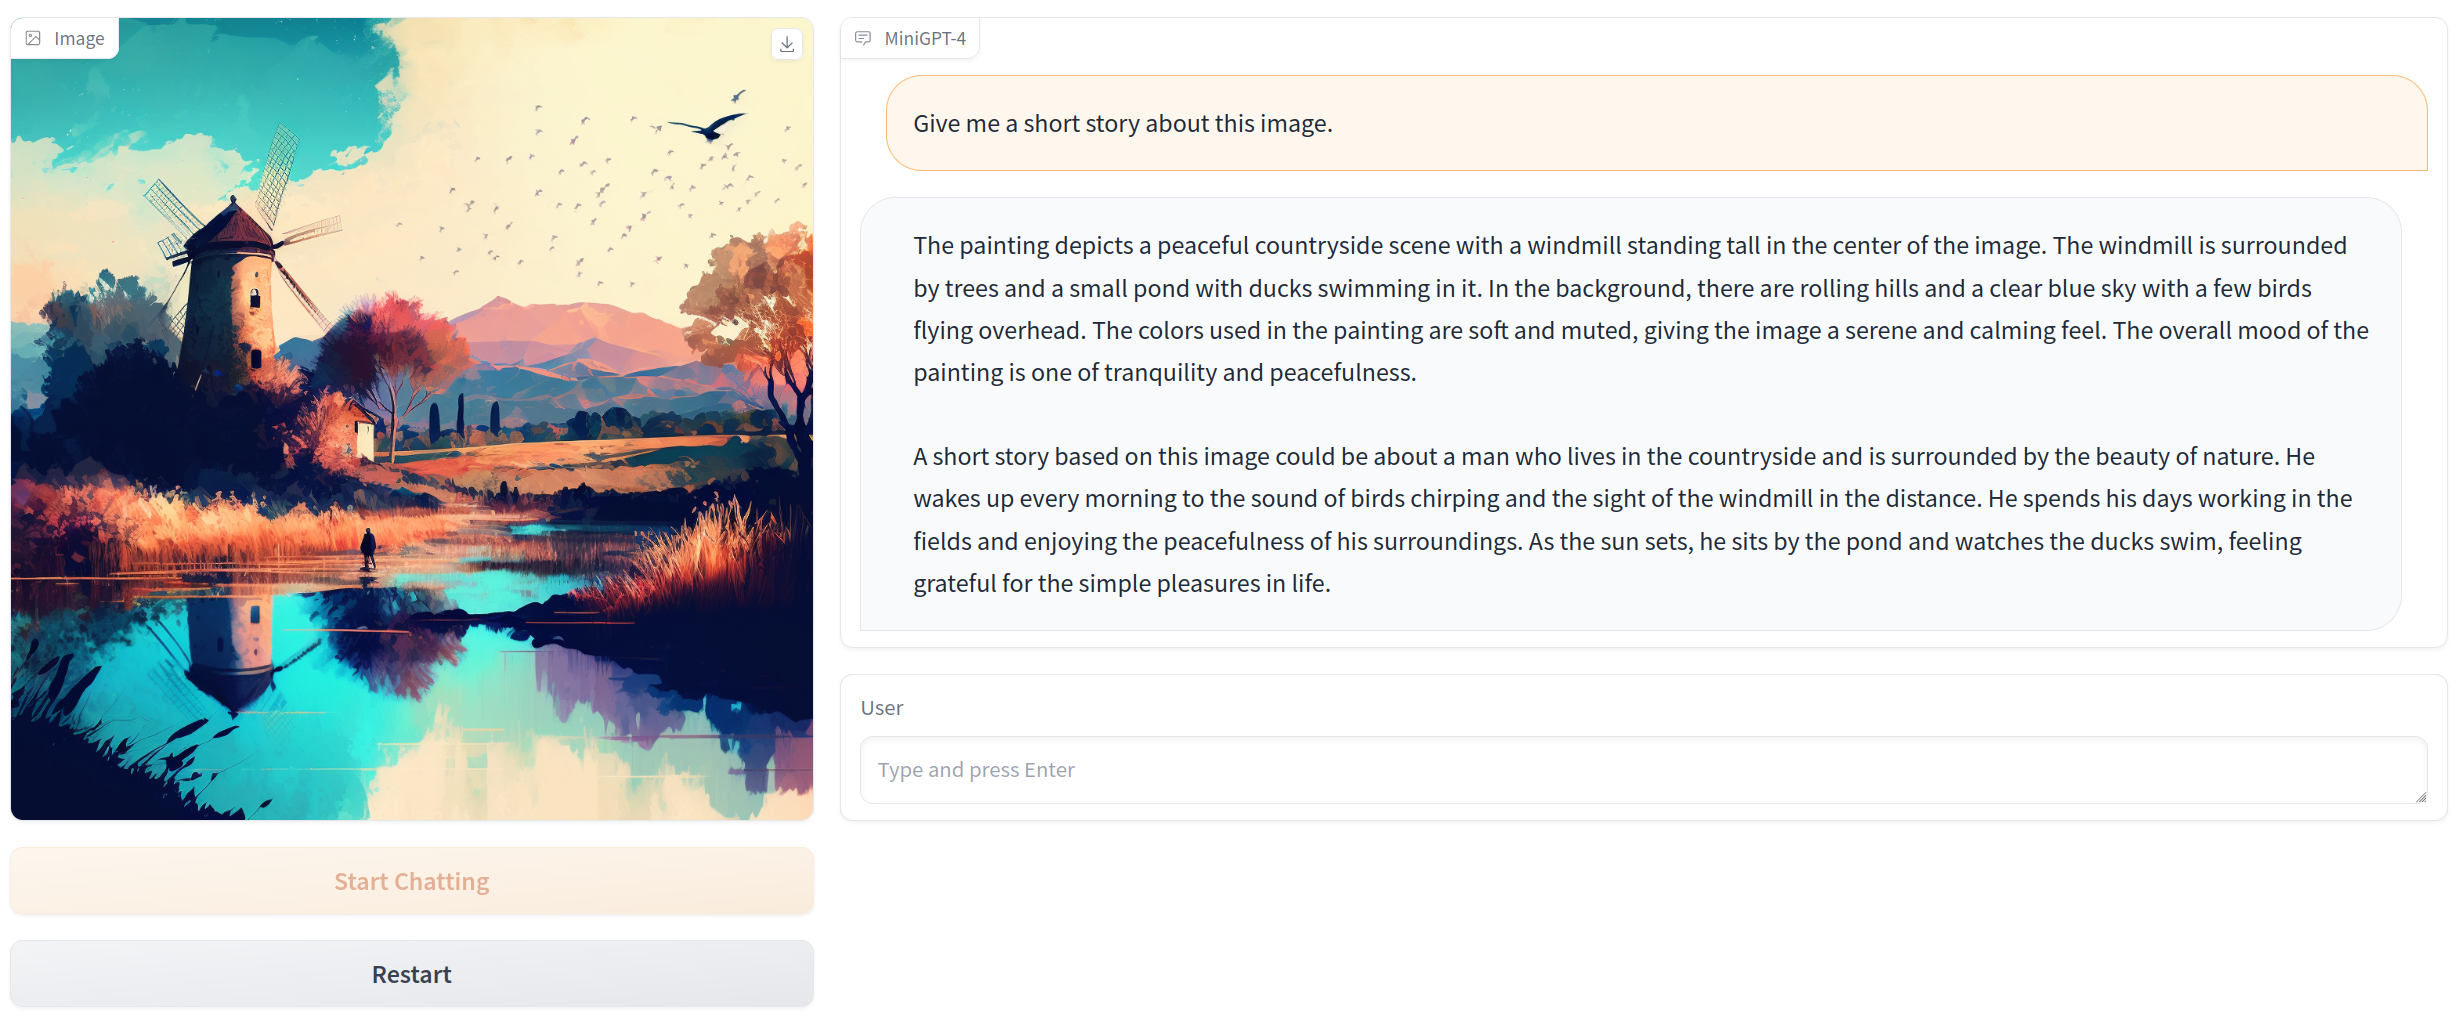
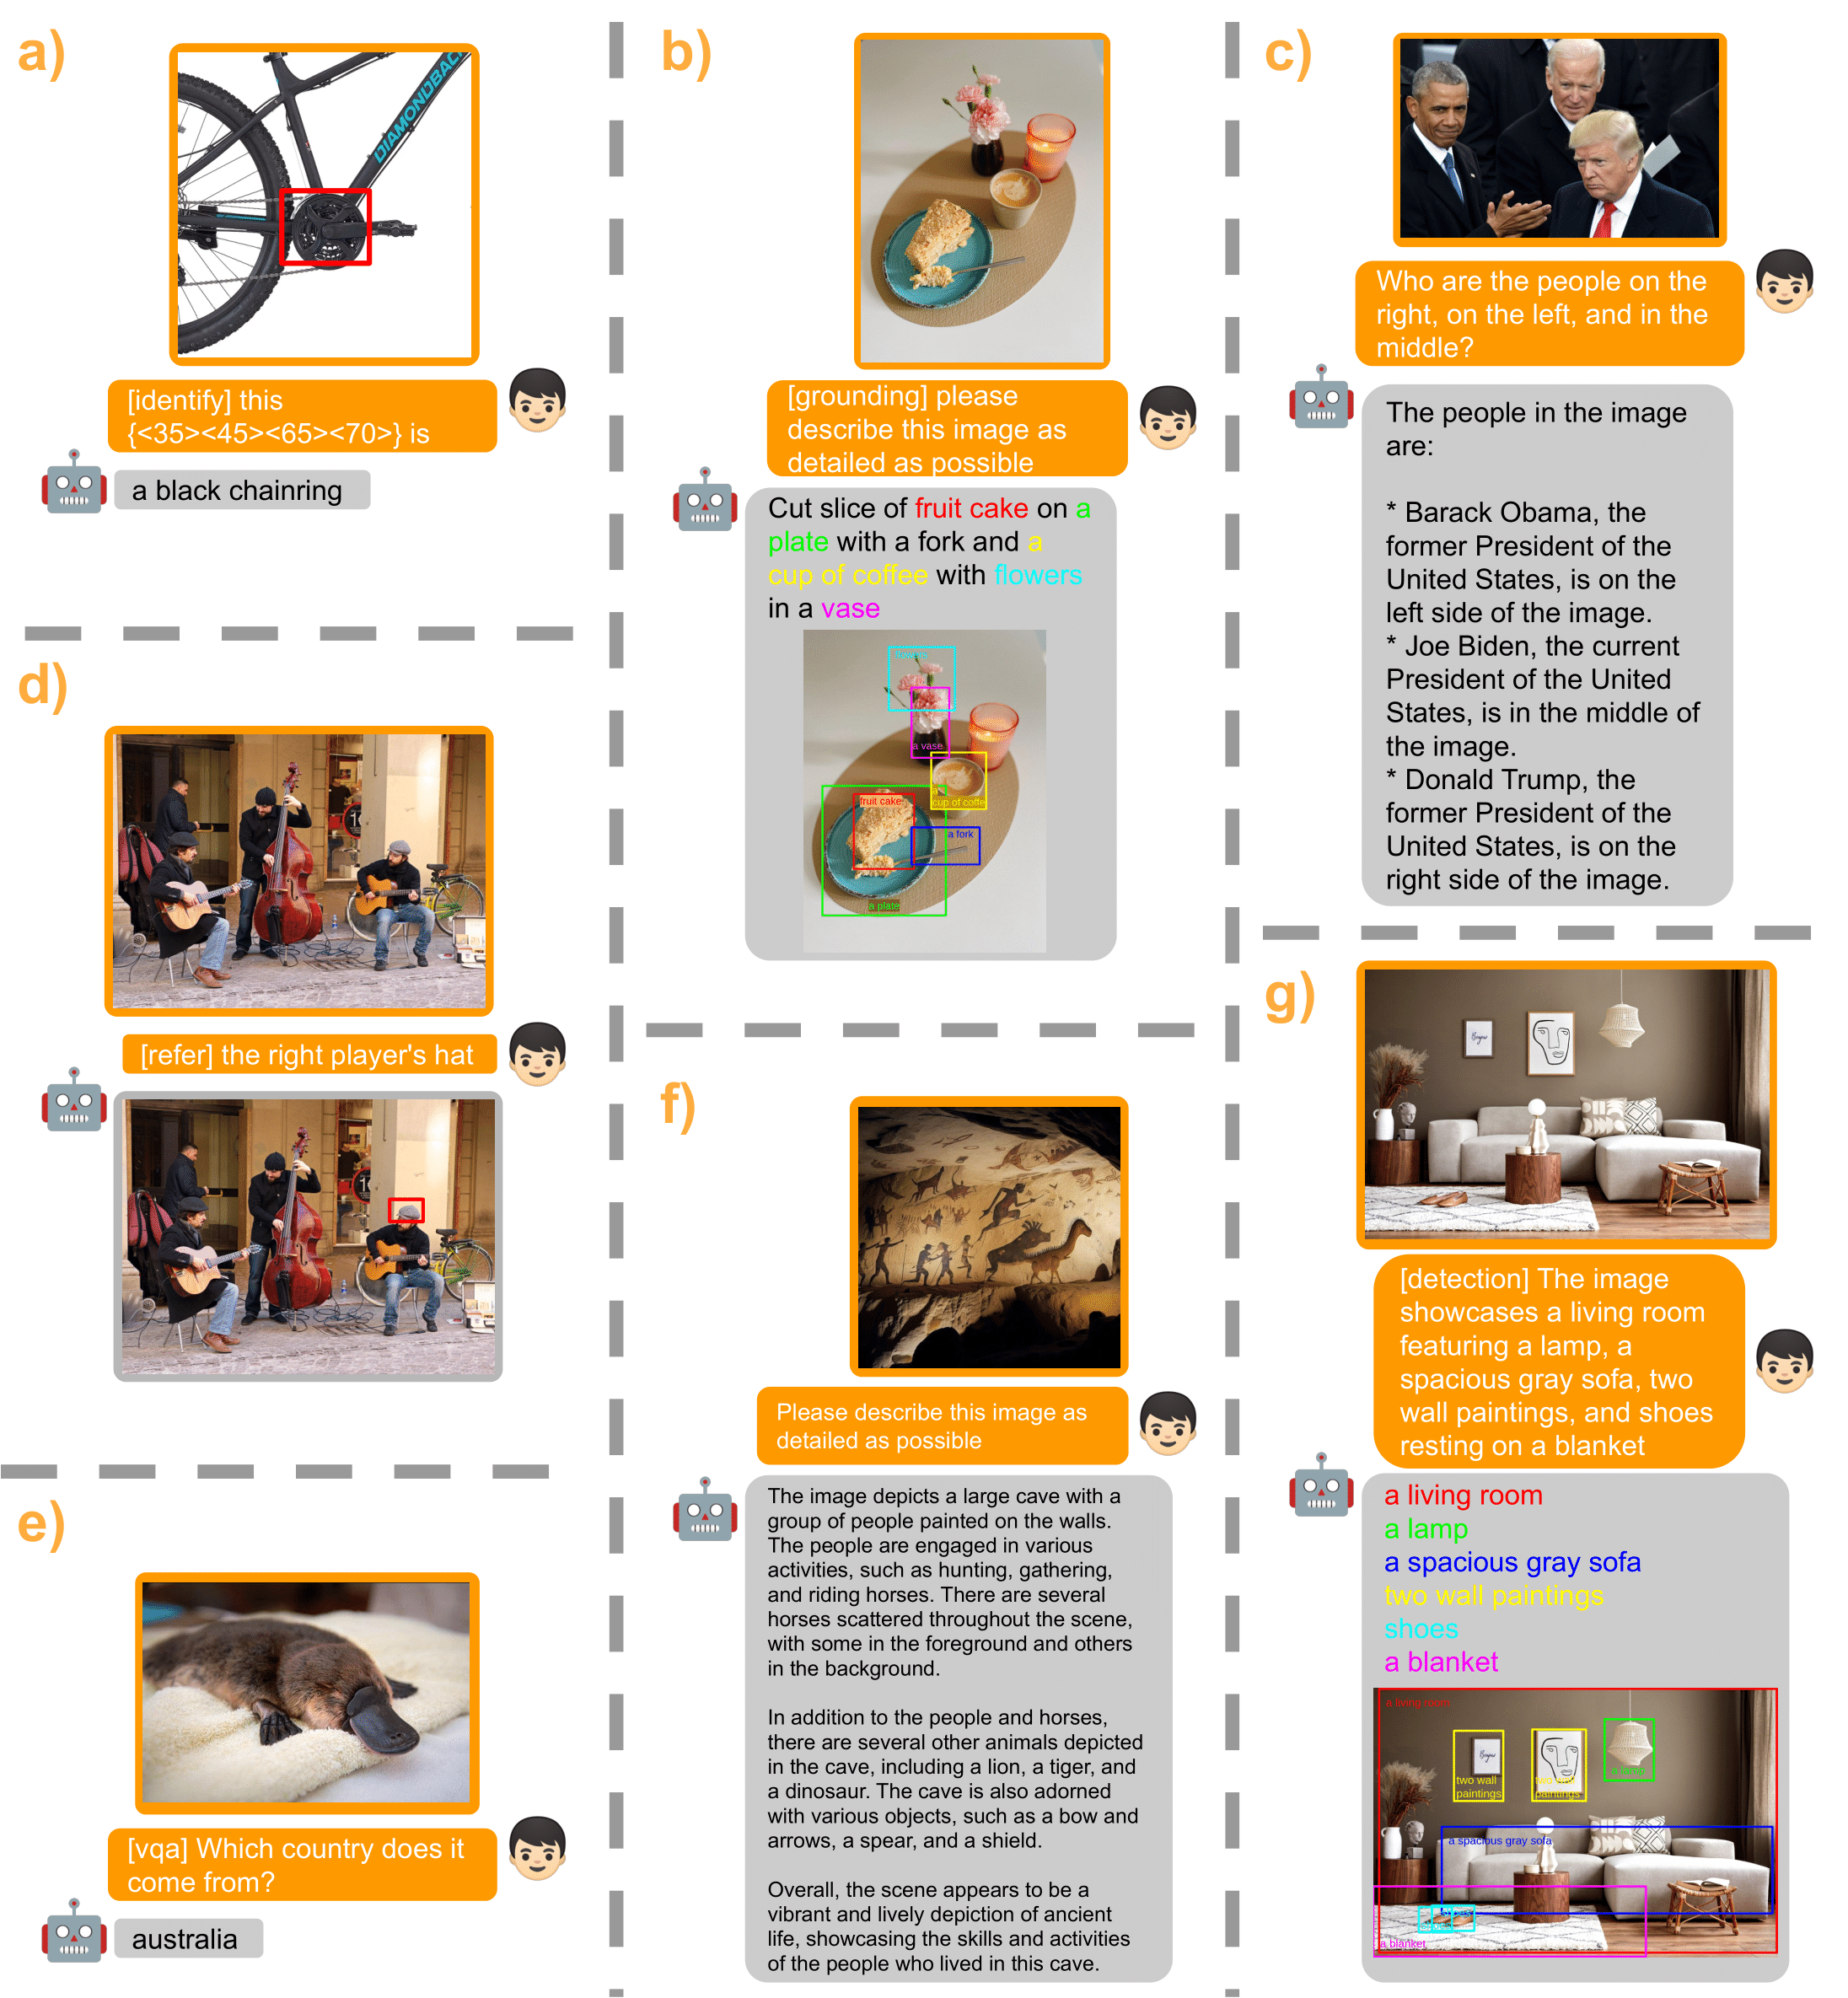
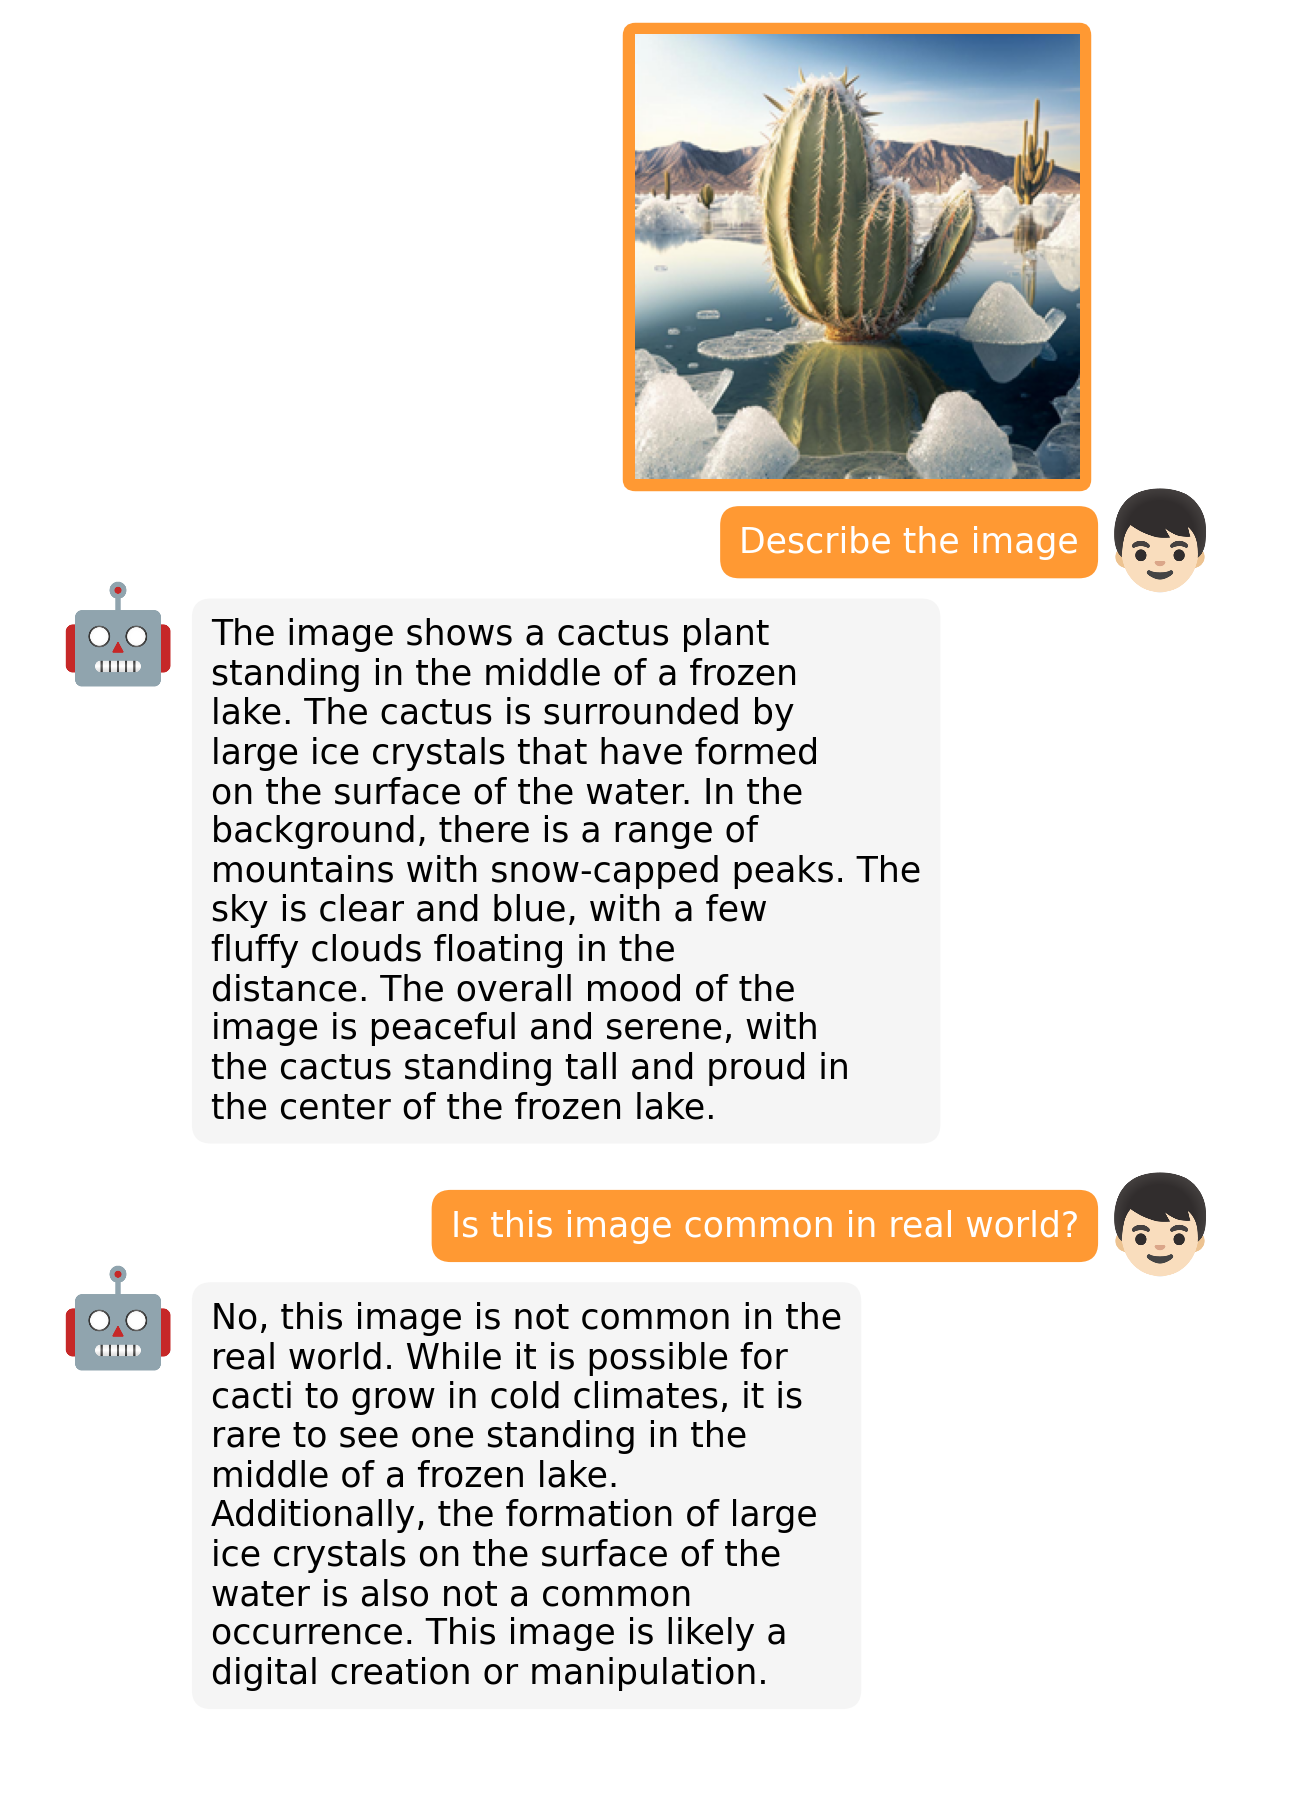
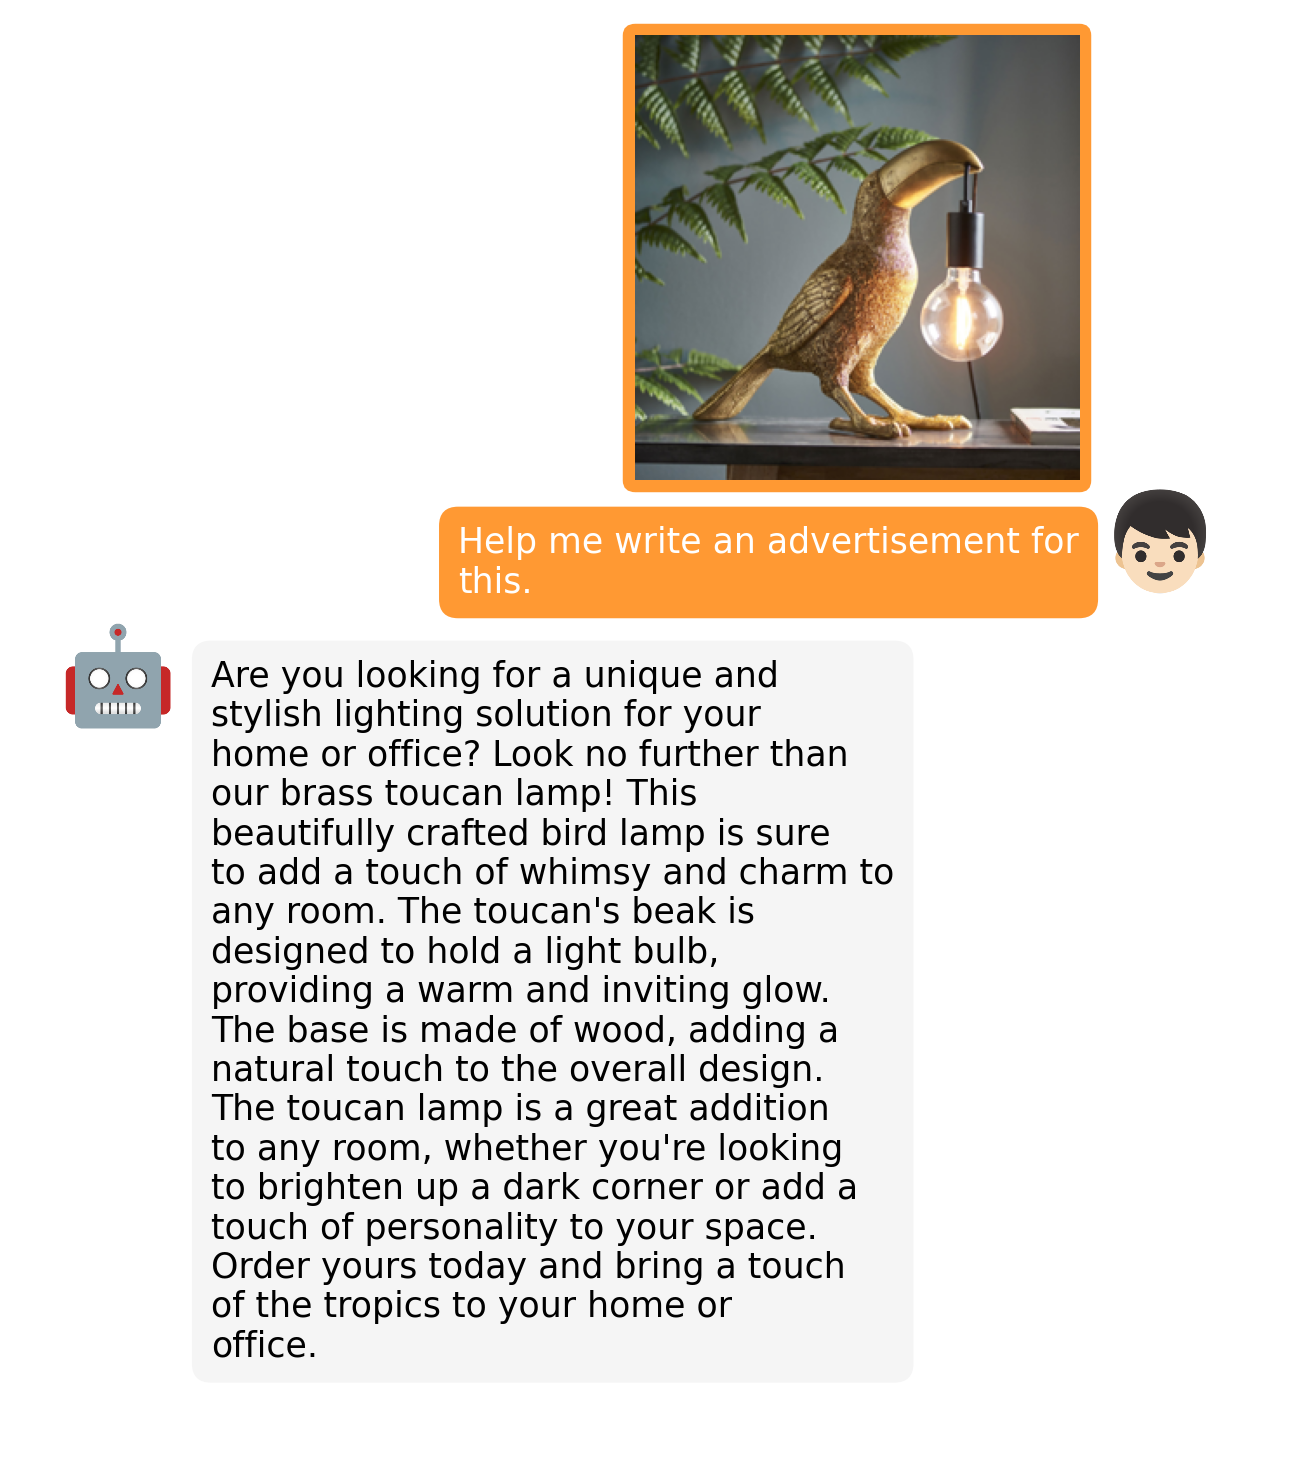
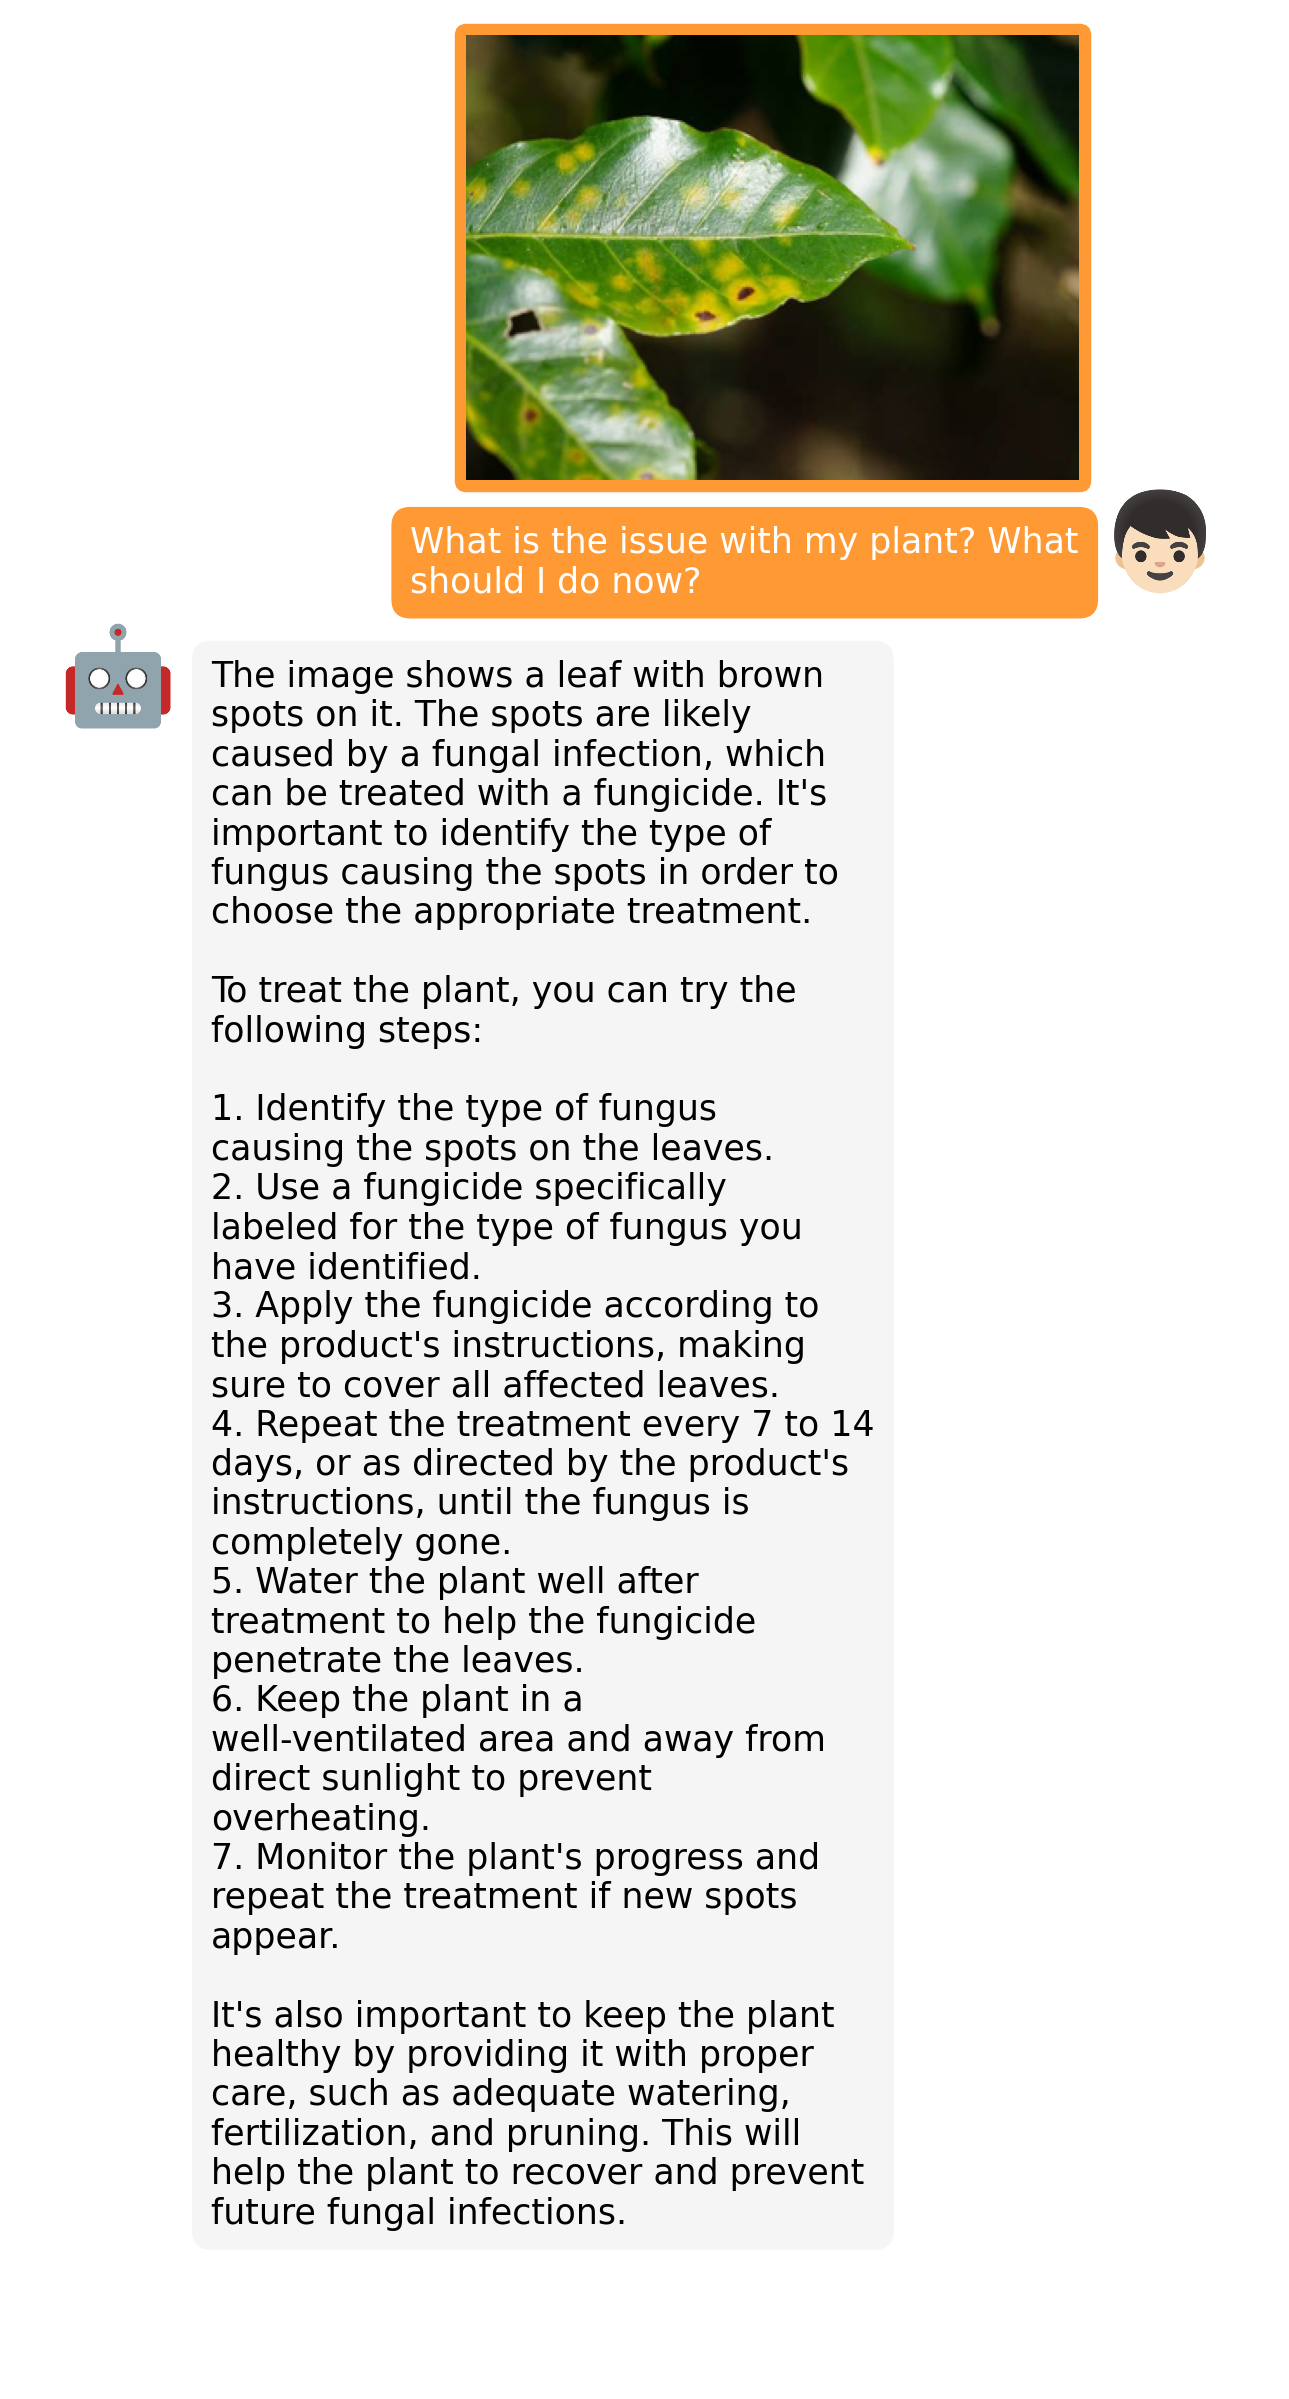
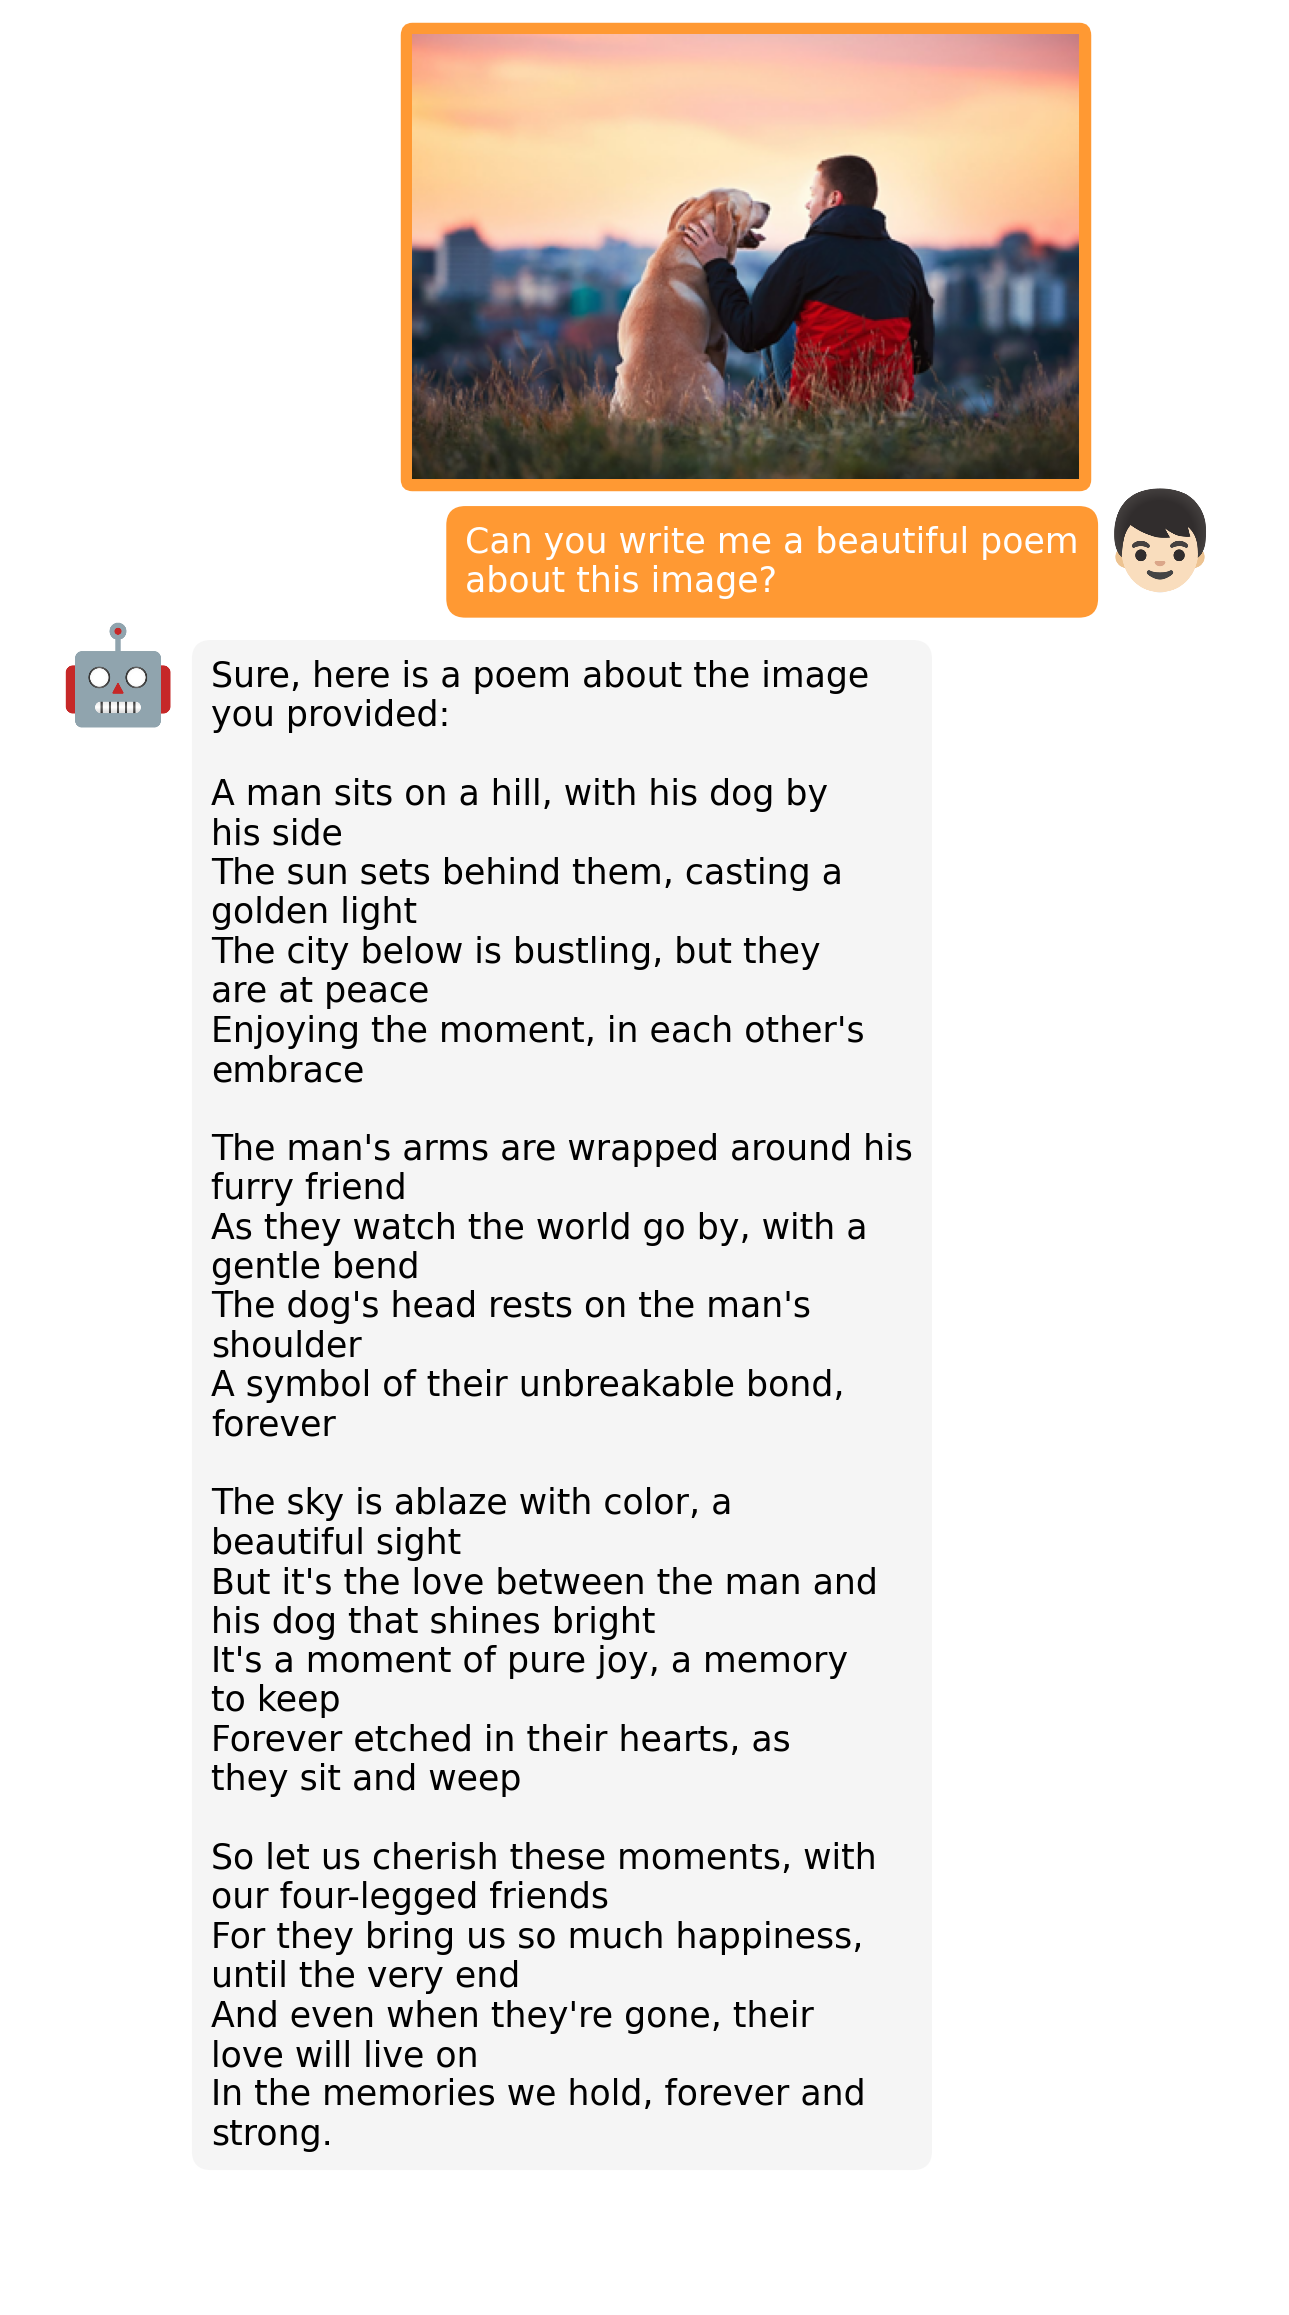
 Это открытый исследовательский код моделей MiniGPT-4 и MiniGPT-v2, двух визуально-языковых моделей, которые используют большую языковую модель как интерфейс для понимания изображений и общения о них.
Это готовое приложение или исследовательский код, который нужно настраивать самому?Это исследовательская кодовая база, а не готовое приложение: нужно клонировать репозиторий, скачать отдельные веса LLM и чекпоинты, отредактировать конфигурационные файлы и самостоятельно запустить локальное демо.
Это исследовательская кодовая база, а не готовое приложение: нужно клонировать репозиторий, скачать отдельные веса LLM и чекпоинты, отредактировать конфигурационные файлы и самостоятельно запустить локальное демо.Как запустить демо локально?Клонируйте репозиторий и создайте окружение Python, скачайте базовые веса LLM (Llama2 Chat 7B или Vicuna V0), скачайте подходящий предобученный чекпоинт MiniGPT, укажите в конфигурационных файлах пути к этим файлам, а затем запустите скрипт демо для MiniGPT-v2 или MiniGPT-4.
Клонируйте репозиторий и создайте окружение Python, скачайте базовые веса LLM (Llama2 Chat 7B или Vicuna V0), скачайте подходящий предобученный чекпоинт MiniGPT, укажите в конфигурационных файлах пути к этим файлам, а затем запустите скрипт демо для MiniGPT-v2 или MiniGPT-4.Какие веса LLM нужны и сколько памяти GPU они занимают?MiniGPT-v2 требует Llama2 Chat 7B; MiniGPT-4 требует либо Vicuna V0 (7B/13B), либо Llama2, которые скачиваются через git-lfs с HuggingFace. При загрузке в 8-битном режиме по умолчанию нужно около 23 ГБ памяти GPU для модели 13B и 11,5 ГБ для модели 7B.
MiniGPT-v2 требует Llama2 Chat 7B; MiniGPT-4 требует либо Vicuna V0 (7B/13B), либо Llama2, которые скачиваются через git-lfs с HuggingFace. При загрузке в 8-битном режиме по умолчанию нужно около 23 ГБ памяти GPU для модели 13B и 11,5 ГБ для модели 7B.Почему нельзя просто скачать одну модель и сразу её запустить?Предобученные веса LLM (Vicuna/Llama2) и чекпоинты MiniGPT распространяются отдельно, их нужно скачать и вручную связать между собой через конфигурационные файлы, прежде чем демо заработает.
Предобученные веса LLM (Vicuna/Llama2) и чекпоинты MiniGPT распространяются отдельно, их нужно скачать и вручную связать между собой через конфигурационные файлы, прежде чем демо заработает.В чём разница между MiniGPT-4 и MiniGPT-v2?MiniGPT-v2 — более новый унифицированный визуально-языковой интерфейс на основе Llama2 Chat 7B для многозадачного обучения, а MiniGPT-4 (более ранняя модель) работает на Vicuna или Llama2 и делает упор на улучшенное визуально-языковое понимание; обе модели созданы одной командой Vision-CAIR.
MiniGPT-v2 — более новый унифицированный визуально-языковой интерфейс на основе Llama2 Chat 7B для многозадачного обучения, а MiniGPT-4 (более ранняя модель) работает на Vicuna или Llama2 и делает упор на улучшенное визуально-языковое понимание; обе модели созданы одной командой Vision-CAIR.На какой архитектуре это построено?Архитектура MiniGPT-4 следует BLIP-2, а вся кодовая база построена на библиотеке Lavis и сочетает визуальный энкодер с языковой моделью Vicuna/Llama2.
Архитектура MiniGPT-4 следует BLIP-2, а вся кодовая база построена на библиотеке Lavis и сочетает визуальный энкодер с языковой моделью Vicuna/Llama2.Можно ли попробовать без установки чего-либо?Да, у обеих моделей есть онлайн-демо: перейдите по ссылкам на страницах проекта, и можно будет пообщаться о своих изображениях без какой-либо настройки.
Да, у обеих моделей есть онлайн-демо: перейдите по ссылкам на страницах проекта, и можно будет пообщаться о своих изображениях без какой-либо настройки.Можно ли как-то уменьшить требования к памяти GPU?Модели по умолчанию загружаются в 8-битном режиме (около 11,5 ГБ для 7B и 23 ГБ для 13B); если у вас более мощный GPU, можно переключить загрузку на 16-битный режим в конфигурации для лучшего качества.
Модели по умолчанию загружаются в 8-битном режиме (около 11,5 ГБ для 7B и 23 ГБ для 13B); если у вас более мощный GPU, можно переключить загрузку на 16-битный режим в конфигурации для лучшего качества.What are similar projects?LAVIS, OraRL, Janus, Valen, ZDTaichu5.0-9B, LongCat-Next, UniVR, LLaDA-Image
LAVIS, OraRL, Janus, Valen, ZDTaichu5.0-9B, LongCat-Next, UniVR, LLaDA-ImageWhich topics is it in?vision-language, demo, model, vlm, vision-language-model, multimodal, academic-research, large-language-models, artificial-intelligence, chatbot, bsd, generative-ai
vision-language, demo, model, vlm, vision-language-model, multimodal, academic-research, large-language-models, artificial-intelligence, chatbot, bsd, generative-ai