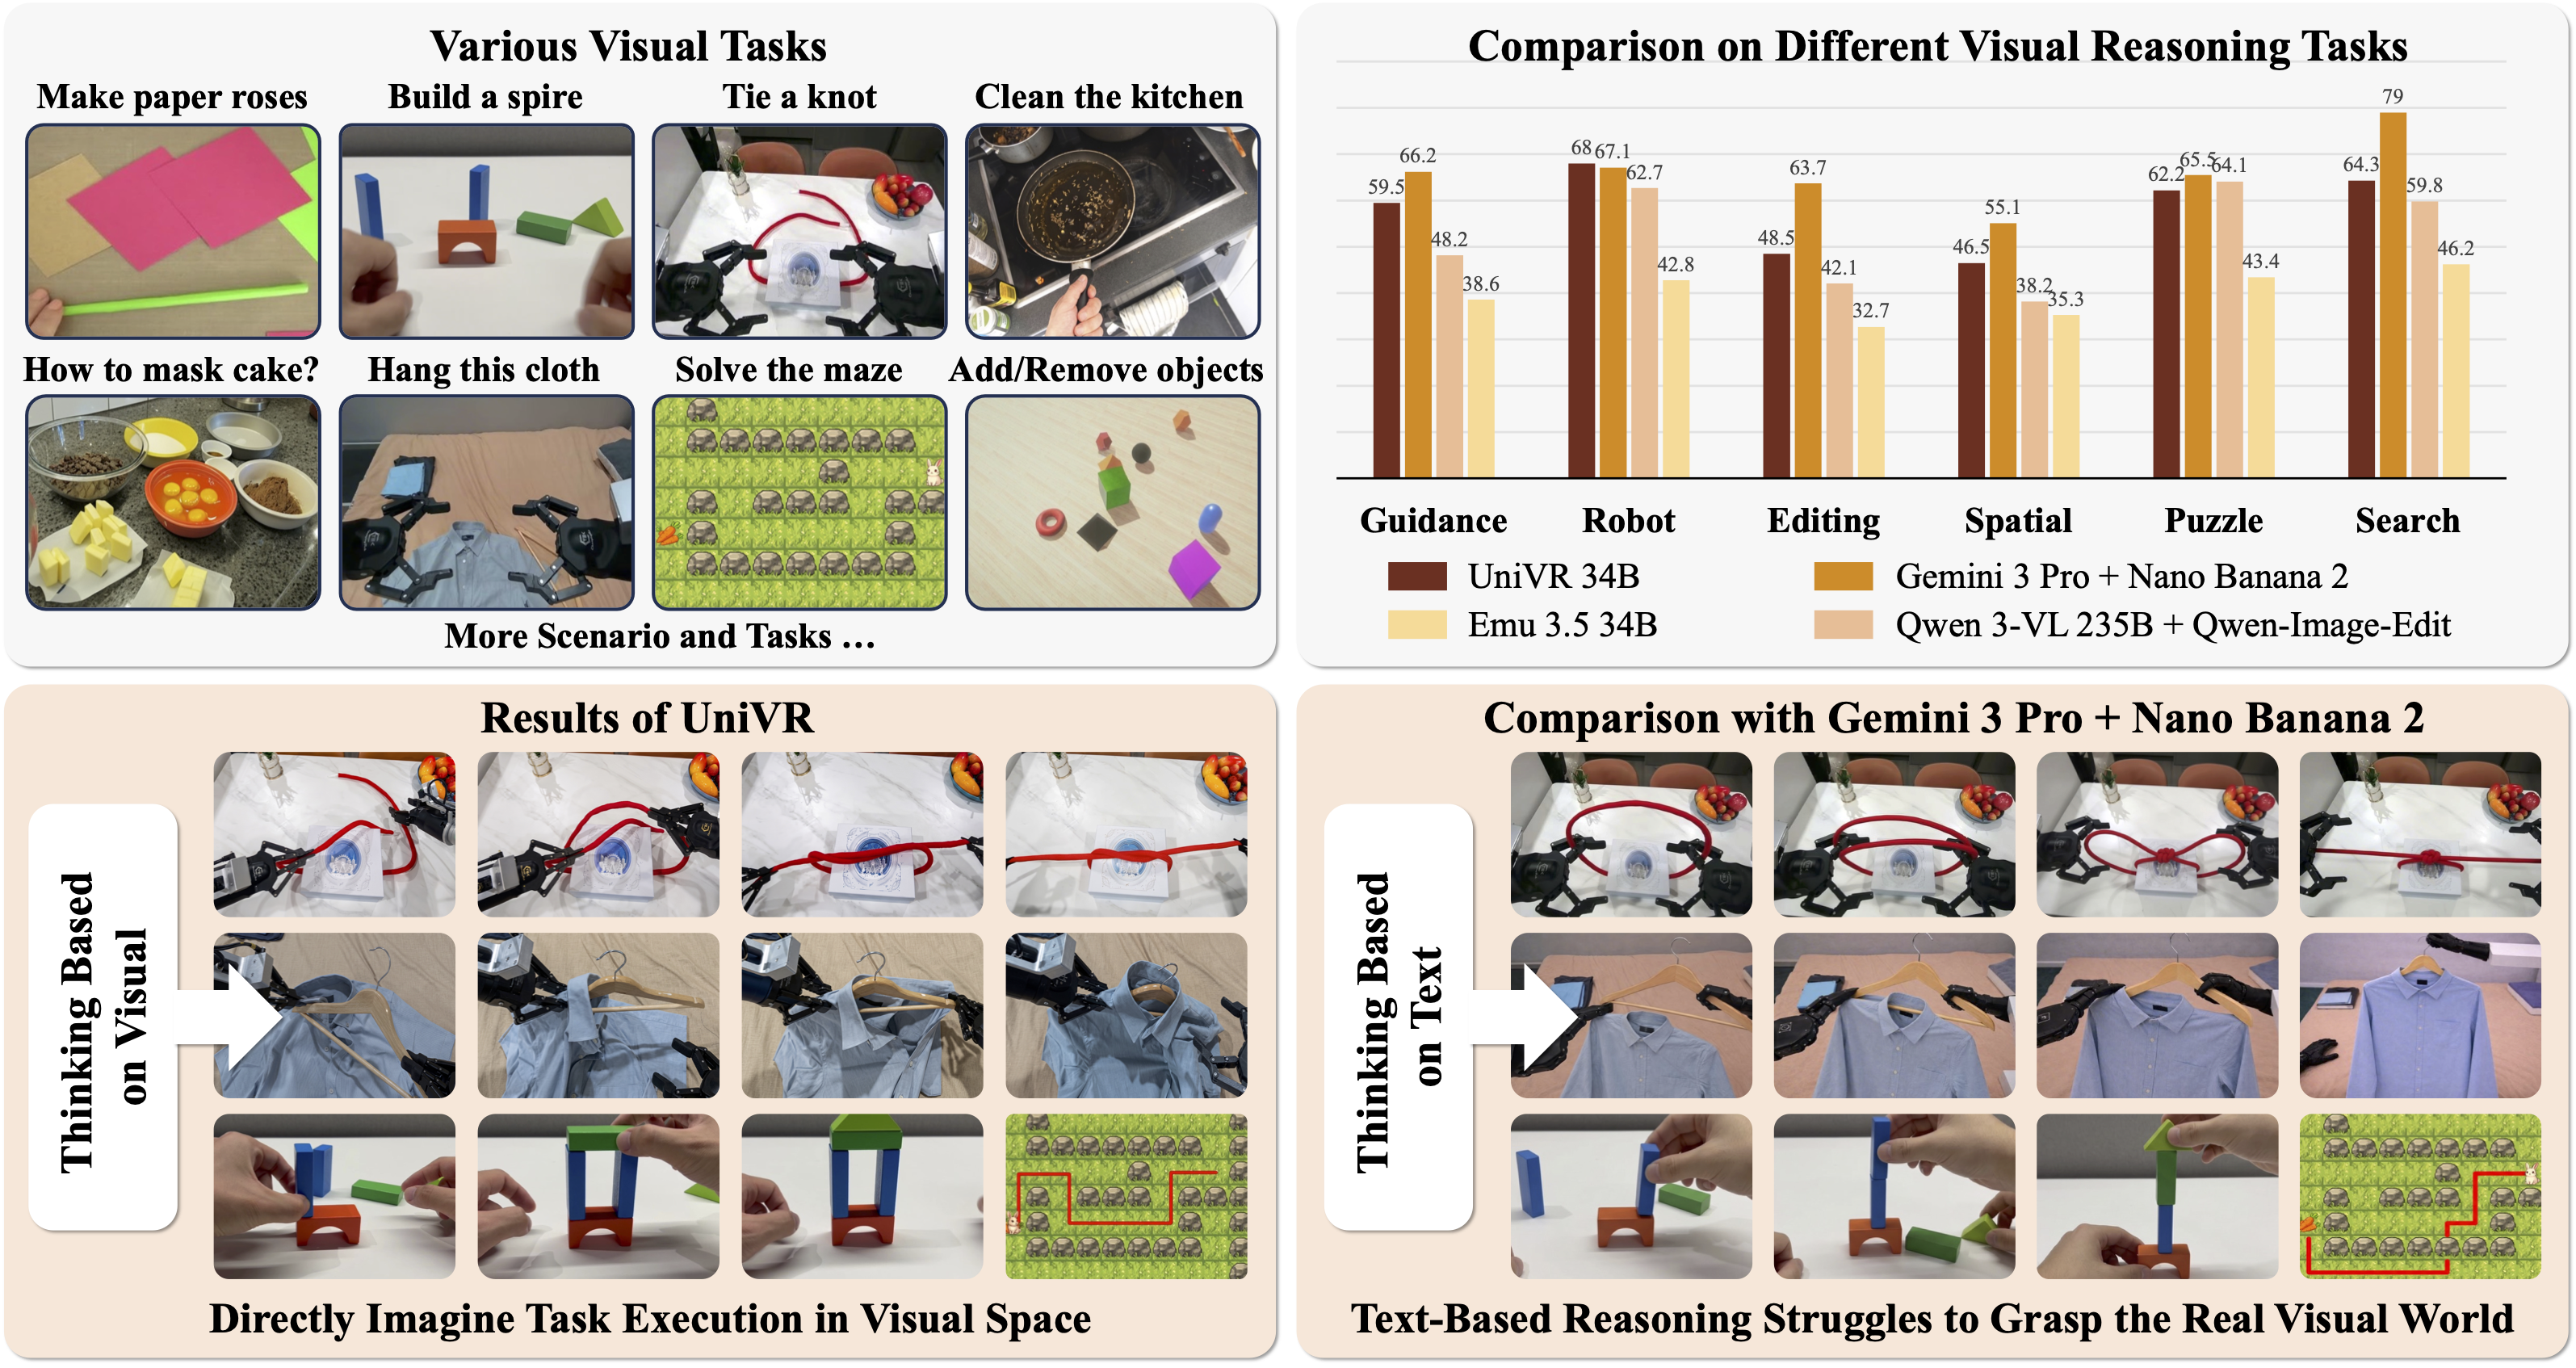
Что это?
 UniVR — сквозной фреймворк обучения SFT и обучения с подкреплением (GRPO), созданный специально для серии унифицированных генеративных моделей Emu3.5: задачи визуального рассуждения можно обучать, подставив свой загрузчик данных и функцию вознаграждения.
Это готовая модель или фреймворк для обучения?Это фреймворк для обучения, а не самостоятельная модель: UniVRSFT отвечает за мультинодовое контролируемое дообучение (LoRA или по всем параметрам), а UniVRRL — за обучение с подкреплением GRPO; оба построены вокруг бэкбона Emu3.5.
Это фреймворк для обучения, а не самостоятельная модель: UniVRSFT отвечает за мультинодовое контролируемое дообучение (LoRA или по всем параметрам), а UniVRRL — за обучение с подкреплением GRPO; оба построены вокруг бэкбона Emu3.5.Как его запустить?Установите зафиксированный стек зависимостей, примените прилагаемые патчи исходников vLLM для Emu3.5, затем используйте quick-start-скрипты из UniVRSFT/README.md или UniVRRL/README.md, чтобы запустить обучение SFT или RL.
Установите зафиксированный стек зависимостей, примените прилагаемые патчи исходников vLLM для Emu3.5, затем используйте quick-start-скрипты из UniVRSFT/README.md или UniVRRL/README.md, чтобы запустить обучение SFT или RL.Нужны ли узлы с несколькими GPU для обучения?Да — примеры quick-start исходят из 2 узлов x 8 GPU для LoRA SFT или 4 узлов x 8 GPU для SFT по всем параметрам, плюс кастомный движок rollout vLLM/verl для стадии RL.
Да — примеры quick-start исходят из 2 узлов x 8 GPU для LoRA SFT или 4 узлов x 8 GPU для SFT по всем параметрам, плюс кастомный движок rollout vLLM/verl для стадии RL.Можно ли подключить любую базовую модель, или всё привязано к Emu3.5?Он жёстко связан с бэкбоном Emu3.5 (34B) — патчи vLLM, HybridEngine и цикл обучения созданы именно под него; заменяются только загрузчик данных (SFT) и функция вознаграждения (RL).
Он жёстко связан с бэкбоном Emu3.5 (34B) — патчи vLLM, HybridEngine и цикл обучения созданы именно под него; заменяются только загрузчик данных (SFT) и функция вознаграждения (RL).Что такое VR-GRPO?VR-GRPO — парадигма RL, которую использует UniVR: она объединяет вознаграждение за формат, глобальное вознаграждение за ответ, оцениваемое VLM, и пошагово-фокусное вознаграждение, нацеленное на самые неопределённые подшаги (они находятся через дисперсию CLIP-признаков), в виде Rreason = Rg - lambda|Rg - Rs|.
VR-GRPO — парадигма RL, которую использует UniVR: она объединяет вознаграждение за формат, глобальное вознаграждение за ответ, оцениваемое VLM, и пошагово-фокусное вознаграждение, нацеленное на самые неопределённые подшаги (они находятся через дисперсию CLIP-признаков), в виде Rreason = Rg - lambda|Rg - Rs|.Что такое бенчмарк VR-X?VR-X — бенчмарк, лежащий в основе UniVR: 1.5 млн сырых сэмплов из 16 разных источников, охватывающих манипуляции, пространственные головоломки и физические рассуждения; 310 тыс. сэмплов идут на SFT cold-start и 3 тыс. отобранных — на RL.
VR-X — бенчмарк, лежащий в основе UniVR: 1.5 млн сырых сэмплов из 16 разных источников, охватывающих манипуляции, пространственные головоломки и физические рассуждения; 310 тыс. сэмплов идут на SFT cold-start и 3 тыс. отобранных — на RL.Зачем репозиторию кастомный vLLM?В репозитории лежат патчи исходников vLLM, включающие быстрый параллельный инференс без CFG для Emu3.5 во время RL rollout — примерно вдвое выше пропускная способность по сравнению со стандартным режимом CFG, — плюс поддержка LoRA для Emu3.5 в vLLM.
В репозитории лежат патчи исходников vLLM, включающие быстрый параллельный инференс без CFG для Emu3.5 во время RL rollout — примерно вдвое выше пропускная способность по сравнению со стандартным режимом CFG, — плюс поддержка LoRA для Emu3.5 в vLLM.Нужны ли модели текстовые метки для каждого шага рассуждения?Нет — она учится визуальному рассуждению прямо на последовательностях изображений, без плотных пар изображение-текст, генерируя будущие кадры авторегрессивно вместо промежуточной текстовой цепочки.
Нет — она учится визуальному рассуждению прямо на последовательностях изображений, без плотных пар изображение-текст, генерируя будущие кадры авторегрессивно вместо промежуточной текстовой цепочки.