What is this?
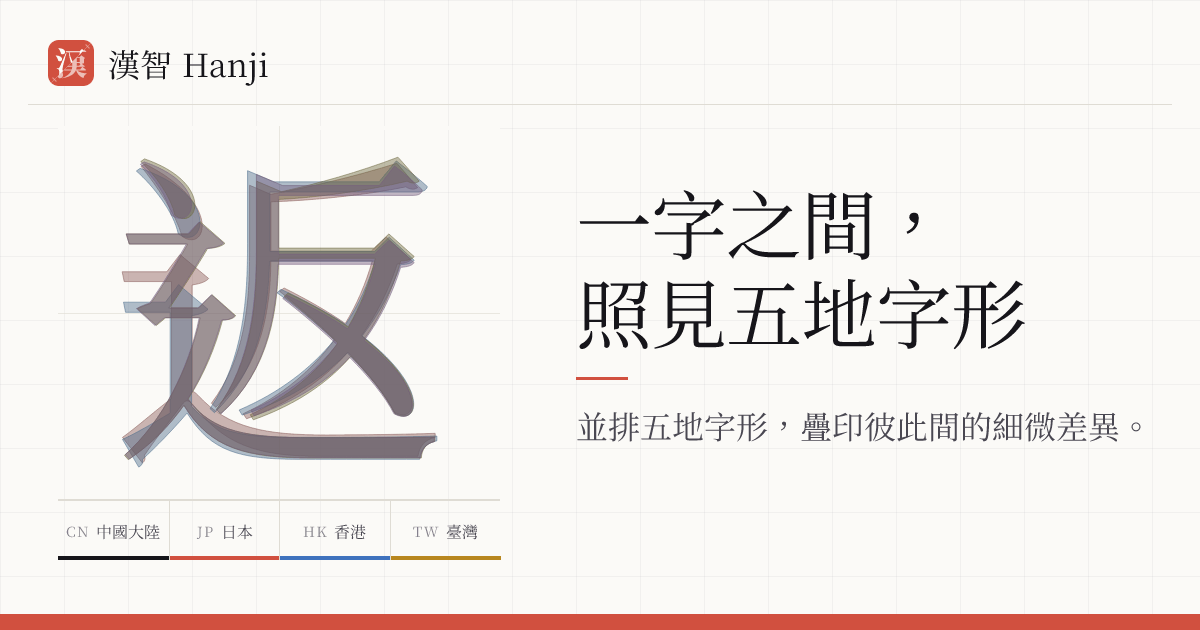
 Hanji is a web tool that lines up and overlays the same Han character's printed glyph form across Mainland China, Hong Kong, Taiwan, Japan, and Korea so you can see the subtle real differences between regional character shapes.
Is this a web app, or something I install like a desktop program?It's a static Nuxt/Vue web app that also works as a PWA; there's nothing to compile to use it, you just open the site, and supported browsers can install it like an app.
It's a static Nuxt/Vue web app that also works as a PWA; there's nothing to compile to use it, you just open the site, and supported browsers can install it like an app.How do I get it running, or deploy my own copy?For regular use, just visit the hosted site. To self-host, it builds to a plain static output: '这是静态应用,.output/public 直接交给任意静态托管即可。' — run pnpm build:data then pnpm generate and serve .output/public anywhere.
For regular use, just visit the hosted site. To self-host, it builds to a plain static output: '这是静态应用,.output/public 直接交给任意静态托管即可。' — run pnpm build:data then pnpm generate and serve .output/public anywhere.Does it capture every kind of glyph difference, like handwriting styles too?No — it only compares the printed black/song typeface forms, so handwriting conventions and textbook model characters are out of scope, and it explicitly says it isn't a substitute for the official regional standards.
No — it only compares the printed black/song typeface forms, so handwriting conventions and textbook model characters are out of scope, and it explicitly says it isn't a substitute for the official regional standards.Can I install it as an app, and does that work on iPhone too?It can be installed as a PWA on Chromium-based browsers via a native install prompt, but iOS and Safari don't expose that install event so there's no install entry point there.
It can be installed as a PWA on Chromium-based browsers via a native install prompt, but iOS and Safari don't expose that install event so there's no install entry point there.Why is it called 'Hanji'?Each region's word for 'Chinese character' (hanzi, kanji, hanja) differs from 'Hanji' by just one letter, mirroring how each place tweaks the same term slightly; it also happens to be the actual Southern Min pronunciation of the characters, so the name isn't invented.
Each region's word for 'Chinese character' (hanzi, kanji, hanja) differs from 'Hanji' by just one letter, mirroring how each place tweaks the same term slightly; it also happens to be the actual Southern Min pronunciation of the characters, so the name isn't invented.How many characters does the dataset actually cover?It covers 8,449 merged character rows drawn from the union of the five regions' standard character lists; 1,692 rows are identical everywhere and 129 rows differ across all five regions.
It covers 8,449 merged character rows drawn from the union of the five regions' standard character lists; 1,692 rows are identical everywhere and 129 rows differ across all five regions.How does Hanji technically decide two regions share the same glyph shape?It compares the Unicode-to-glyph-ID (CID) mappings from Adobe Source Han Sans and Source Han Serif; if either typeface maps two regions to the same CID, they're treated as the same shape, taking the union of both typefaces' results to avoid single-font design quirks.
It compares the Unicode-to-glyph-ID (CID) mappings from Adobe Source Han Sans and Source Han Serif; if either typeface maps two regions to the same CID, they're treated as the same shape, taking the union of both typefaces' results to avoid single-font design quirks.Why is the Korean column off by default?Korea has no character frequency data available, so its column is disabled by default and must be turned on manually in the display options.
Korea has no character frequency data available, so its column is disabled by default and must be turned on manually in the display options.What are similar projects?source-han-sans, LxgwWenKai, smiley-sans, Sarasa-Gothic, chinese-copywriting-guidelines, bulma, plex, simple-icons
source-han-sans, LxgwWenKai, smiley-sans, Sarasa-Gothic, chinese-copywriting-guidelines, bulma, plex, simple-iconsWhich topics is it in?cjk, internationalization, nuxt, static-site, font, cloudflare-workers, localization, typography, pwa, chinese-language, offline-first, dataset
cjk, internationalization, nuxt, static-site, font, cloudflare-workers, localization, typography, pwa, chinese-language, offline-first, dataset