Что это такое?
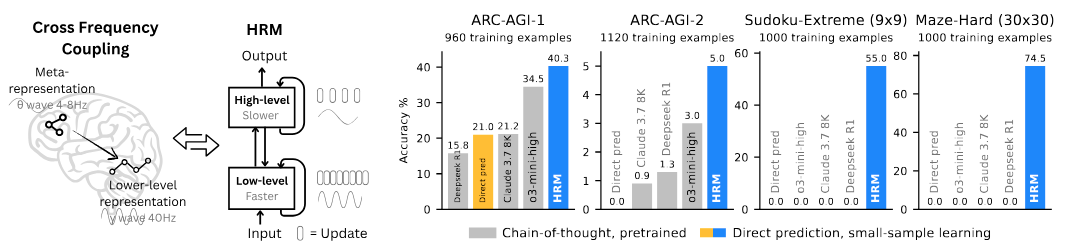
 Официальный релиз иерархической модели рассуждений (Hierarchical Reasoning Model, HRM): рекуррентной архитектуры, вдохновлённой устройством мозга, которая достигает значительной вычислительной глубины всего при 27 миллионах параметров и обучается примерно на 1000 примерах без предобучения и без данных в стиле chain-of-thought.
Это готовая обученная модель или код, который нужно обучать самому?И то, и другое. В репозитории лежит сама архитектура вместе с полным пайплайном обучения, а авторы также выкладывают обученные чекпоинты для ARC-AGI-2, судоку 9x9 Extreme и лабиринтов 30x30 Hard Maze — их можно оценить без какого-либо обучения.
И то, и другое. В репозитории лежит сама архитектура вместе с полным пайплайном обучения, а авторы также выкладывают обученные чекпоинты для ARC-AGI-2, судоку 9x9 Extreme и лабиринтов 30x30 Hard Maze — их можно оценить без какого-либо обучения.Как его запустить?Сначала установите PyTorch с поддержкой CUDA, потому что репозиторий собирает CUDA-расширения; затем добавьте FlashAttention (версия 3 для GPU Hopper, версия 2 для Ampere и старше), установите Python-зависимости и войдите в Weights & Biases для отслеживания обучения.
Сначала установите PyTorch с поддержкой CUDA, потому что репозиторий собирает CUDA-расширения; затем добавьте FlashAttention (версия 3 для GPU Hopper, версия 2 для Ampere и старше), установите Python-зависимости и войдите в Weights & Biases для отслеживания обучения.Сколько длится обучение и какие есть подводные камни?На датасетах из 1 тысячи примеров судоку Extreme обучается примерно за 10 минут на референсной конфигурации из 8 GPU, лабиринт 30x30 — примерно за час, а ARC — примерно за 24 часа. Учтите разброс точности около ±2 пунктов на маленьких выборках, а на Sudoku-Extreme используйте раннюю остановку: на поздних этапах переобучение может дестабилизировать и само обучение, и Q-learning.
На датасетах из 1 тысячи примеров судоку Extreme обучается примерно за 10 минут на референсной конфигурации из 8 GPU, лабиринт 30x30 — примерно за час, а ARC — примерно за 24 часа. Учтите разброс точности около ±2 пунктов на маленьких выборках, а на Sudoku-Extreme используйте раннюю остановку: на поздних этапах переобучение может дестабилизировать и само обучение, и Q-learning.Какое железо нужно для обучения?Нужна GPU от NVIDIA — весь стек построен на PyTorch, CUDA-расширениях и FlashAttention. Демо с судоку обучается примерно за 10 часов на ноутбучной GPU RTX 4070, а полноразмерные эксперименты предполагают конфигурацию из 8 GPU.
Нужна GPU от NVIDIA — весь стек построен на PyTorch, CUDA-расширениях и FlashAttention. Демо с судоку обучается примерно за 10 часов на ноутбучной GPU RTX 4070, а полноразмерные эксперименты предполагают конфигурацию из 8 GPU.Чем это отличается от того, как рассуждают большие языковые модели?Здесь вообще нет текстовых цепочек рассуждений (chain-of-thought): HRM выполняет последовательные рассуждения за один прямой проход через два взаимозависимых рекуррентных модуля — медленный высокоуровневый для абстрактного планирования и быстрый низкоуровневый для детальных вычислений — без какого-либо явного контроля промежуточных шагов.
Здесь вообще нет текстовых цепочек рассуждений (chain-of-thought): HRM выполняет последовательные рассуждения за один прямой проход через два взаимозависимых рекуррентных модуля — медленный высокоуровневый для абстрактного планирования и быстрый низкоуровневый для детальных вычислений — без какого-либо явного контроля промежуточных шагов.Какие задачи он реально решает и насколько хорошо?Из коробки — три головоломных задачи: судоку 9x9 Extreme, лабиринты 30x30 Hard и Abstraction and Reasoning Corpus (ARC), где он превосходит куда более крупные модели с гораздо более длинными контекстными окнами; на судоку и лабиринтах результат почти идеальный.
Из коробки — три головоломных задачи: судоку 9x9 Extreme, лабиринты 30x30 Hard и Abstraction and Reasoning Corpus (ARC), где он превосходит куда более крупные модели с гораздо более длинными контекстными окнами; на судоку и лабиринтах результат почти идеальный.Как проверить, насколько хороша обученная модель?Запустите скрипт оценки и смотрите метрику eval/exactaccuracy в Weights & Biases; для ARC есть дополнительные шаги, а финализировать и просмотреть результаты можно в прилагаемом ноутбуке arceval.ipynb.
Запустите скрипт оценки и смотрите метрику eval/exactaccuracy в Weights & Biases; для ARC есть дополнительные шаги, а финализировать и просмотреть результаты можно в прилагаемом ноутбуке arceval.ipynb.Можно ли самому посмотреть на обучающие головоломки?Да — сгенерируйте датасет, откройте в браузере файл puzzlevisualizer.html и загрузите папку из data/, чтобы разглядывать головоломки наглядно.
Да — сгенерируйте датасет, откройте в браузере файл puzzlevisualizer.html и загрузите папку из data/, чтобы разглядывать головоломки наглядно.What are similar projects?Attention-Residuals, jeeves, mamba, minimind, verl, MSA, EvoVLM, StartLux-Decision
Attention-Residuals, jeeves, mamba, minimind, verl, MSA, EvoVLM, StartLux-DecisionWhich topics is it in?wandb, flash-attention, attention, jupyter, reasoning, gpu-acceleration, reinforcement-learning, neural-network, large-language-models, artificial-intelligence, nvidia, cuda
wandb, flash-attention, attention, jupyter, reasoning, gpu-acceleration, reinforcement-learning, neural-network, large-language-models, artificial-intelligence, nvidia, cuda