



Что это такое?
 Локальная система вопросов и ответов по базе знаний: загружаете в неё свои документы и задаёте вопросы — получаете точные ответы, взятые из ваших файлов, а не из открытого интернета.
Это приложение, которое я разворачиваю сам, или библиотека для кода?Это self-hosted приложение, а не библиотека: одна команда Docker Compose поднимает сервис, которым вы пользуетесь через веб-интерфейс. Есть и API, если захотите встроить его в свой код.
Это self-hosted приложение, а не библиотека: одна команда Docker Compose поднимает сервис, которым вы пользуетесь через веб-интерфейс. Есть и API, если захотите встроить его в свой код.Как его запустить?Склонируйте репозиторий qanything, перейдите в корень проекта и запустите команду старта — в версии v2.0.0 весь стек поднимается одной строкой Docker Compose. Есть и онлайн-демо, чтобы сначала просто попробовать.
Склонируйте репозиторий qanything, перейдите в корень проекта и запустите команду старта — в версии v2.0.0 весь стек поднимается одной строкой Docker Compose. Есть и онлайн-демо, чтобы сначала просто попробовать.Что должно быть установлено заранее?Только Docker. Всё остальное — разбор PDF, OCR, эмбеддинги, rerank — уже внутри стека, причём каждый компонент независим и его можно свободно заменить.
Только Docker. Всё остальное — разбор PDF, OCR, эмбеддинги, rerank — уже внутри стека, причём каждый компонент независим и его можно свободно заменить.Что сейчас не умеет?В версии 2.0 убрали поддержку аудиофайлов — разбор через whisper работал медленно и прожорливо к ресурсам, — а также исчез вывод на несколько GPU. Функция веб-поиска требует VPN.
В версии 2.0 убрали поддержку аудиофайлов — разбор через whisper работал медленно и прожорливо к ресурсам, — а также исчез вывод на несколько GPU. Функция веб-поиска требует VPN.На каких системах работает?Windows, macOS (включая Mac на чипах серии M) и Linux. Версия 2.0.0 — первая, которая запускается на Windows напрямую, без WSL.
Windows, macOS (включая Mac на чипах серии M) и Linux. Версия 2.0.0 — первая, которая запускается на Windows напрямую, без WSL.Можно пользоваться без интернета?Да — офлайн-режим официально поддерживается в v2.0.0 (в старом варианте на Python его не было). Интернет нужен только для необязательной функции веб-поиска.
Да — офлайн-режим официально поддерживается в v2.0.0 (в старом варианте на Python его не было). Интернет нужен только для необязательной функции веб-поиска.Мои данные остаются на моём компьютере?Да — безопасность данных заявлена как ключевая особенность: вся система рассчитана на установку и использование с отключённым сетевым кабелем, так что ваши документы не покидают ваш компьютер.
Да — безопасность данных заявлена как ключевая особенность: вся система рассчитана на установку и использование с отключённым сетевым кабелем, так что ваши документы не покидают ваш компьютер.Есть ли подвох в лицензии для коммерческого использования?Код — под AGPL-3.0. Также учтите: открытая версия построена на дообученной модели QwenLM, и коммерческое использование этой модели должно соответствовать собственной лицензии QwenLM.
Код — под AGPL-3.0. Также учтите: открытая версия построена на дообученной модели QwenLM, и коммерческое использование этой модели должно соответствовать собственной лицензии QwenLM.По каким типам файлов можно задавать вопросы?PDF, Word (docx), PPT (pptx), Excel (xlsx), Markdown, письма (eml), TXT, картинки (jpg/jpeg/png), CSV и веб-ссылки (html), список продолжает пополняться. Вопросы и ответы работают и между языками: можно спросить по-английски о файлах на китайском и наоборот — независимо от языка файла.
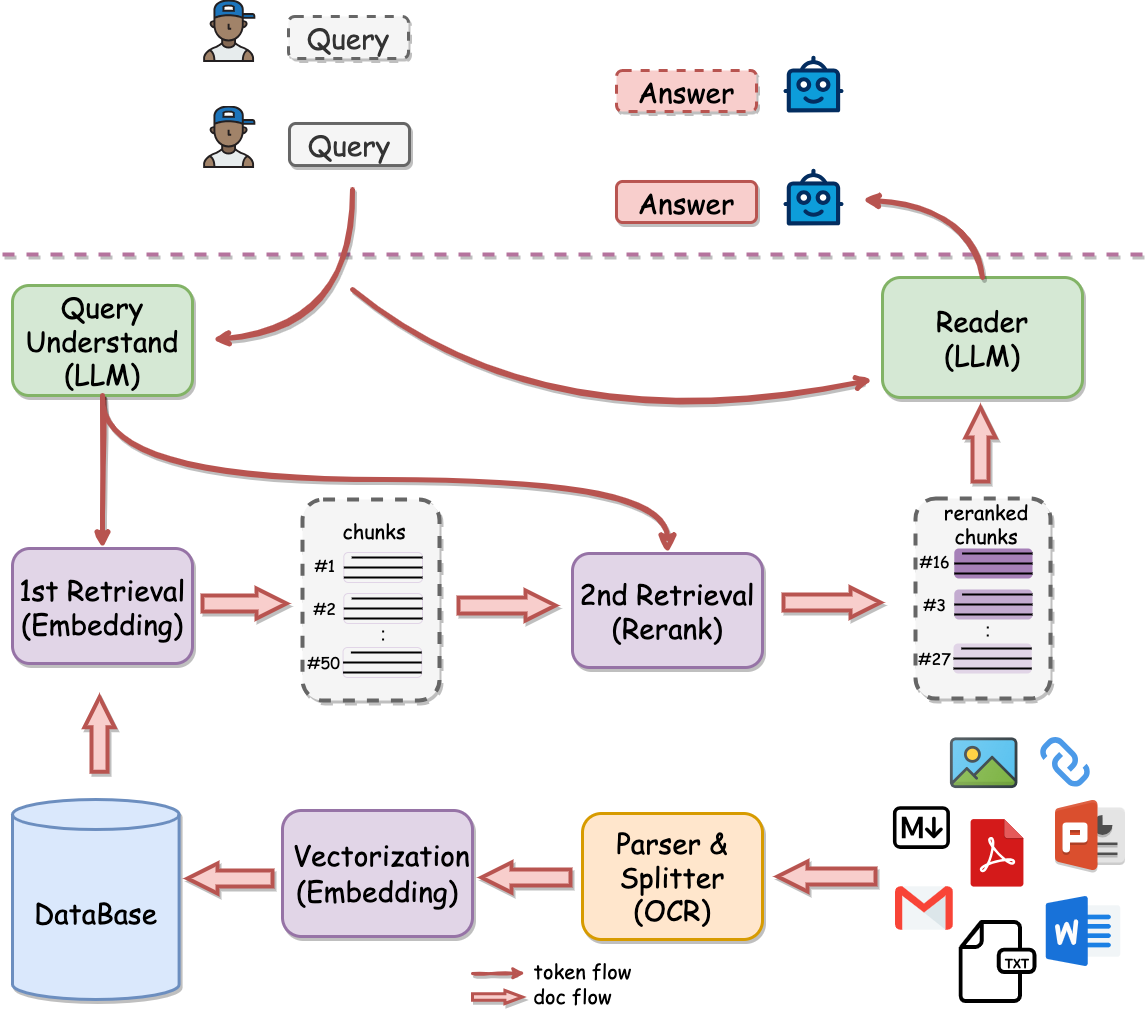
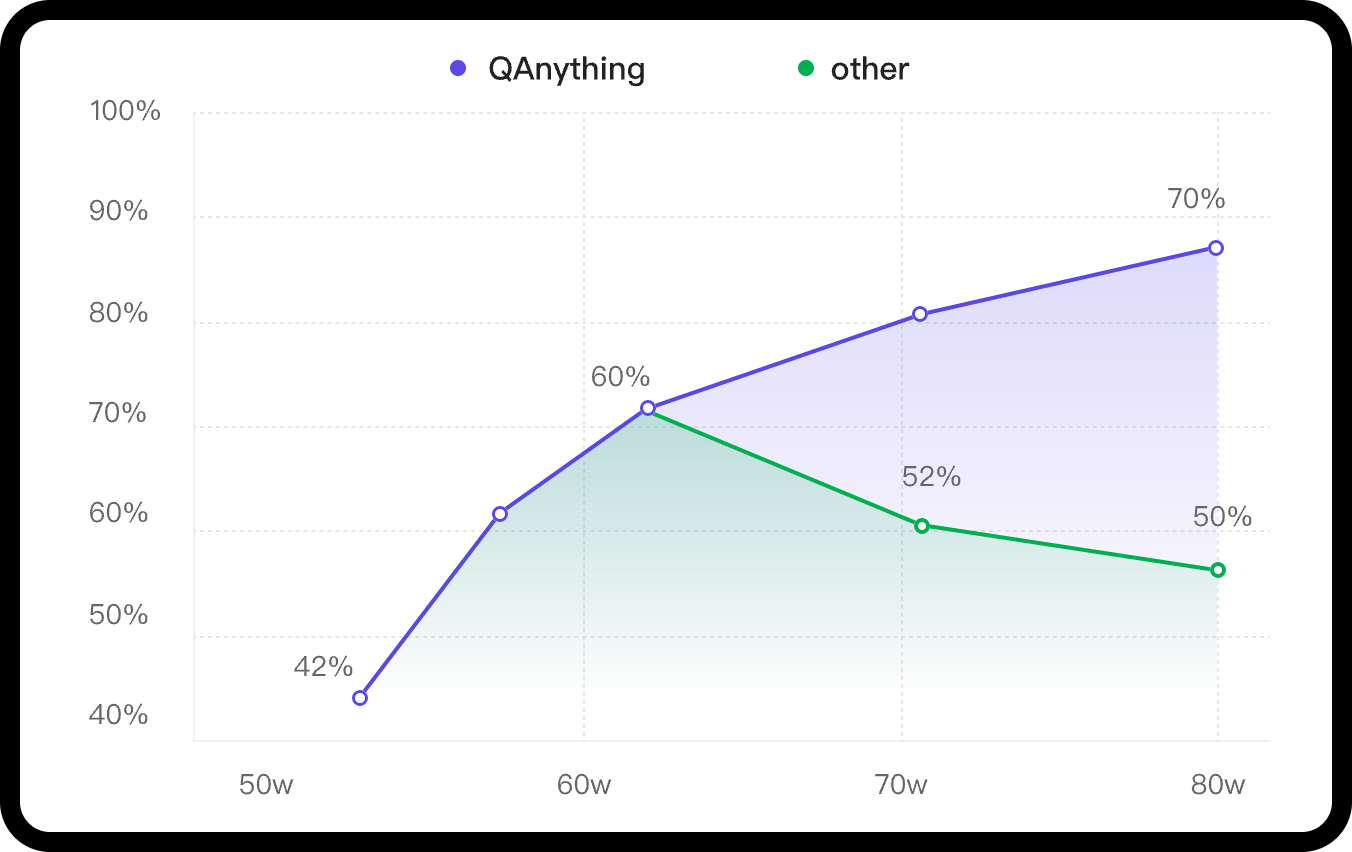
PDF, Word (docx), PPT (pptx), Excel (xlsx), Markdown, письма (eml), TXT, картинки (jpg/jpeg/png), CSV и веб-ссылки (html), список продолжает пополняться. Вопросы и ответы работают и между языками: можно спросить по-английски о файлах на китайском и наоборот — независимо от языка файла.Ответы останутся точными, когда база знаний вырастет до тысяч файлов?Да — именно эту задачу и решает архитектура. Двухэтапный конвейер (поиск по эмбеддингам плюс reranker) держит точность на подъёме по мере роста данных, тогда как одностадийный поиск по эмбеддингам деградирует. Ограничений на количество загруженных файлов нет, а поиск остаётся быстрым благодаря моделям BCEmbedding от команды проекта.
Да — именно эту задачу и решает архитектура. Двухэтапный конвейер (поиск по эмбеддингам плюс reranker) держит точность на подъёме по мере роста данных, тогда как одностадийный поиск по эмбеддингам деградирует. Ограничений на количество загруженных файлов нет, а поиск остаётся быстрым благодаря моделям BCEmbedding от команды проекта.В комплекте идёт своя ИИ-модель?Уже нет. В версии 2.0.0 убрали локальную LLM по умолчанию: всё подключается через OpenAI-совместимый интерфейс, настраиваемый в параметрах веб-интерфейса, — так что можно подключить любой OpenAI-совместимый сервис или запустить локальную модель через инструменты вроде ollama.
Уже нет. В версии 2.0.0 убрали локальную LLM по умолчанию: всё подключается через OpenAI-совместимый интерфейс, настраиваемый в параметрах веб-интерфейса, — так что можно подключить любой OpenAI-совместимый сервис или запустить локальную модель через инструменты вроде ollama.Что он умеет из коробки, кроме общения с моими файлами?Быстрый чат в стиле Kimi без подключённых файлов, режим «только поиск» и собственные боты. Версия 2.0 добавила FAQ-записи, гибридный поиск BM25+embedding, онлайн-просмотр и редактирование чанков, предпросмотр с отслеживанием исходных файлов и поиск по логам.
Быстрый чат в стиле Kimi без подключённых файлов, режим «только поиск» и собственные боты. Версия 2.0 добавила FAQ-записи, гибридный поиск BM25+embedding, онлайн-просмотр и редактирование чанков, предпросмотр с отслеживанием исходных файлов и поиск по логам.What are similar projects?LightRAG, WeKnora, vault-ai, utopia, kotaemon, production-agentic-rag-course, m_flow, khoj
LightRAG, WeKnora, vault-ai, utopia, kotaemon, production-agentic-rag-course, m_flow, khojWhich topics is it in?question-answering, vector-search, offline-first, semantic-search, embeddings, document-processing, openai-compatible, local-llm, knowledge-base, agpl, chatbot, rag
question-answering, vector-search, offline-first, semantic-search, embeddings, document-processing, openai-compatible, local-llm, knowledge-base, agpl, chatbot, rag