





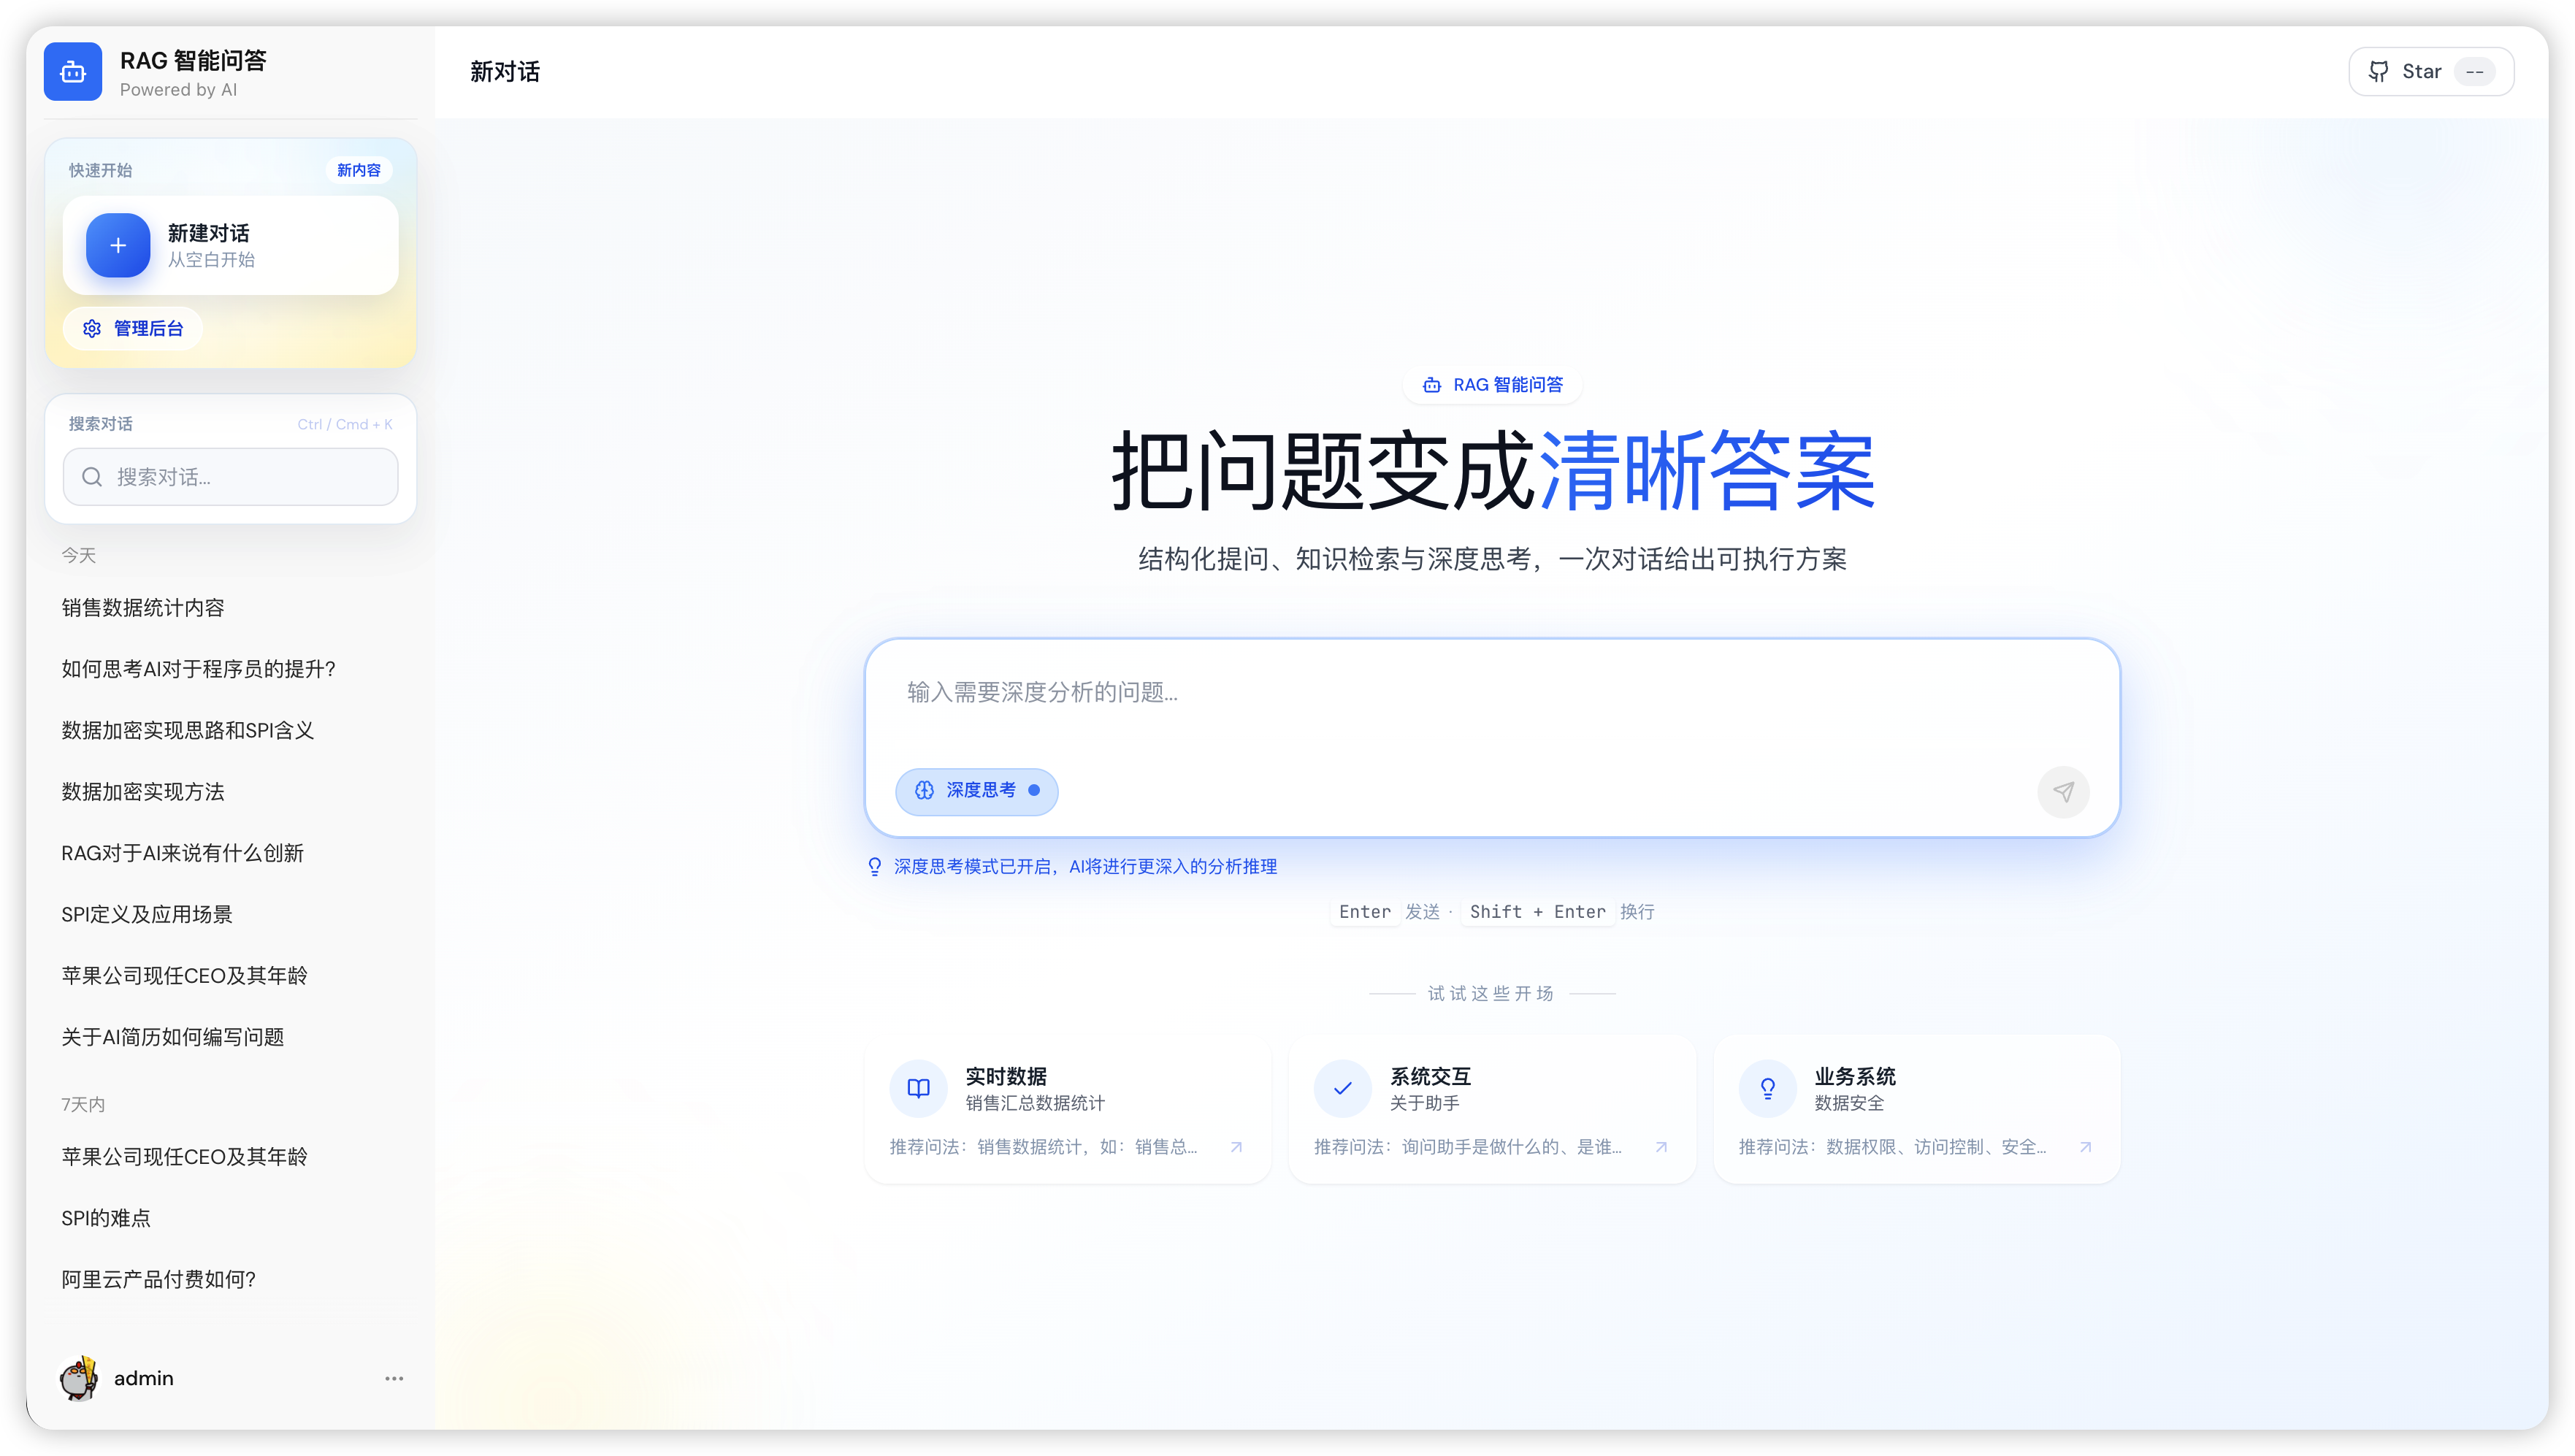
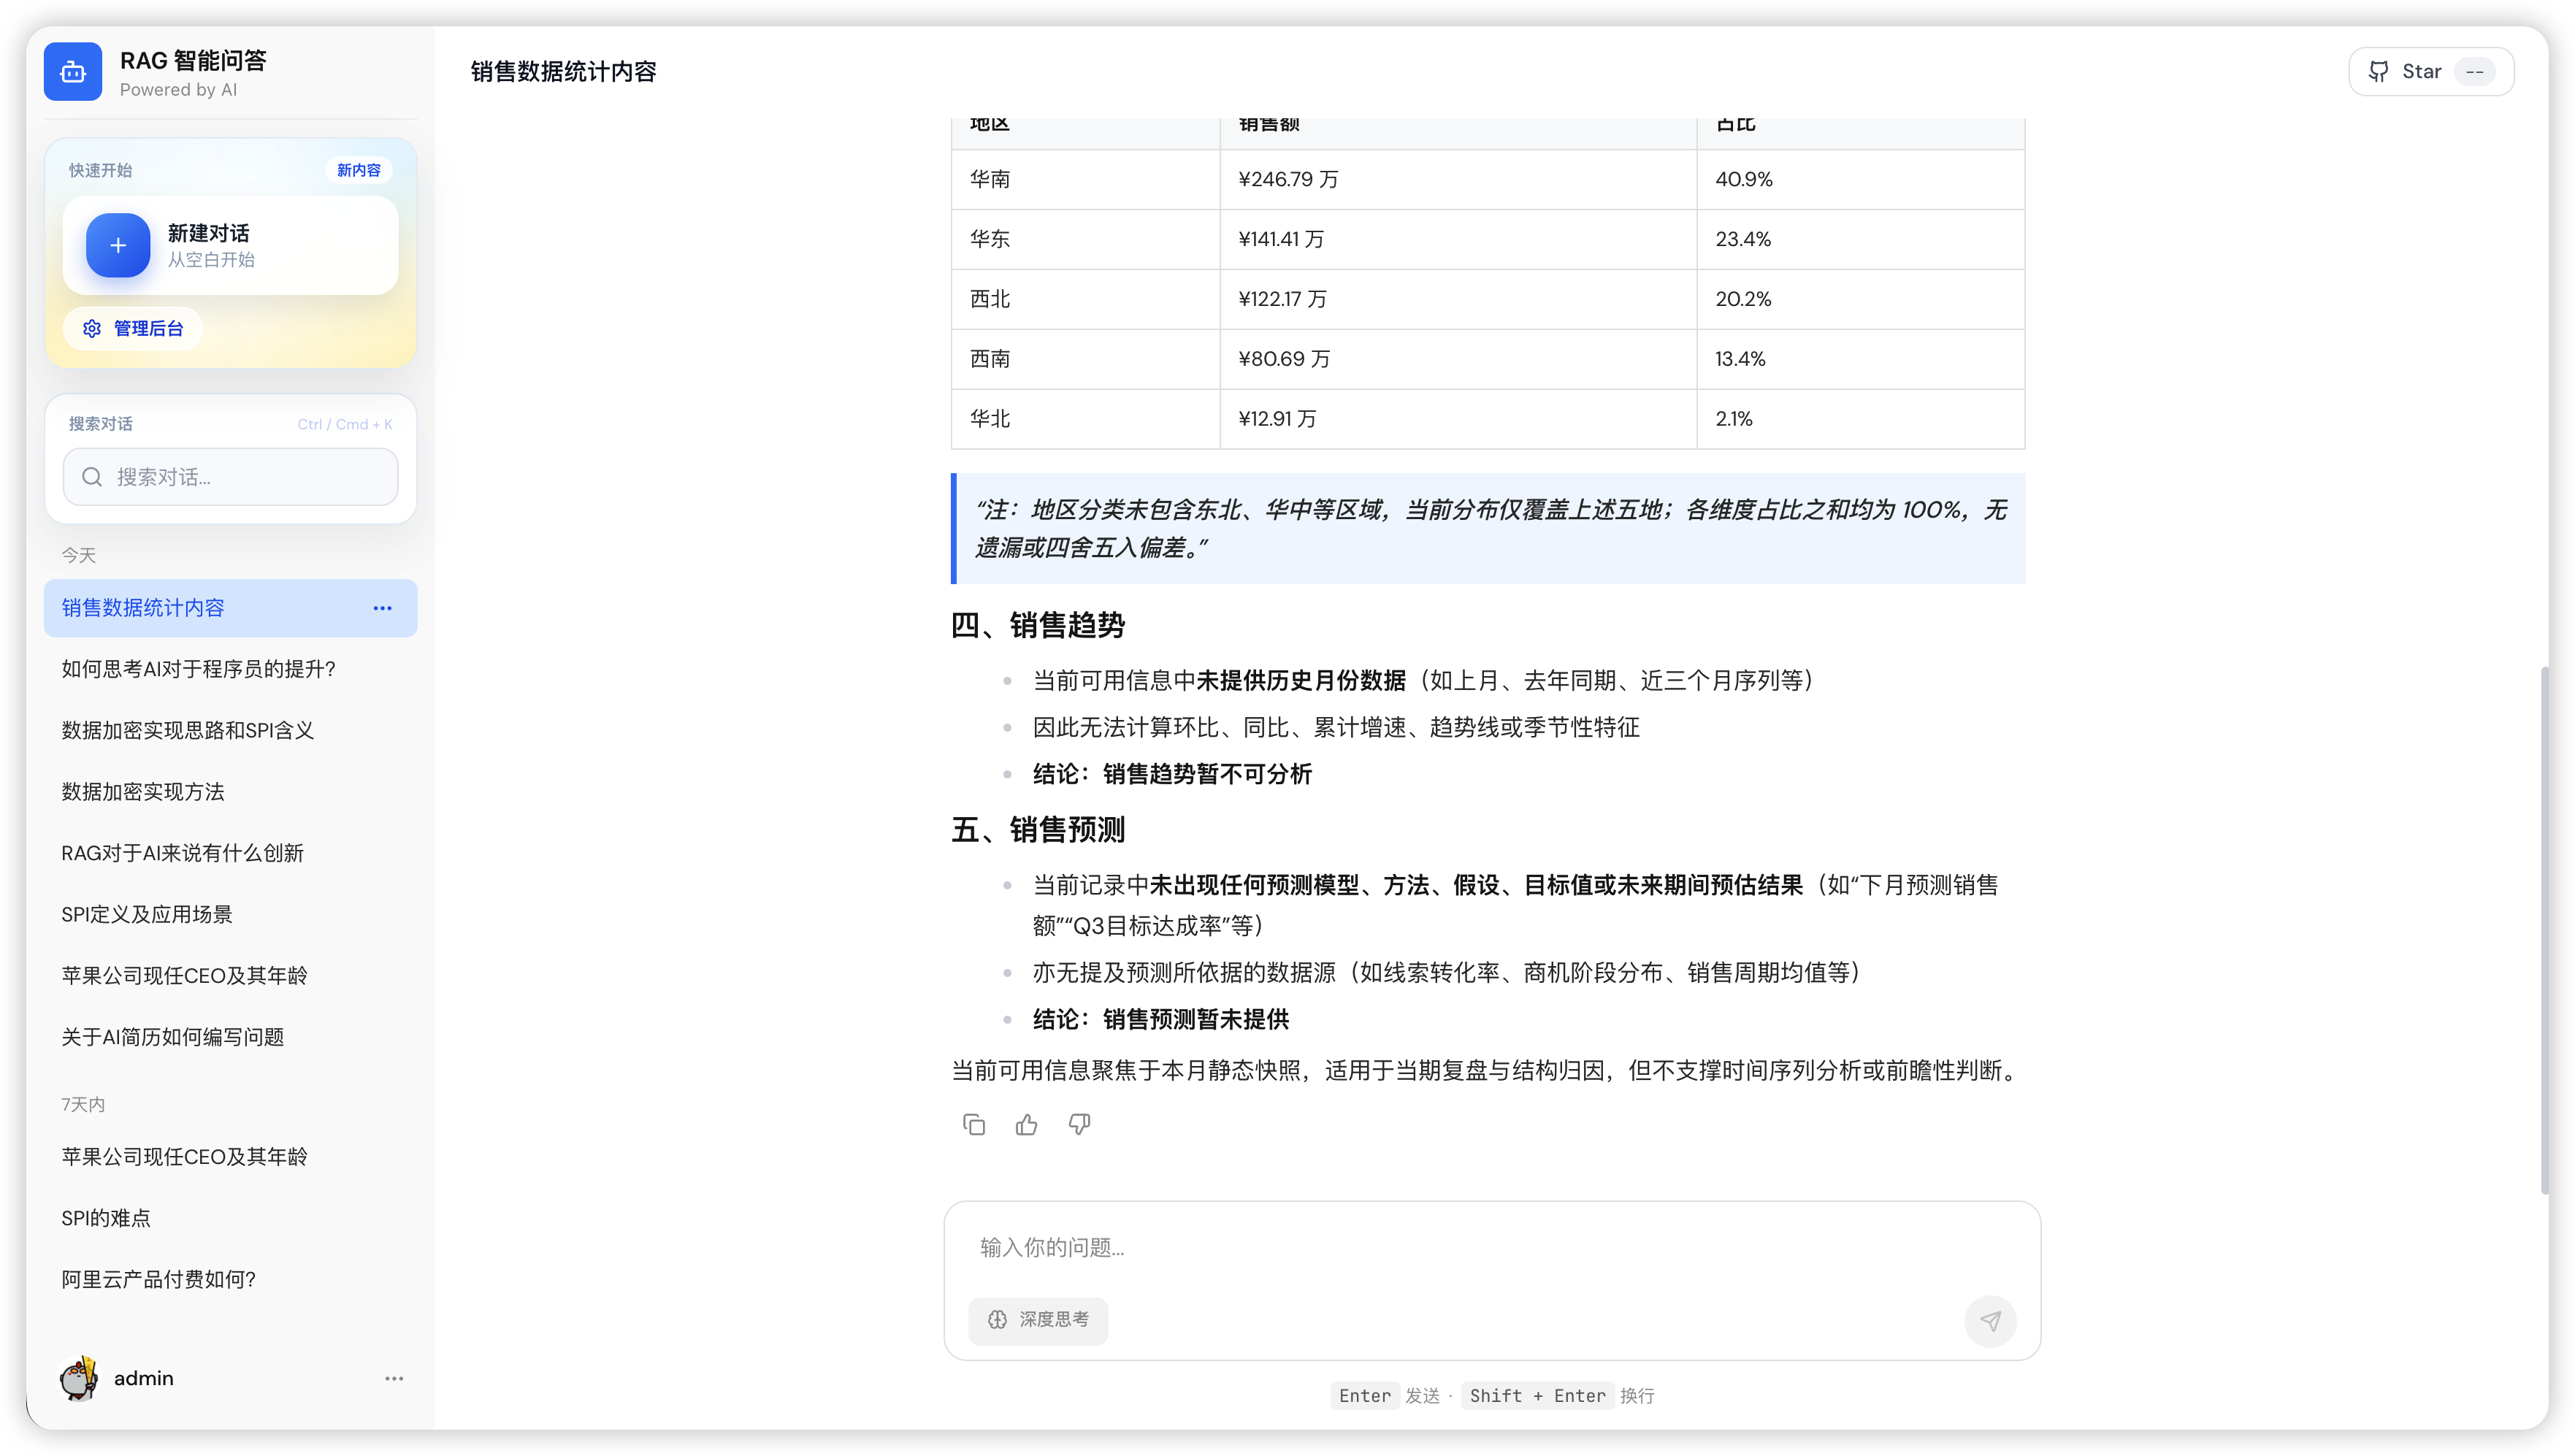
What is this?
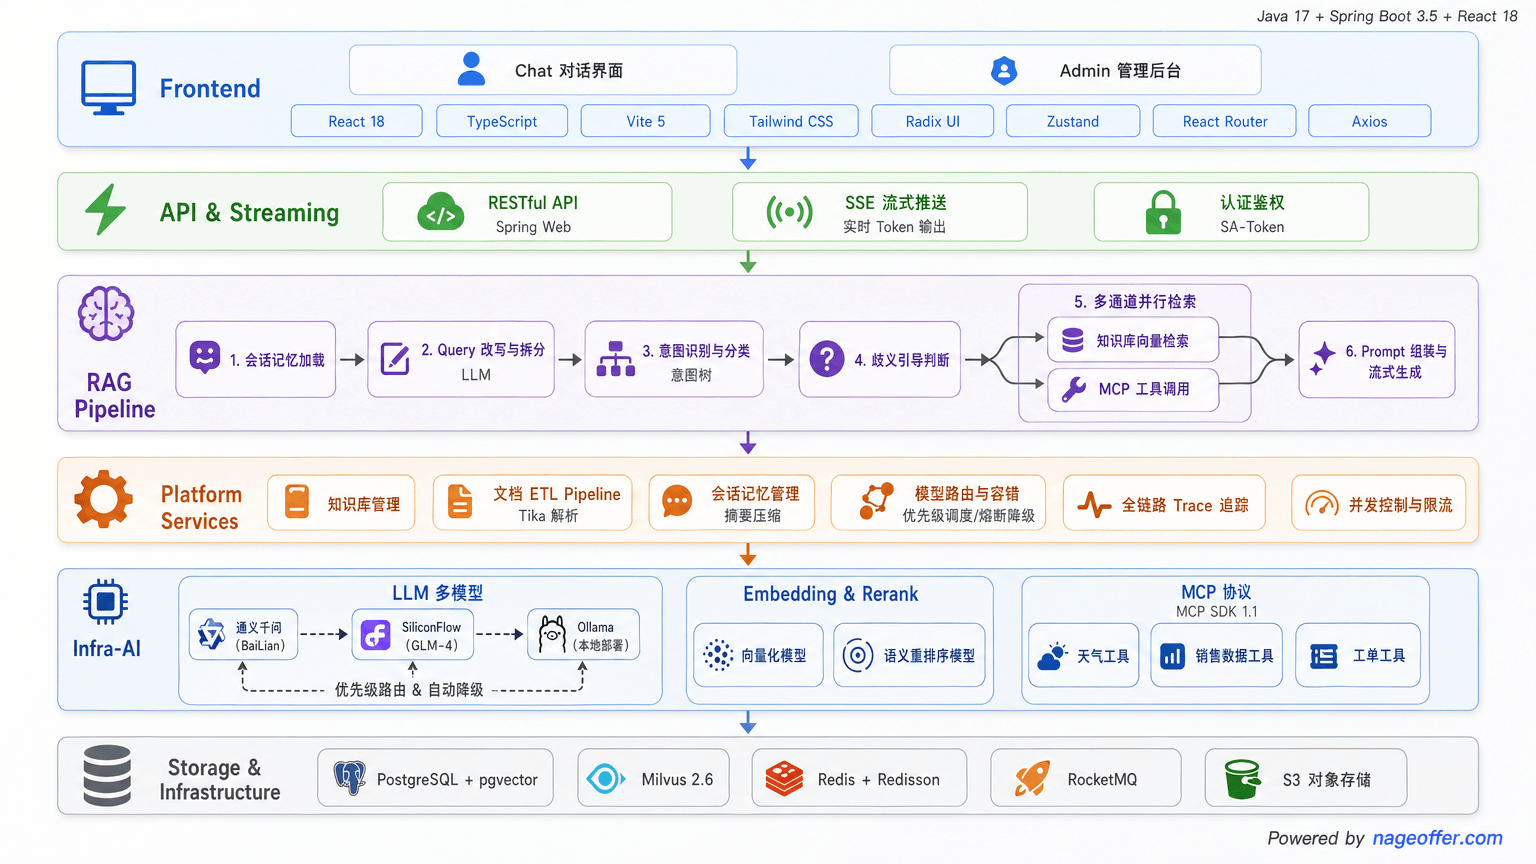
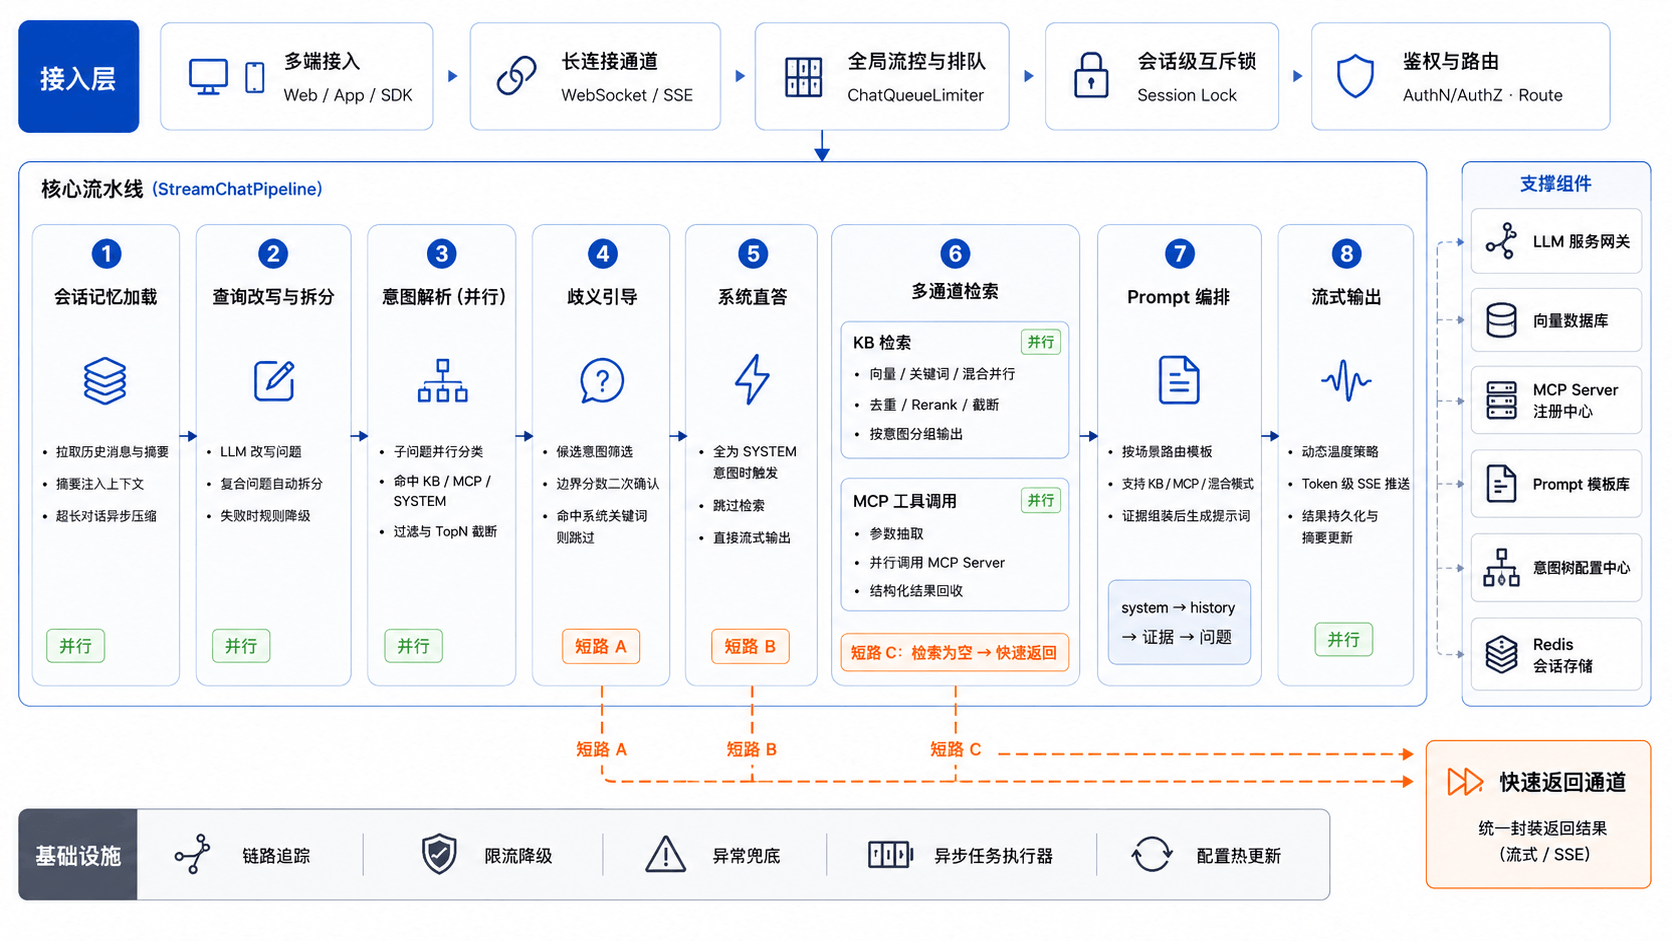
 Ragent is a production-grade Java platform for Agentic RAG, covering the full chain from document ingestion to intelligent Q&A — including hybrid retrieval, query rewriting, intent recognition, session memory, MCP tool calling and deep thinking.
Is this a library I import, or a full standalone application?It's a full-stack application: a modular monolith backend split into 7 Maven modules (framework, infra-ai, system, rag, agent, bootstrap, mcp-server) plus a separate React console for end users and admins.
It's a full-stack application: a modular monolith backend split into 7 Maven modules (framework, infra-ai, system, rag, agent, bootstrap, mcp-server) plus a separate React console for end users and admins.How do I get it running locally?The README links to a Quick Start guide for setting up the frontend and backend locally, and also offers a hosted online demo if you just want to try it without deploying anything.
The README links to a Quick Start guide for setting up the frontend and backend locally, and also offers a hosted online demo if you just want to try it without deploying anything.What infrastructure do I need — Redis, Elasticsearch, RocketMQ?Yes to all three: Redis handles fair-queue flow control, Elasticsearch provides keyword retrieval, and RocketMQ guarantees transactional document chunking/deletion tasks, alongside a vector database and optional LightRAG knowledge graph.
Yes to all three: Redis handles fair-queue flow control, Elasticsearch provides keyword retrieval, and RocketMQ guarantees transactional document chunking/deletion tasks, alongside a vector database and optional LightRAG knowledge graph.Is this a toy demo, or does it actually solve production RAG problems?The author built it specifically to go beyond demo-level RAG: it tackles document chunking, query rewriting, intent routing, multi-channel retrieval fusion, multi-tenant isolation and model failover, which most tutorial projects skip entirely.
The author built it specifically to go beyond demo-level RAG: it tackles document chunking, query rewriting, intent routing, multi-channel retrieval fusion, multi-tenant isolation and model failover, which most tutorial projects skip entirely.Who is this aimed at?It targets Java backend developers who want a real, interview-worthy AI/RAG project on their resume — the author built it because most AI bootcamps are Python-only, leaving Java engineers without a practical reference.
It targets Java backend developers who want a real, interview-worthy AI/RAG project on their resume — the author built it because most AI bootcamps are Python-only, leaving Java engineers without a practical reference.Why didn't the author just use Spring AI or LangChain4j?Those frameworks iterate so fast that low versions lack features and upgrading often means rewriting the integration, so Ragent builds its own model-routing, tool-calling and failover layers instead of fully depending on them.
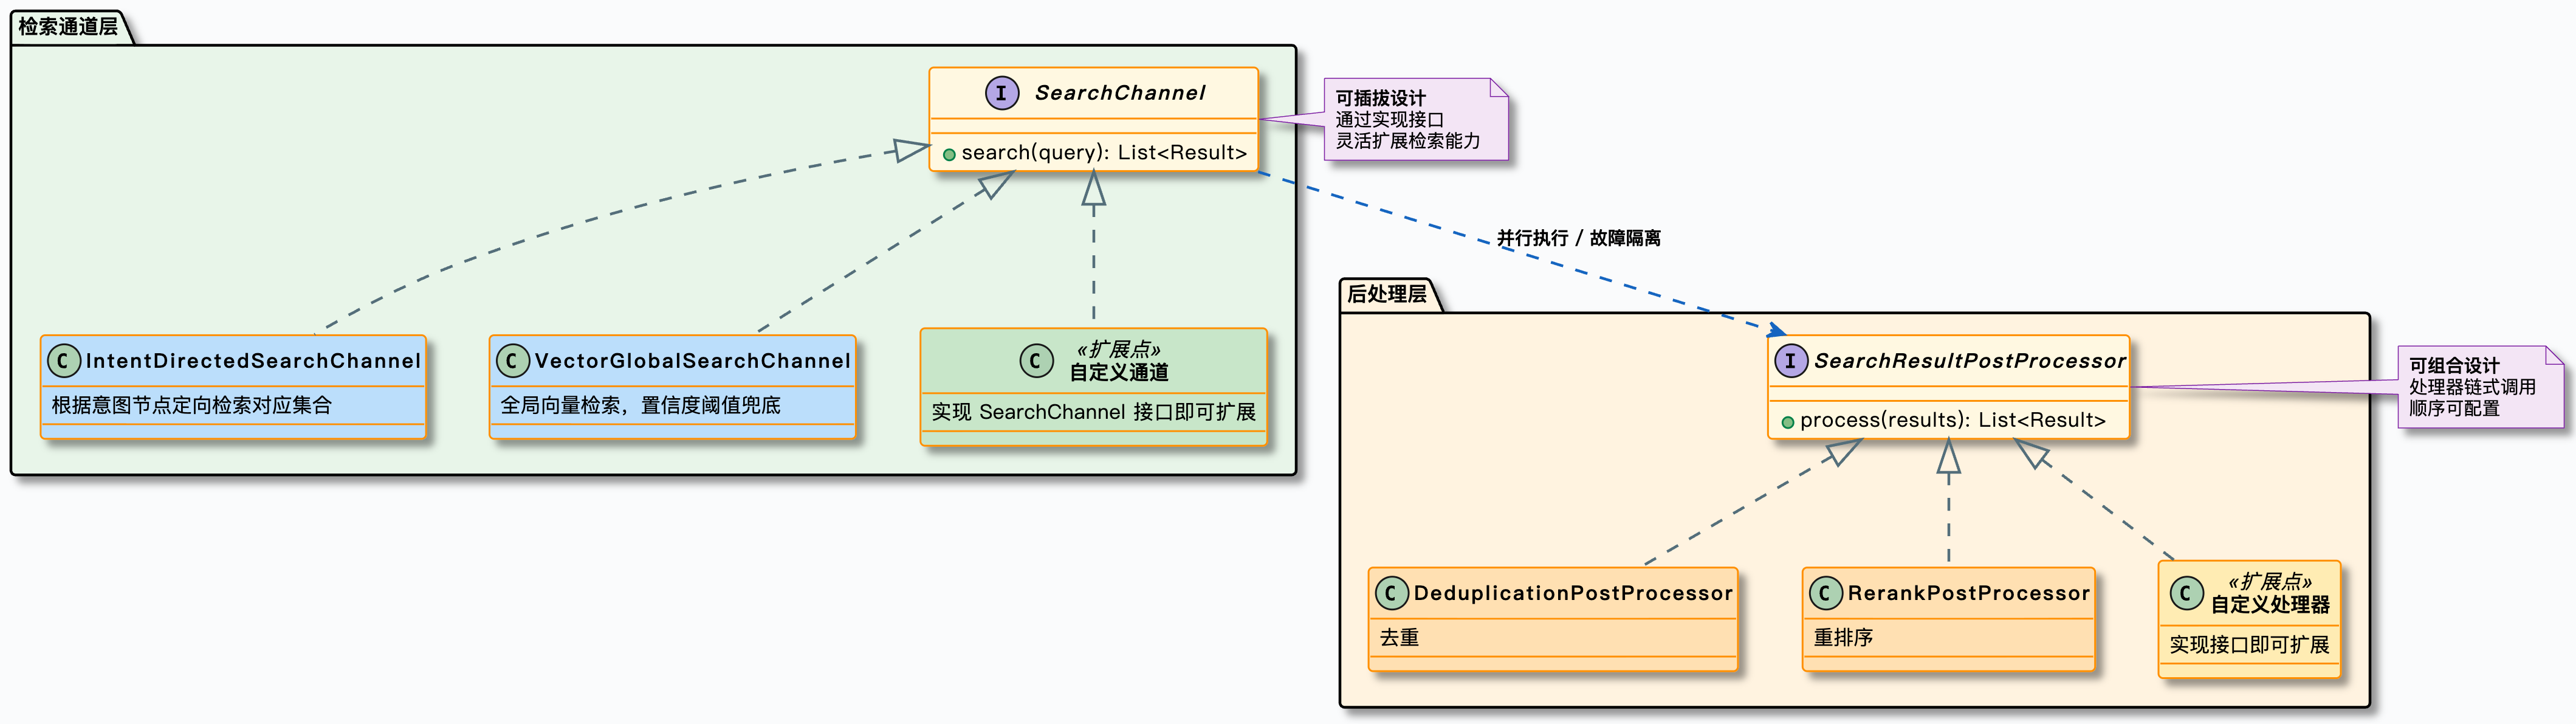
Those frameworks iterate so fast that low versions lack features and upgrading often means rewriting the integration, so Ragent builds its own model-routing, tool-calling and failover layers instead of fully depending on them.What retrieval channels does it support?Four parallel channels — vector search, Elasticsearch keyword search, LightRAG knowledge-graph search, and You.com web search — are merged with deduplication, weighted RRF fusion, and reranking.
Four parallel channels — vector search, Elasticsearch keyword search, LightRAG knowledge-graph search, and You.com web search — are merged with deduplication, weighted RRF fusion, and reranking.How does it protect against a flaky or overloaded model provider?A three-state circuit breaker isolates failing models, and if a model times out or returns an empty/error response, requests automatically fail over to another candidate model.
A three-state circuit breaker isolates failing models, and if a model times out or returns an empty/error response, requests automatically fail over to another candidate model.What does the admin console let me manage?Admins can manage knowledge bases and chunks, the knowledge graph, intent trees, query-term mappings, ingestion tasks, sample questions, users and system settings from a dashboard.
Admins can manage knowledge bases and chunks, the knowledge graph, intent trees, query-term mappings, ingestion tasks, sample questions, users and system settings from a dashboard.What are similar projects?ragflow, m_flow, txtai, WeKnora, OpenMetadata, agentic-rag-for-dummies, financial-intelligence-system, bisheng
ragflow, m_flow, txtai, WeKnora, OpenMetadata, agentic-rag-for-dummies, financial-intelligence-system, bishengWhich topics is it in?rag-pipeline, rocketmq, agentic-rag, circuit-breaker, spring-boot, elasticsearch, retrieval-augmented-generation, vector-search, admin-dashboard, knowledge-graph, vector-database, semantic-search
rag-pipeline, rocketmq, agentic-rag, circuit-breaker, spring-boot, elasticsearch, retrieval-augmented-generation, vector-search, admin-dashboard, knowledge-graph, vector-database, semantic-search