
minimind README

The project's README from github.com/jingyaogong/minimind. As one markdown file: README.md.

logo

visitors GitHub Repo stars GitHub Code License GitHub last commit GitHub pull request Collection

GitHub Trend

"大道至简"

中文 | English

注:本项目基于 Apache 2.0 协议开源,完全免费。“2 小时” 指 SFT 阶段在单张 NVIDIA 3090 上跑完 1 epoch 的实测耗时,“3 块钱” 指对应时段的 GPU 租用成本。


minimind-3

🔗 在线体验 | 🔗 视频介绍

Hugging Face Logo ModelScope Logo

📌 项目介绍

大语言模型(Large Language Model, LLM)的出现,引发了全球范围内对 AI 的空前关注。无论是 ChatGPT、DeepSeek 还是 Qwen,都以惊艳的效果让人真切感受到这场技术浪潮的冲击力。然而,动辄数百亿参数的模型规模,使得它们对个人设备而言不仅难以训练,甚至连部署都显得遥不可及。打开大模型的“黑盒子”,真正去理解其内部运作机制,本应是一件令人心潮澎湃的事。遗憾的是,绝大多数探索最终都止步于使用 LoRA 等技术对现有大模型做少量微调,学习一些新指令或特定任务。这更像是在教牛顿如何使用 21 世纪的智能手机——虽然有趣,却偏离了理解物理本质的初衷。

与此同时,第三方的大模型框架与工具库,如 transformers / trl / peft 等,往往只暴露出高度抽象的接口。只需短短十几行代码,就可以完成“加载模型 + 加载数据集 + 推理 + 强化学习”的全流程训练。这种高效封装固然便利,却也在一定程度上把开发者与底层实现隔离开来,削弱了深入理解 LLM 核心代码的机会。我认为 “用乐高自己拼出一架飞机,远比坐在头等舱里飞行更让人兴奋”,然而更现实的问题是,互联网上充斥着大量付费课程和营销内容,用漏洞百出、一知半解的讲解包装所谓的 AI 教程。正因如此,本项目的初衷就是尽可能降低 LLM 的学习门槛,让每个人都能从理解每一行代码开始,从 0 开始亲手训练一个极小的语言模型。是的,从零开始训练,而不是仅仅停留在推理层面。最低只需不到 3 块钱的服务器成本,就能亲身体验从 0 到 1 构建一个语言模型的全过程。

😊 一起感受创造的乐趣吧!


🎉 本项目包含以下内容

🎉 已发布模型列表

模型 参数量 Release
minimind-3 64M 2026.04.01
minimind-3-moe 198M-A64M 2026.04.01
minimind2-small 26M 2025.04.26
minimind2-moe 145M 2025.04.26
minimind2 104M 2025.04.26
minimind-v1-small 26M 2024.08.28
minimind-v1-moe 4×26M 2024.09.17
minimind-v1 108M 2024.09.01

📝 更新日志

🔥 2026-04-01
  • 发布 minimind-3 / minimind-3-moe:结构、Tokenizer、训练链路、推理接口与默认配置全面更新
  • 结构主线对齐 Qwen3 / Qwen3-MoE 生态:Dense 约 64M,MoE 约 198M-A64M,并移除了 shared expert 设计
  • 默认训练数据切换为 pretrain_t2t(_mini).jsonl、sft_t2t(_mini).jsonl、rlaif.jsonl、agent_rl.jsonl 与 agent_rl_math.jsonl
  • 移除独立 train_reason.py;思考能力统一由 chat_template + <think> 与 open_thinking 自适应开关控制
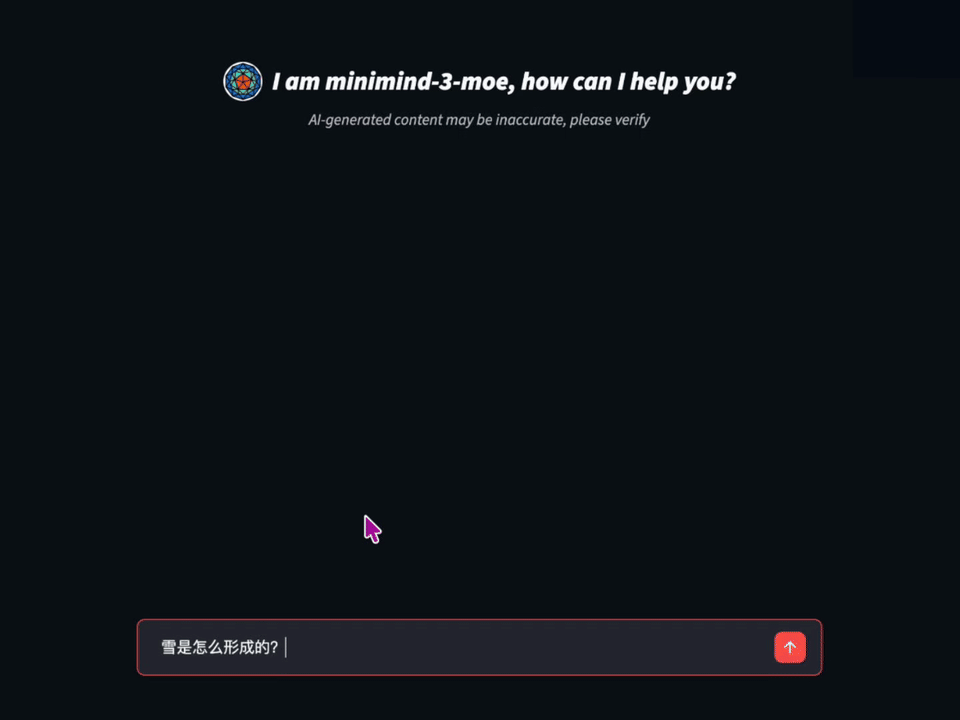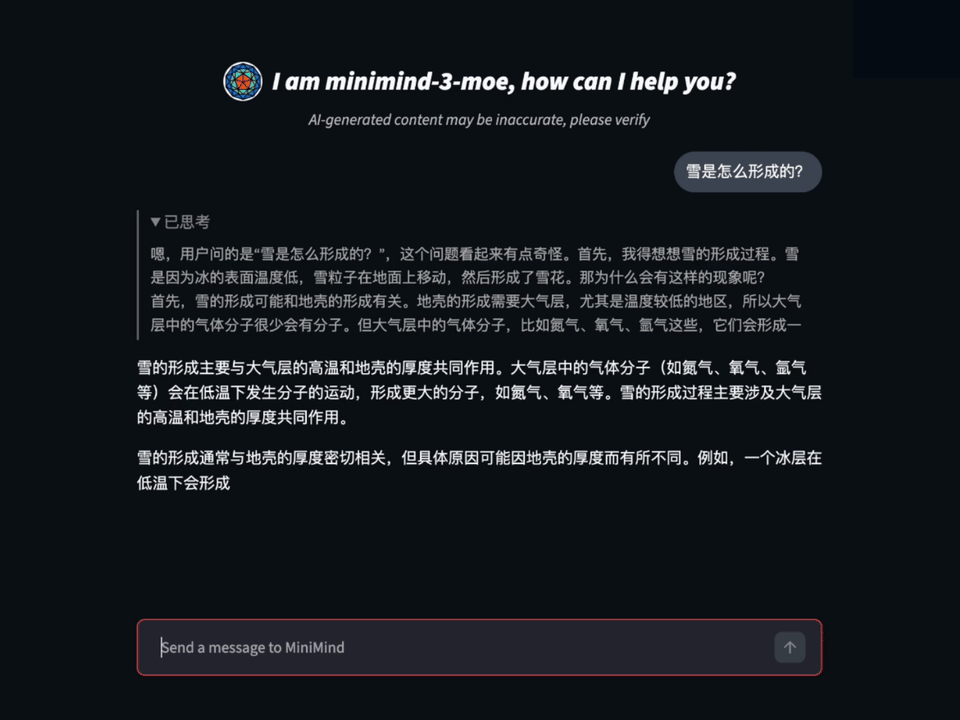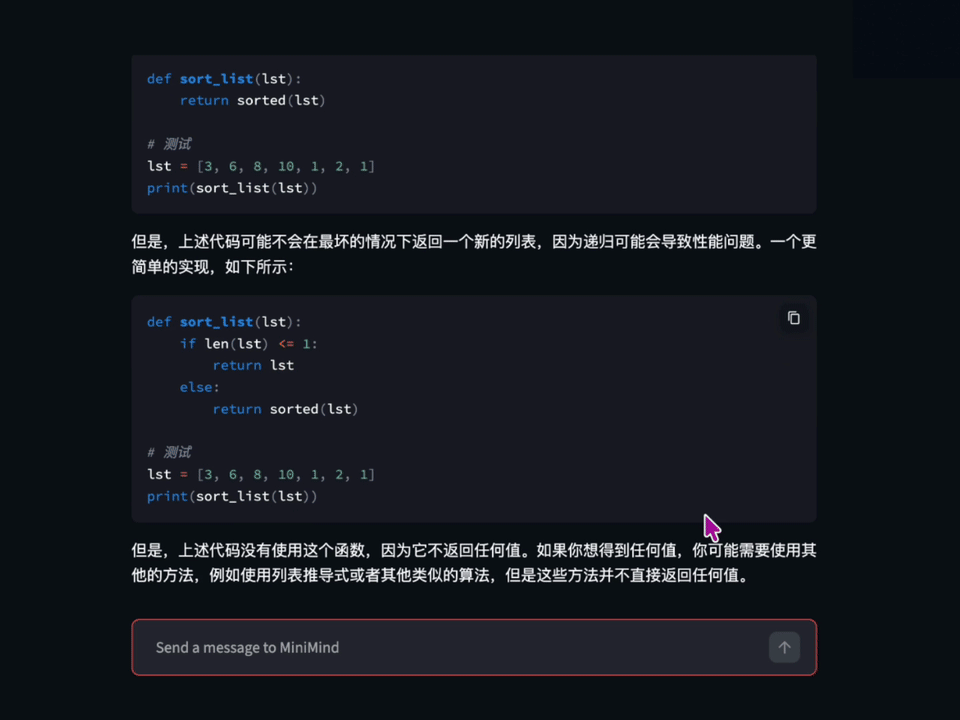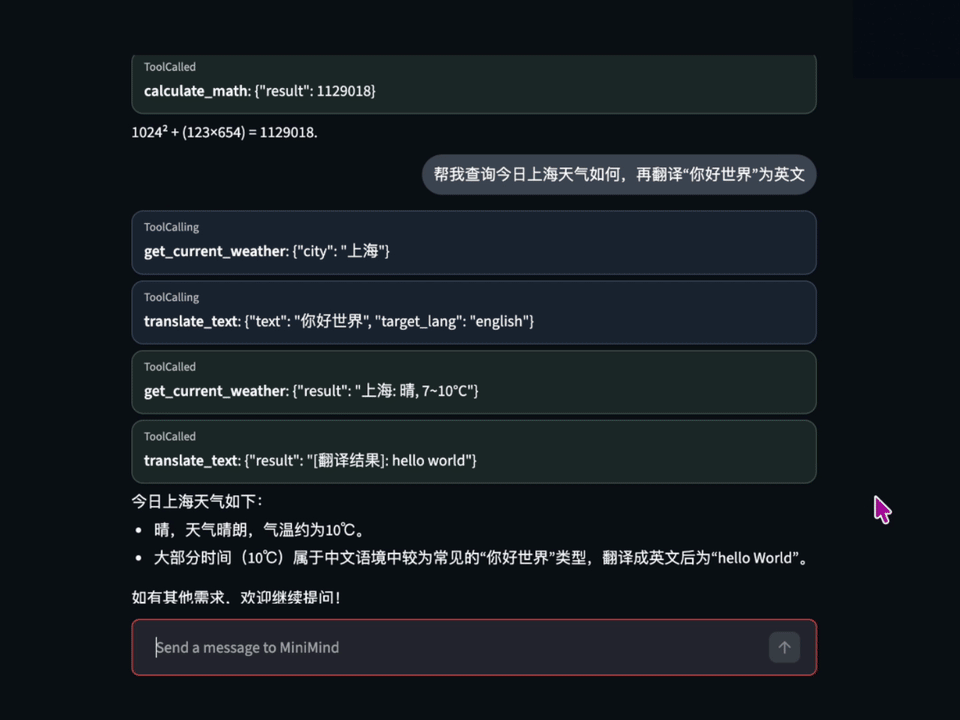
  • toolcall 能力已混入 sft_t2t / sft_t2t_mini 主线数据,默认 full_sft 即具备基础 Tool Call 能力;同时新增 scripts/chat_api.py 等推理示例
  • 新增原生 Agentic RL 训练脚本 train_agent.py,支持多轮 Tool-Use 场景下的 GRPO / CISPO
  • RLAIF / Agentic RL 训练流程完成 rollout engine 解耦,支持更灵活地切换生成后端
  • serve_openai_api.py 与 web_demo.py 新增 reasoning_content / tool_calls / open_thinking 支持
  • Tokenizer 基于 BPE + ByteLevel 更新,并新增工具调用与思考标记,预留 buffer token 便于后续扩展
  • 新增 LoRA 权重合并导出流程,可通过 scripts/convert_model.py 将基础模型与 LoRA 权重合并为新的完整模型权重
  • 结构图资源更新,README 大面积更新
2025-10-24
  • 🔥 新增RLAIF训练算法:PPO、GRPO、SPO(从0原生实现)
  • 新增断点续训功能:支持训练自动恢复、跨GPU数量恢复、wandb记录连续性
  • 新增RLAIF数据集:rlaif-mini.jsonl(从SFT数据随机采样1万条);简化DPO数据集,加入中文数据
  • 新增YaRN算法:支持RoPE长文本外推,提升长序列处理能力
  • Adaptive Thinking:Reason模型可选是否启用思考链
  • chat_template全面支持Tool Calling和Reasoning标签(<tool_call>、<think>等)
  • 新增RLAIF完整章节、训练曲线对比、算法原理折叠说明
  • SwanLab替代WandB(国内访问友好,API完全兼容)
  • 规范化所有代码 & 修复一些已知bugs
2025-04-26
  • 重要更新
  • 如有兼容性需要,可访问🔗旧仓库内容🔗。
  • MiniMind模型参数完全改名,对齐Transformers库模型(统一命名)。
  • generate方式重构,继承自GenerationMixin类。
  • 🔥支持llama.cpp、vllm、ollama等热门三方生态。
  • 规范代码和目录结构。
  • 改动词表<s></s>-><|im_start|><|im_end|>
为兼容第三方推理框架llama.cpp、vllm,本次更新需付出一些可观代价。
本次更新不再支持「直接」加载25-04-26以前的旧模型进行推理。
由于Llama位置编码方式与minimind存在区别,导致映射Llama模型后QK值存在差异
minimind2系列旧模型均经过权重映射+(微调训练)QKVO线性层校准恢复而来。
本次更新后将放弃对`minimind-v1`全系列的维护,并在仓库中下线。
More...

2025-02-09

  • 迎来发布以来重大更新,Release minimind2 Series。
  • 代码几乎全部重构,使用更简洁明了的统一结构。 如有旧代码的兼容性需要,可访问🔗旧仓库内容🔗。
  • 免去数据预处理步骤。统一数据集格式,更换为jsonl格式杜绝数据集下载混乱的问题。
  • minimind2系列效果相比MiniMind-V1显著提升。
  • 小问题:{kv-cache写法更标准、MoE的负载均衡loss被考虑等等}
  • 提供模型迁移到私有数据集的训练方案(医疗模型、自我认知样例)。
  • 精简预训练数据集,并大幅提升预训练数据质量,大幅缩短个人快速训练所需时间,单卡3090即可2小时复现!
  • 更新:LoRA微调脱离peft包装,从0实现LoRA过程;DPO算法从0使用PyTorch原生实现;模型白盒蒸馏原生实现。
  • minimind2-DeepSeek-R1系列蒸馏模型诞生!
  • minimind2具备一定的英文能力!
  • 更新minimind2与第三方模型的基于更多大模型榜单测试性能的结果。

2024-10-05

  • 为MiniMind拓展了多模态能力之---视觉
  • 移步孪生项目minimind-v查看详情!

2024-09-27

  • 09-27更新pretrain数据集的预处理方式,为了保证文本完整性,放弃预处理成.bin训练的形式(轻微牺牲训练速度)。
  • 目前pretrain预处理后的文件命名为:pretrain_data.csv。
  • 删除了一些冗余的代码。

2024-09-17

  • 更新minimind-v1-moe模型
  • 为了防止歧义,不再使用mistral_tokenizer分词,全部采用自定义的minimind_tokenizer作为分词器。

2024-09-01

  • 更新minimind-v1 (108M)模型,采用minimind_tokenizer,预训练轮次3 + SFT轮次10,更充分训练,性能更强。
  • 项目已部署至ModelScope创空间,可以在此网站上体验:
  • 🔗ModelScope在线体验🔗

2024-08-27

  • 项目首次开源

📌 快速开始

本人的软硬件配置(供参考)
  • CPU: Intel(R) Core(TM) i9-10980XE CPU @ 3.00GHz
  • RAM: 128 GB
  • GPU: NVIDIA GeForce RTX 3090 (24GB) * 8
  • Ubuntu==20.04
  • CUDA==12.2
  • Python==3.10.16
  • requirements.txt

第0步

# 克隆仓库、安装依赖
git clone --depth 1 https://github.com/jingyaogong/minimind
cd minimind && pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple

Ⅰ 🚀 模型推理

1' 下载模型

在项目根目录:

# 方式1
modelscope download --model gongjy/minimind-3 --local_dir ./minimind-3
# 方式2
git clone https://huggingface.co/jingyaogong/minimind-3

2' CLI 推理

# 方式1:使用 Transformers 格式模型
python eval_llm.py --load_from ./minimind-3
# 方式2:基于 PyTorch 模型(确保./out目录下有对应权重)
python eval_llm.py --load_from ./model --weight full_sft

3'(可选)WebUI

# 可能需要`python>=3.10`,安装 `pip install streamlit`
# ⚠️ 须先将 transformers 格式模型文件夹复制到 ./scripts/ 目录下(例如:cp -r minimind-3 ./scripts/minimind-3),web_demo 脚本会自动扫描该目录下包含权重文件的子文件夹,如不存在则报错
cd scripts && streamlit run web_demo.py

4'(可选)第三方推理框架

# ollama
ollama run jingyaogong/minimind-3
# vllm
vllm serve /path/to/model --served-model-name "minimind"

Ⅱ 🛠️ 模型训练

注:提前确认 Torch 的可用后端
import torch
print(torch.cuda.is_available())

若你计划使用 CUDA 训练,建议先确认当前环境是否已正确识别 GPU。
若 cuda 不可用,也仍可根据自身设备选择 CPU 或 MPS 运行,但训练速度与兼容性会有非常大的差异。
如需安装或更换 PyTorch 版本,可参考 torch_stable 与链接

1' 下载数据

从下文提供的数据集下载链接 下载所需数据文件,并放入 ./dataset 目录

当前默认仅需下载 pretrain_t2t_mini.jsonl 与 sft_t2t_mini.jsonl,即可较快复现 MiniMind Zero 对话模型。 如有更多需求,下文提供多种搭配方案,可根据自身任务目标与 GPU 资源灵活选择。

2' 开始训练

💡 检查点暂停续训

所有训练脚本均支持检查点保存。添加 --from_resume 1 参数后,即可自动检测并恢复训练进度:

python train_pretrain.py --from_resume 1
python train_full_sft.py --from_resume 1
# ...

断点续训说明:

  • 训练过程会自动在 ./checkpoints/ 目录保存完整检查点(模型、优化器、训练进度等)
  • 检查点文件命名:<权重名>_<维度>_resume.pth(如:full_sft_512_resume.pth)
  • 支持跨不同 GPU 数量恢复(自动调整 step)
  • 支持 wandb 训练记录连续性(自动恢复同一个 run)

适合长时间训练或不稳定环境,无需担心训练中断导致进度丢失

2.1 预训练(必须)

cd trainer && python train_pretrain.py

训练后,将得到 out/pretrain_*.pth 作为输出权重(其中 * 为模型 dimension,默认为 768)

2.2 指令微调(必须)

cd trainer && python train_full_sft.py

训练后,将得到 out/full_sft_*.pth 作为输出权重(其中 full 表示全参数微调)

2.3 测试已训练模型(可选)

确保待测试的模型 *.pth 文件位于 ./out/ 目录下;也可直接前往此处下载我已训练好的 *.pth 权重。

python eval_llm.py --weight full_sft

--weight 用于指定权重名称前缀,例如 pretrain、full_sft 等;更多参数可直接参考 eval_llm.py

注:其它须知

1、所有训练脚本均基于 PyTorch 原生实现,并支持多卡加速。

2、若你的设备有 N (N > 1) 张显卡,可通过以下方式启动单机 N 卡训练(DDP,也支持扩展到多机多卡):

torchrun --nproc_per_node N train_xxx.py

3、可根据需要开启 wandb 记录训练过程。

... train_xxx.py --use_wandb

2025 年 6 月后,国内网络环境通常无法直连 WandB。MiniMind 当前默认转为使用 SwanLab 作为训练可视化工具,其接口与 WandB 基本兼容;通常只需将 import wandb 替换为 import swanlab as wandb,其余调用方式基本无需改动。


📌 数据介绍

Ⅰ Tokenizer

分词器可以粗略理解成 LLM 使用的一本“词典”,负责把自然语言映射成 token id,再把 token id 解码回文本;项目中也提供了train_tokenizer.py作为词表训练示例。不建议重新训练 tokenizer,因为词表和切分规则一旦变化,模型权重、数据格式、推理接口与社区生态的兼容性都会下降,也会削弱模型的传播性。同时,tokenizer 还会影响 PPL 这类按 token 统计的指标,因此跨 tokenizer 比较时,BPB(Bits Per Byte)往往更有参考价值,可参考这篇。 对 MiniMind 这类小模型来说,词表大小还会直接影响 embedding 层和输出层的参数占比,因此保持词表精简通常是更合适的取舍。

Tokenizer介绍

第三方强大的开源模型例如 Yi、Qwen2、ChatGLM、Mistral、Llama 3 的 tokenizer 词表长度如下:

Tokenizer模型词表大小来源
Yi64,00001万物(中国)
Qwen2151,643阿里云(中国)
ChatGLM151,329智谱AI(中国)
Mistral32,000Mistral AI(法国)
Llama 3128,000Meta(美国)
MiniMind6,400自定义

当前主线为避免历史版本歧义并控制整体体积,统一使用 minimind_tokenizer,不再维护 mistral_tokenizer 版本。

尽管 minimind_tokenizer 的词表只有 6400,编解码效率弱于 qwen2、glm 等更偏中文友好的 tokenizer,但它能显著压缩 embedding 层和输出层的参数占比,更适合 MiniMind 这类小模型的体积约束。 从实际使用效果看,这套 tokenizer 并没有明显带来生僻词解码失败的问题,整体仍然足够稳定可用;因此当前主线训练也统一沿用这套词表,而不再额外分叉维护其他 tokenizer 版本。

Ⅱ Pretrain数据

MiniMind-3 当前主线预训练数据为 pretrain_t2t.jsonl / pretrain_t2t_mini.jsonl。
这两份数据已经整�

minimind (jingyaogong/minimind)

framework
Searching Database…

63.9K ·GitHub
What is this?MiniMind is an open-source project that lets you train a tiny large language model (around 64M parameters) completely from scratch, in about 2 hours on a single RTX 3090 for roughly the cost of 3 RMB in GPU rental.
Is this a ready-made chatbot or a training framework I run myself?It is a training framework and tutorial: every core algorithm (pretraining, SFT, LoRA, DPO, PPO/GRPO, tool use, distillation) is implemented natively in PyTorch without relying on high-level wrappers from libraries like transformers/trl/peft, so you build and train the model yourself.
How do I train my own MiniMind model?Install the requirements, download the pretrain_t2t_mini.jsonl and sft_t2t_mini.jsonl datasets into ./dataset, then run the pretrain script followed by the full SFT script to get out/pretrain.pth and out/full_sft.pth.
What hardware and software do I need to train it?The author's reference setup is an Intel i9, 128GB RAM, an RTX 3090 (24GB), Ubuntu 20.04, CUDA 12.2 and Python 3.10.16, with dependencies listed in requirements.txt.
Do I need an NVIDIA GPU, or can I run it on CPU or Mac?CUDA is recommended for speed, but training can also fall back to CPU or Apple's MPS backend, though speed and compatibility will differ significantly without CUDA.
Why train from scratch instead of just fine-tuning an existing big model?The author argues that LoRA-style fine-tuning of huge existing models is like teaching Newton to use a smartphone — it feels productive but skips understanding the underlying mechanics. MiniMind lets you understand every line of code by building a model from zero yourself.
What inference engines and tools does MiniMind work with?It is compatible with transformers, trl and peft, as well as popular inference engines like llama.cpp, vllm and ollama, plus training frameworks like Llama-Factory.
Can I chat with a trained MiniMind model through an API or web UI?Yes, there is a minimal server implementing the OpenAI API protocol (so you can plug it into tools like FastGPT or Open-WebUI), plus a Streamlit-based chat web UI with tool-call and reasoning display support.
What other model variants does the project include besides the base text LLM?Alongside the main dense/MoE MiniMind, the project also offers a vision model (MiniMind-V), a multimodal model (MiniMind-O), a diffusion language model (MiniMind-dLM) and a linear-attention model (MiniMind-Linear).
What are similar projects?halo, train-llm-from-scratch, verl, verl, ms-swift, DMI, jeeves, Hy-MT2
Size
38.6 MB
Stars
63.9K
Age
2y
Commits · 90 Days