




41.4K ·GitHub
Что это такое?
 Colossal-AI — это система с открытым исходным кодом для обучения и запуска больших моделей ИИ, которая позволяет делать это дешевле, быстрее и на меньшем количестве оборудования. Она предоставляет набор инструментов с методами параллелизма и оптимизации использования памяти.
Это фреймворк, на котором строят модели, или самостоятельное приложение?Это фреймворк/набор инструментов на Python с компонентами параллельного обучения (параллелизм данных, конвейерный, тензорный, по последовательности, ZeRO), которые подключаются к вашему собственному коду обучения на PyTorch. Это не готовое приложение.
Это фреймворк/набор инструментов на Python с компонентами параллельного обучения (параллелизм данных, конвейерный, тензорный, по последовательности, ZeRO), которые подключаются к вашему собственному коду обучения на PyTorch. Это не готовое приложение.Как установить Colossal-AI?Его можно установить из PyPI, собрать из исходного кода или запустить через Docker, как описано в разделе установки проекта.
Его можно установить из PyPI, собрать из исходного кода или запустить через Docker, как описано в разделе установки проекта.Это для небольших домашних проектов или для серьёзного обучения на больших объёмах?Проект нацелен именно на обучение и инференс больших базовых моделей на кластерах с несколькими GPU и несколькими узлами, поэтому для реальной пользы нужен доступ к значительному количеству GPU. В опубликованных бенчмарках используются конфигурации из 8–16 GPU.
Проект нацелен именно на обучение и инференс больших базовых моделей на кластерах с несколькими GPU и несколькими узлами, поэтому для реальной пользы нужен доступ к значительному количеству GPU. В опубликованных бенчмарках используются конфигурации из 8–16 GPU.Для кого это создано на самом деле?Для исследователей и компаний, которые обучают или дообучают большие базовые модели (LLM, диффузионные модели, генерацию видео) и хотят снизить стоимость GPU и время обучения. Это подтверждено бенчмарками из UC Berkeley и финансированием от индустрии.
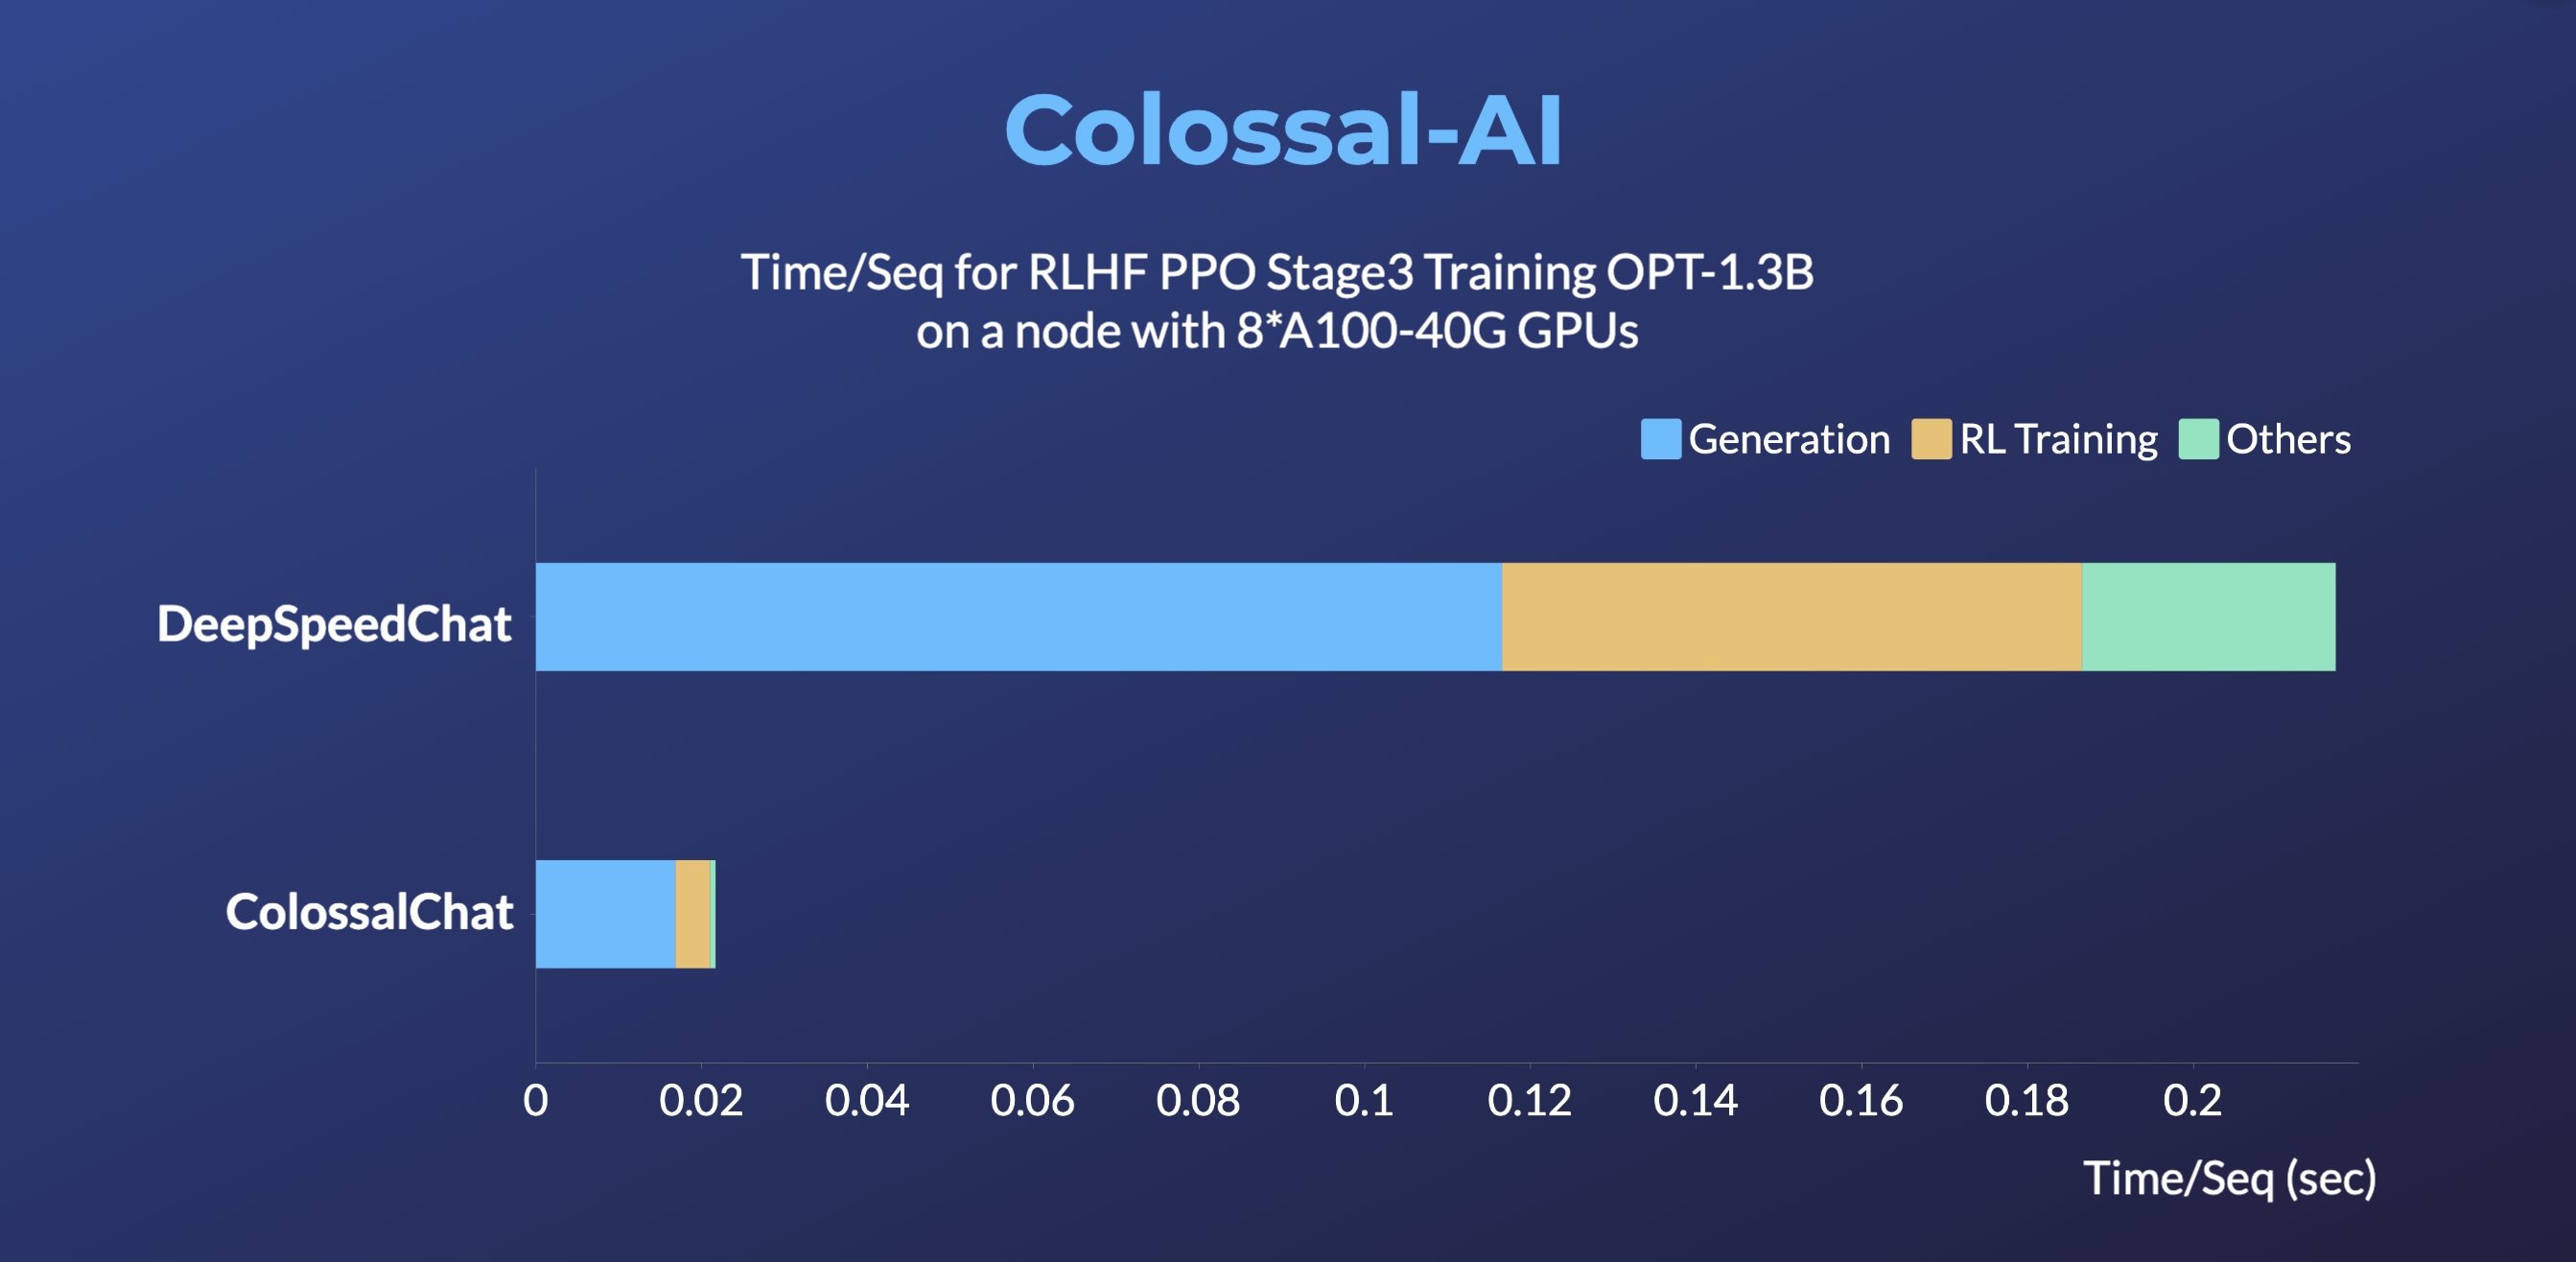
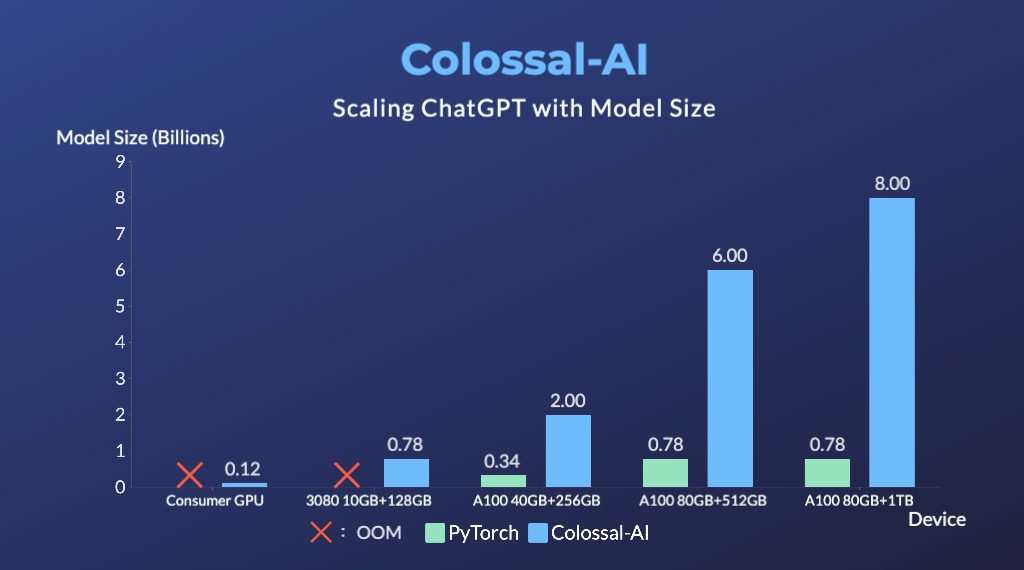
Для исследователей и компаний, которые обучают или дообучают большие базовые модели (LLM, диффузионные модели, генерацию видео) и хотят снизить стоимость GPU и время обучения. Это подтверждено бенчмарками из UC Berkeley и финансированием от индустрии.Что такое ColossalChat?ColossalChat — это решение с открытым исходным кодом для создания аналога ChatGPT с полным циклом обучения RLHF (PPO). Заявлено, что обучение на этапе PPO Stage3 может быть до 10 раз быстрее.
ColossalChat — это решение с открытым исходным кодом для создания аналога ChatGPT с полным циклом обучения RLHF (PPO). Заявлено, что обучение на этапе PPO Stage3 может быть до 10 раз быстрее.Для чего используется Colossal-LLaMA-2?Это рецепт для дешёвого создания языковой модели под конкретную предметную область. По данным проекта, около полдня обучения за несколько сотен долларов поверх LLaMA-2 позволяет сравняться с результатами популярных моделей на основных бенчмарках.
Это рецепт для дешёвого создания языковой модели под конкретную предметную область. По данным проекта, около полдня обучения за несколько сотен долларов поверх LLaMA-2 позволяет сравняться с результатами популярных моделей на основных бенчмарках.Какое отношение к этому проекту имеет Open-Sora?Open-Sora — это проект с открытым исходным кодом на базе Colossal-AI, который воспроизводит модели генерации видео по тексту, похожие на Sora. Включены код, веса моделей и детали обучения.
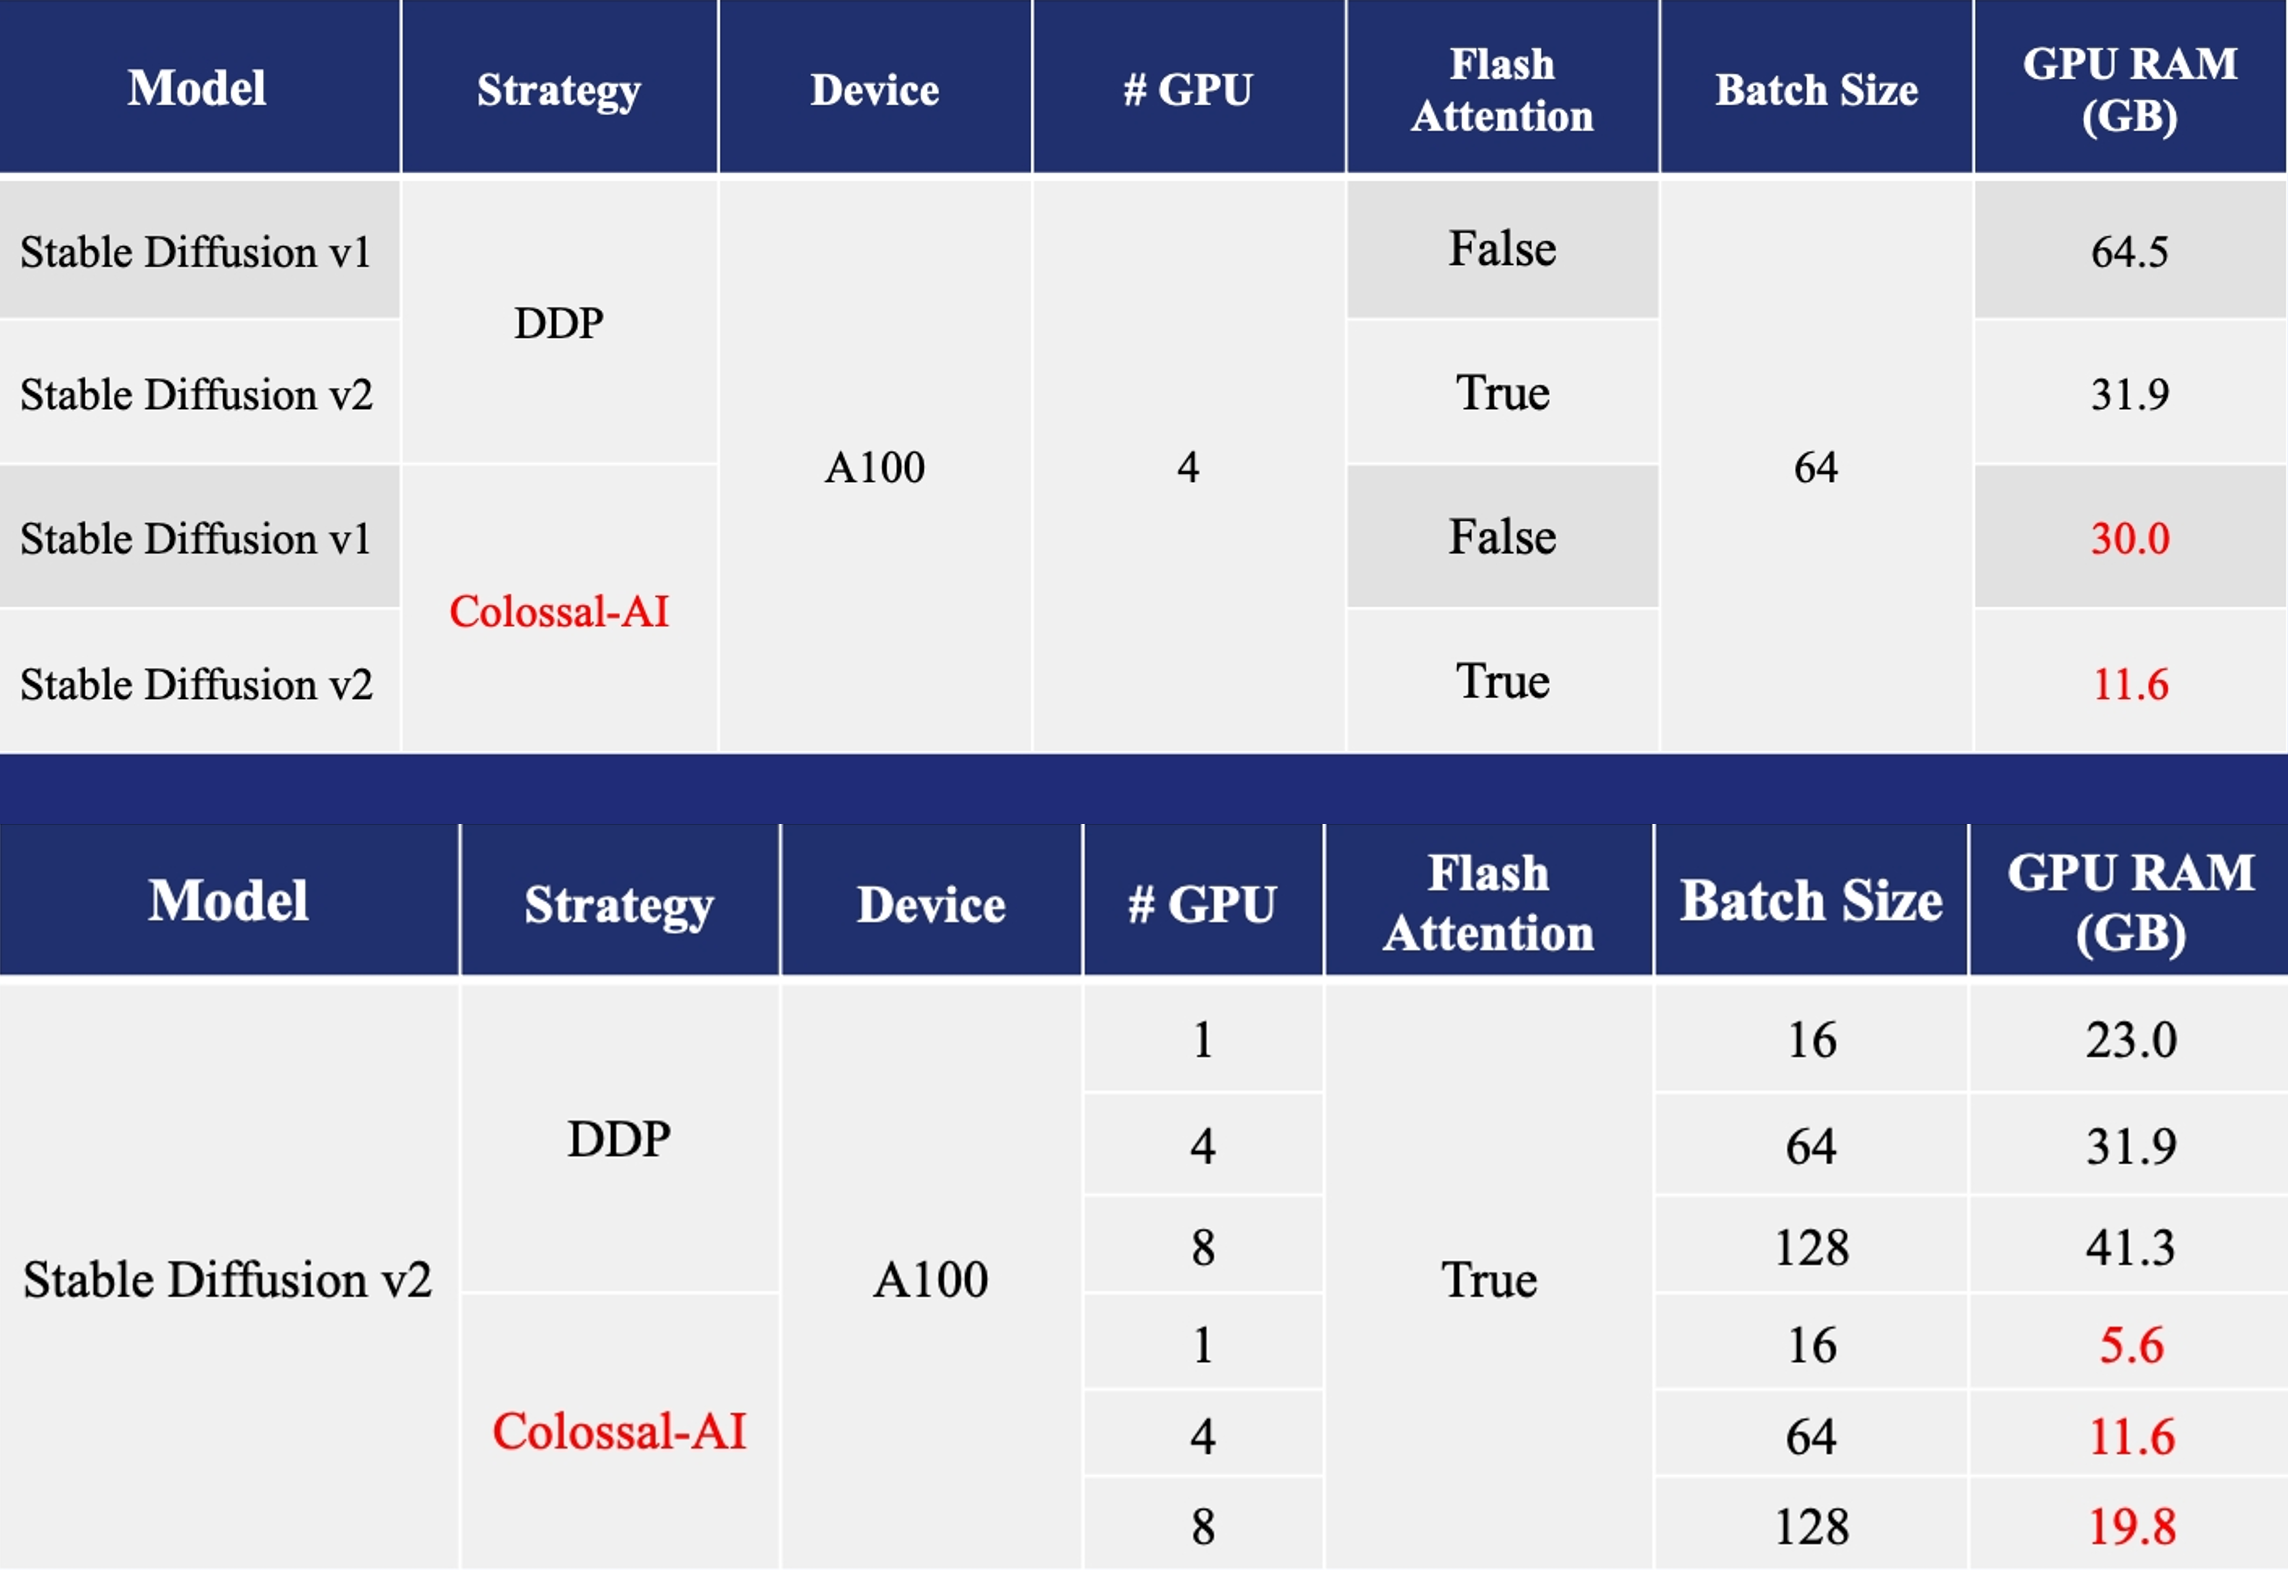
Open-Sora — это проект с открытым исходным кодом на базе Colossal-AI, который воспроизводит модели генерации видео по тексту, похожие на Sora. Включены код, веса моделей и детали обучения.На сколько Colossal-AI может снизить стоимость обучения Stable Diffusion?По данным проекта, потребление памяти при обучении Stable Diffusion удаётся снизить до 5,6 раза, а стоимость оборудования — до 46 раз, что позволяет переносить обучение с A100 на RTX 3060.
По данным проекта, потребление памяти при обучении Stable Diffusion удаётся снизить до 5,6 раза, а стоимость оборудования — до 46 раз, что позволяет переносить обучение с A100 на RTX 3060.What are similar projects?petals, DeepSpeed, halo, ms-swift, verl, ml-engineering, train-llm-from-scratch, Meshy
petals, DeepSpeed, halo, ms-swift, verl, ml-engineering, train-llm-from-scratch, MeshyWhich topics is it in?hpc, distributed-computing, rlhf, distributed-training, foundation-models, stable-diffusion, llama, training, gpt, fine-tuning, video-generation, chatgpt
hpc, distributed-computing, rlhf, distributed-training, foundation-models, stable-diffusion, llama, training, gpt, fine-tuning, video-generation, chatgpt