
HanLP README

The project's README from github.com/hankcs/HanLP. As one markdown file: README.md.

HanLP: Han Language Processing

Unit Tests PyPI Version Python Versions Downloads 在线运行

English | 日本語 | 文档 | 论文 | 论坛 | docker | ▶️在线运行

面向生产环境的多语种自然语言处理工具包,基于PyTorch和TensorFlow 2.x双引擎,目标是普及落地最前沿的NLP技术。HanLP具备功能完善、精度准确、性能高效、语料时新、架构清晰、可自定义的特点。

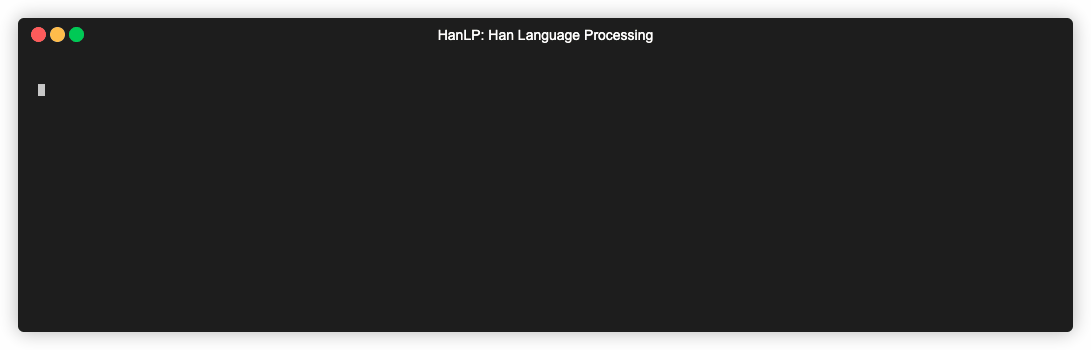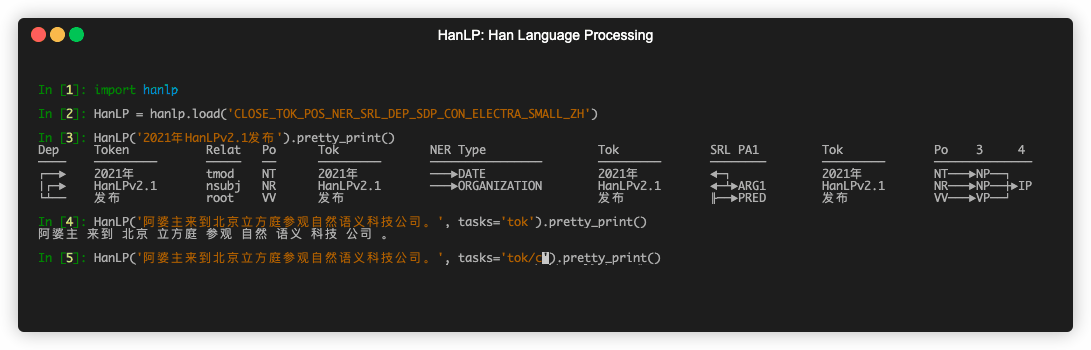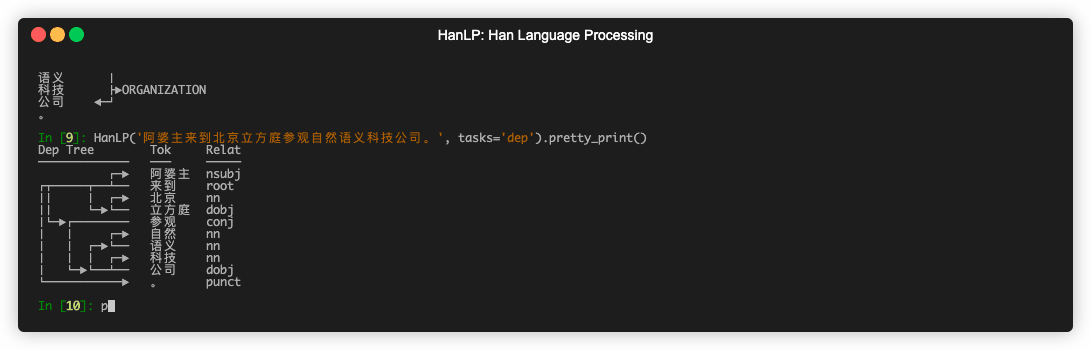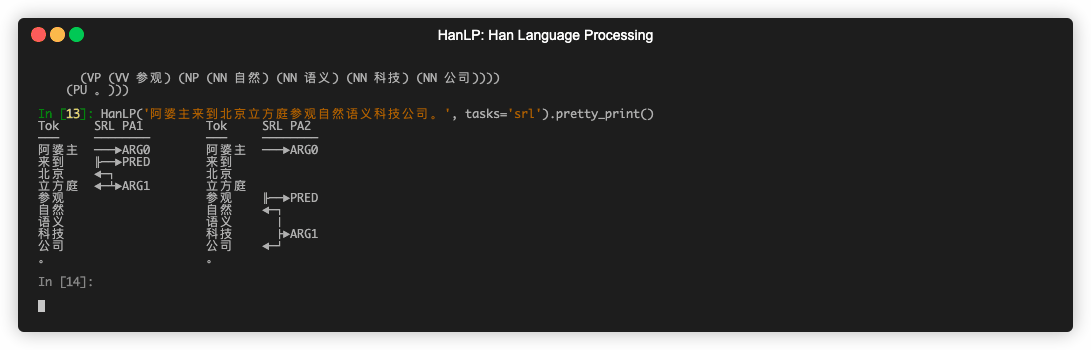
demo

借助世界上最大的多语种语料库,HanLP2.1支持包括简繁中英日俄法德在内的130种语言上的10种联合任务以及多种单任务。HanLP预训练了十几种任务上的数十个模型并且正在持续迭代语料库与模型:

功能 RESTful 多任务 单任务 模型 标注标准
分词 教程 教程 教程 tok 粗分、细分
词性标注 教程 教程 教程 pos CTB、PKU、863
命名实体识别 教程 教程 教程 ner PKU、MSRA、OntoNotes
依存句法分析 教程 教程 教程 dep SD、UD、PMT
成分句法分析 教程 教程 教程 con Chinese Tree Bank
语义依存分析 教程 教程 教程 sdp CSDP
语义角色标注 教程 教程 教程 srl Chinese Proposition Bank
抽象意义表示 教程 暂无 教程 amr CAMR
指代消解 教程 暂无 暂无 暂无 OntoNotes
语义文本相似度 教程 暂无 教程 sts 暂无
文本风格转换 教程 暂无 暂无 暂无 暂无
关键词短语提取 教程 暂无 暂无 暂无 暂无
抽取式自动摘要 教程 暂无 暂无 暂无 暂无
生成式自动摘要 教程 暂无 暂无 暂无 暂无
文本语法纠错 教程 暂无 暂无 暂无 暂无
文本分类 教程 暂无 暂无 暂无 暂无
情感分析 教程 暂无 暂无 暂无 [-1,+1]
语种检测 教程 暂无 教程 暂无 ISO 639-1编码

量体裁衣,HanLP提供RESTful和native两种API,分别面向轻量级和海量级两种场景。无论何种API何种语言,HanLP接口在语义上保持一致,在代码上坚持开源。如果您在研究中使用了HanLP,请引用我们的EMNLP论文。

轻量级RESTful API

仅数KB,适合敏捷开发、移动APP等场景。简单易用,无需GPU配环境,秒速安装。语料更多、模型更大、精度更高,强烈推荐。服务器GPU算力有限,匿名用户配额较少,建议申请免费公益API秘钥auth。

Python

pip install hanlp_restful

创建客户端,填入服务器地址和秘钥:

from hanlp_restful import HanLPClient
HanLP = HanLPClient('https://www.hanlp.com/api', auth=None, language='zh') # auth不填则匿名,zh中文,mul多语种

Golang

安装 go get -u github.com/hankcs/gohanlp@main ,创建客户端,填入服务器地址和秘钥:

HanLP := hanlp.HanLPClient(hanlp.WithAuth(""),hanlp.WithLanguage("zh")) // auth不填则匿名,zh中文,mul多语种

Java

在pom.xml中添加依赖:

<dependency>
    <groupId>com.hankcs.hanlp.restful</groupId>
    <artifactId>hanlp-restful</artifactId>
    <version>0.0.12</version>
</dependency>

创建客户端,填入服务器地址和秘钥:

HanLPClient HanLP = new HanLPClient("https://www.hanlp.com/api", null, "zh"); // auth不填则匿名,zh中文,mul多语种

快速上手

无论何种开发语言,调用parse接口,传入一篇文章,得到HanLP精准的分析结果。

HanLP.parse("2021年HanLPv2.1为生产环境带来次世代最先进的多语种NLP技术。阿婆主来到北京立方庭参观自然语义科技公司。")

更多功能包括语义相似度、风格转换、指代消解等,请参考文档和测试用例。

海量级native API

依赖PyTorch、TensorFlow等深度学习技术,适合专业NLP工程师、研究者以及本地海量数据场景。要求Python 3.6至3.10,支持Windows,推荐*nix。可以在CPU上运行,推荐GPU/TPU。安装PyTorch版:

pip install hanlp

HanLP发布的模型分为多任务和单任务两种,多任务速度快省显存,单任务精度高更灵活。

多任务模型

HanLP的工作流程为加载模型然后将其当作函数调用,例如下列联合多任务模型:

import hanlp
HanLP = hanlp.load(hanlp.pretrained.mtl.CLOSE_TOK_POS_NER_SRL_DEP_SDP_CON_ELECTRA_SMALL_ZH) # 世界最大中文语料库
HanLP(['2021年HanLPv2.1为生产环境带来次世代最先进的多语种NLP技术。', '阿婆主来到北京立方庭参观自然语义科技公司。'])

Native API的输入单位为句子,需使用多语种分句模型或基于规则的分句函数先行分句。RESTful和native两种API的语义设计完全一致,用户可以无缝互换。简洁的接口也支持灵活的参数,常用的技巧有:

单任务模型

根据我们的最新研究,多任务学习的优势在于速度和显存,然而精度往往不如单任务模型。所以,HanLP预训练了许多单任务模型并设计了优雅的流水线模式将其组装起来。

import hanlp
HanLP = hanlp.pipeline() \
    .append(hanlp.utils.rules.split_sentence, output_key='sentences') \
    .append(hanlp.load('FINE_ELECTRA_SMALL_ZH'), output_key='tok') \
    .append(hanlp.load('CTB9_POS_ELECTRA_SMALL'), output_key='pos') \
    .append(hanlp.load('MSRA_NER_ELECTRA_SMALL_ZH'), output_key='ner', input_key='tok') \
    .append(hanlp.load('CTB9_DEP_ELECTRA_SMALL', conll=0), output_key='dep', input_key='tok')\
    .append(hanlp.load('CTB9_CON_ELECTRA_SMALL'), output_key='con', input_key='tok')
HanLP('2021年HanLPv2.1为生产环境带来次世代最先进的多语种NLP技术。阿婆主来到北京立方庭参观自然语义科技公司。')

更多功能,请参考demo和文档了解更多模型与用法。

输出格式

无论何种API何种开发语言何种自然语言,HanLP的输出统一为json格式兼容dict的Document:

{
  "tok/fine": [
    ["2021年", "HanLPv2.1", "为", "生产", "环境", "带来", "次", "世代", "最", "先进", "的", "多", "语种", "NLP", "技术", "。"],
    ["阿婆主", "来到", "北京", "立方庭", "参观", "自然", "语义", "科技", "公司", "。"]
  ],
  "tok/coarse": [
    ["2021年", "HanLPv2.1", "为", "生产", "环境", "带来", "次世代", "最", "先进", "的", "多语种", "NLP", "技术", "。"],
    ["阿婆主", "来到", "北京立方庭", "参观", "自然语义科技公司", "。"]
  ],
  "pos/ctb": [
    ["NT", "NR", "P", "NN", "NN", "VV", "JJ", "NN", "AD", "JJ", "DEG", "CD", "NN", "NR", "NN", "PU"],
    ["NN", "VV", "NR", "NR", "VV", "NN", "NN", "NN", "NN", "PU"]
  ],
  "pos/pku": [
    ["t", "nx", "p", "vn", "n", "v", "b", "n", "d", "a", "u", "a", "n", "nx", "n", "w"],
    ["n", "v", "ns", "ns", "v", "n", "n", "n", "n", "w"]
  ],
  "pos/863": [
    ["nt", "w", "p", "v", "n", "v", "a", "nt", "d", "a", "u", "a", "n", "ws", "n", "w"],
    ["n", "v", "ns", "n", "v", "n", "n", "n", "n", "w"]
  ],
  "ner/pku": [
    [],
    [["北京立方庭", "ns", 2, 4], ["自然语义科技公司", "nt", 5, 9]]
  ],
  "ner/msra": [
    [["2021年", "DATE", 0, 1], ["HanLPv2.1", "ORGANIZATION", 1, 2]],
    [["北京", "LOCATION", 2, 3], ["立方庭", "LOCATION", 3, 4], ["自然语义科技公司", "ORGA

HanLP (hankcs/HanLP)

Searching Database…

36.5K ·GitHub
这是什么?HanLP 是一个面向生产环境的多语言 NLP 工具包,基于 PyTorch/TensorFlow 2.x 双引擎构建,支持 130 种语言,并提供十项联合任务,包括分词、词性标注、命名实体识别(NER)、依存句法和成分句法分析、语义角色标注以及文本分类。
这是我可以导入的库,还是我需要调用的托管 API?两者都有——HanLP 提供轻量级的 RESTful API(无需配置 GPU),也提供基于 PyTorch 或 TensorFlow 的原生 Python 包,用于更重的本地处理。
我该如何开始使用?快速使用的话,用 Python、Go 或 Java 创建客户端,并凭免费的认证密钥调用 RESTful API;如果需要本地或大规模使用,则安装原生 PyTorch/TensorFlow 包,并加载预训练的多任务或单任务模型。
RESTful API 是免费的,而且没有任何限制吗?API 是免费的,但匿名用户的配额有限,因为服务器的 GPU 资源有限;HanLP 建议申请免费的公共 API 密钥,以获得更充裕的使用额度。
它在 Windows、macOS 和 Linux 上的表现一致吗?一致——每个版本都在 Linux、macOS 和 Windows 上,基于 Python 3.6 至 3.10 进行了单元测试,因此三个系统上的安装应该都没有问题。
结果以什么格式返回?无论来自 REST 还是原生 API,每个任务的结果都会以统一的、兼容 JSON 的 'Document' 对象返回,其中 tok/fine、pos/ctb 和 ner/msra 等键会把任务名称映射到对应的输出。
我能给分词器添加自定义词语吗?可以,HanLP 内置了高效的基于 trie 树的自定义词典,支持强制、合并和修正三种规则模式,并能无缝叠加在统计模型之上使用。
HanLP 实际覆盖多少种语言和任务?2.1 版本支持 130 种语言,包括简体/繁体中文、英语、日语、俄语、法语和德语,并提供十项联合任务,以及许多额外的单任务模型。
在研究中使用 HanLP,我需要引用什么吗?需要。作者发表了一篇描述 HanLP 架构的 EMNLP 论文,并希望使用 HanLP 的研究引用该论文。
Creator
hankcs
Size
71.1 MB
Stars
36.5K
Age
12y
Commits · 90 Days