


Что это такое?
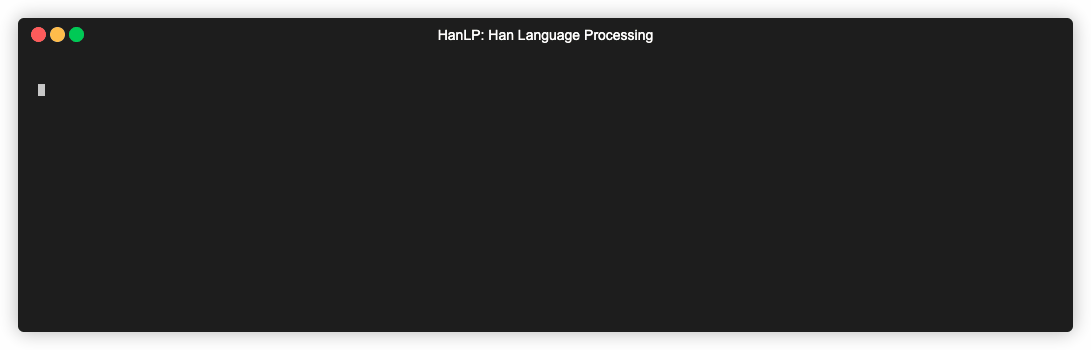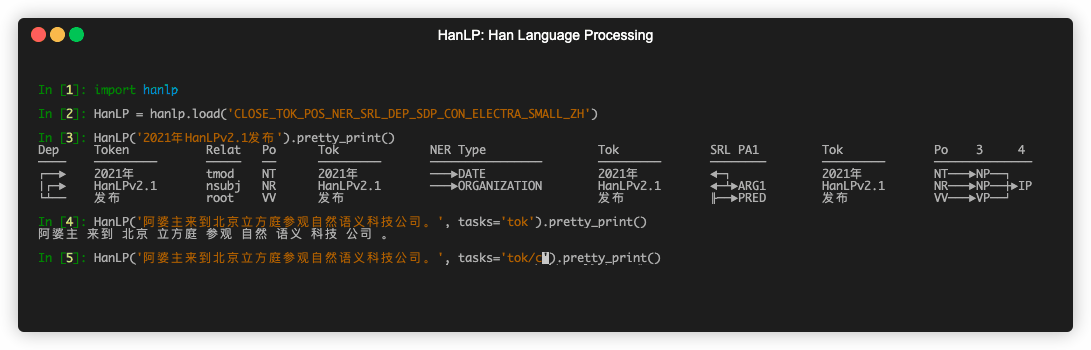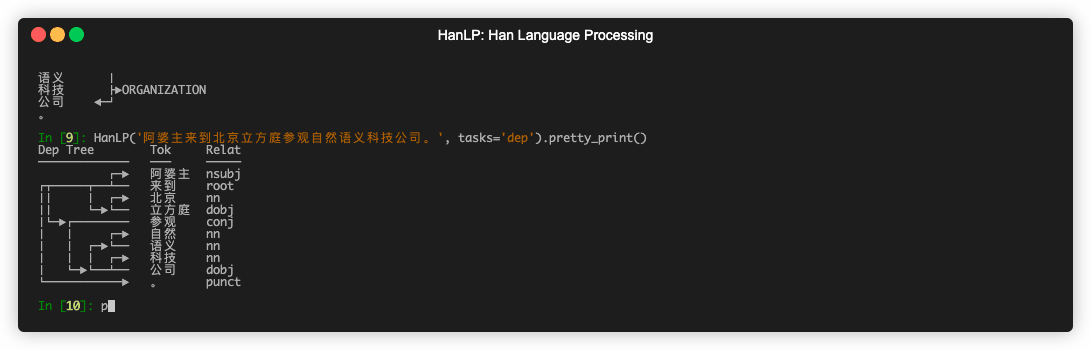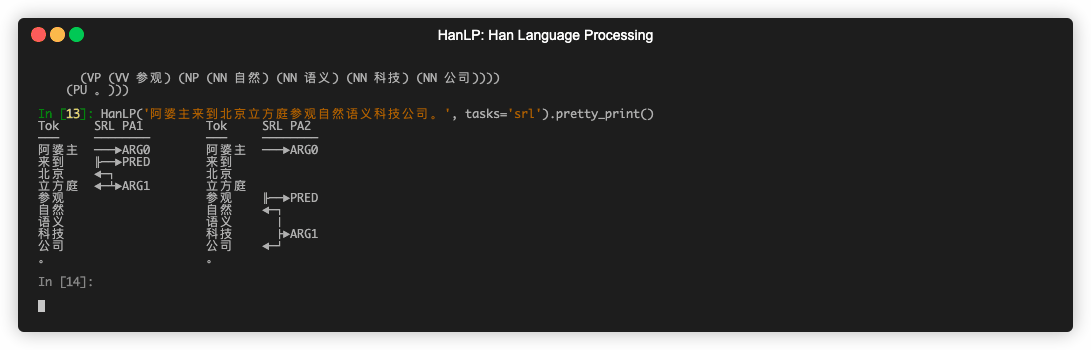
 HanLP — это инструментарий для обработки естественного языка, рассчитанный на промышленное использование и работающий с несколькими языками. Он построен на двух движках: PyTorch и TensorFlow 2.x. Поддерживает 130 языков и десять совместных задач, таких как токенизация, разметка частей речи, распознавание именованных сущностей, синтаксический разбор зависимостей и составляющих, разметка семантических ролей и классификация текста.
Это библиотека, которую я подключаю в код, или API на сервере, к которому я обращаюсь?Верно и то и другое: HanLP предлагает облегчённый RESTful API (не нужна настройка GPU) и нативный пакет для Python, который работает на PyTorch или TensorFlow и подходит для более тяжёлой обработки на своём компьютере.
Верно и то и другое: HanLP предлагает облегчённый RESTful API (не нужна настройка GPU) и нативный пакет для Python, который работает на PyTorch или TensorFlow и подходит для более тяжёлой обработки на своём компьютере.Как начать пользоваться?Для быстрого старта создайте клиент на Python, Go или Java и вызывайте RESTful API с бесплатным ключом авторизации. Для локального или масштабного использования установите нативный пакет PyTorch/TensorFlow и загрузите предобученную многозадачную или однозадачную модель.
Для быстрого старта создайте клиент на Python, Go или Java и вызывайте RESTful API с бесплатным ключом авторизации. Для локального или масштабного использования установите нативный пакет PyTorch/TensorFlow и загрузите предобученную многозадачную или однозадачную модель.RESTful API бесплатный без каких-либо ограничений?Он бесплатный, но анонимные пользователи получают ограниченную квоту, потому что ресурсы GPU на сервере конечны. HanLP рекомендует подать заявку на бесплатный публичный ключ API для более щедрого доступа.
Он бесплатный, но анонимные пользователи получают ограниченную квоту, потому что ресурсы GPU на сервере конечны. HanLP рекомендует подать заявку на бесплатный публичный ключ API для более щедрого доступа.Одинаково ли это работает на Windows, macOS и Linux?Да. Каждый релиз проходит модульное тестирование на Linux, macOS и Windows для версий Python от 3.6 до 3.10, так что установка должна работать без проблем на всех трёх системах.
Да. Каждый релиз проходит модульное тестирование на Linux, macOS и Windows для версий Python от 3.6 до 3.10, так что установка должна работать без проблем на всех трёх системах.В каком формате возвращаются результаты?Результат каждой задачи, будь то через REST или нативный API, возвращается в едином JSON-совместимом объекте 'Document'. Ключи вроде tok/fine, pos/ctb и ner/msra связывают названия задач с их результатами.
Результат каждой задачи, будь то через REST или нативный API, возвращается в едином JSON-совместимом объекте 'Document'. Ключи вроде tok/fine, pos/ctb и ner/msra связывают названия задач с их результатами.Можно ли добавить свои слова в токенизатор?Да. В HanLP есть эффективный пользовательский словарь на основе префиксного дерева с режимами принудительного, объединяющего и корректирующего правила. Эти правила без проблем применяются поверх статистических моделей.
Да. В HanLP есть эффективный пользовательский словарь на основе префиксного дерева с режимами принудительного, объединяющего и корректирующего правила. Эти правила без проблем применяются поверх статистических моделей.Сколько языков и задач на самом деле охватывает HanLP?Версия 2.1 поддерживает 130 языков, включая упрощённый и традиционный китайский, английский, японский, русский, французский и немецкий. Также есть десять совместных задач и множество дополнительных однозадачных моделей.
Версия 2.1 поддерживает 130 языков, включая упрощённый и традиционный китайский, английский, японский, русский, французский и немецкий. Также есть десять совместных задач и множество дополнительных однозадачных моделей.Нужно ли что-то цитировать, если я использую HanLP в исследованиях?Да. Авторы опубликовали статью на EMNLP, в которой описана архитектура HanLP, и просят цитировать эту статью в исследованиях, где используется инструмент.
Да. Авторы опубликовали статью на EMNLP, в которой описана архитектура HanLP, и просят цитировать эту статью в исследованиях, где используется инструмент.What are similar projects?spaCy, funNLP, CoreNLP, bert, flair, Chinese-Word-Vectors, awesome-nlp, allennlp
spaCy, funNLP, CoreNLP, bert, flair, Chinese-Word-Vectors, awesome-nlp, allennlpWhich topics is it in?nlp-library, chinese-nlp, named-entity-recognition, text-classification, sentiment-analysis, tokenization, tensorflow, natural-language-processing, transformer, multilingual, nlp, pytorch
nlp-library, chinese-nlp, named-entity-recognition, text-classification, sentiment-analysis, tokenization, tensorflow, natural-language-processing, transformer, multilingual, nlp, pytorch