


What is this?
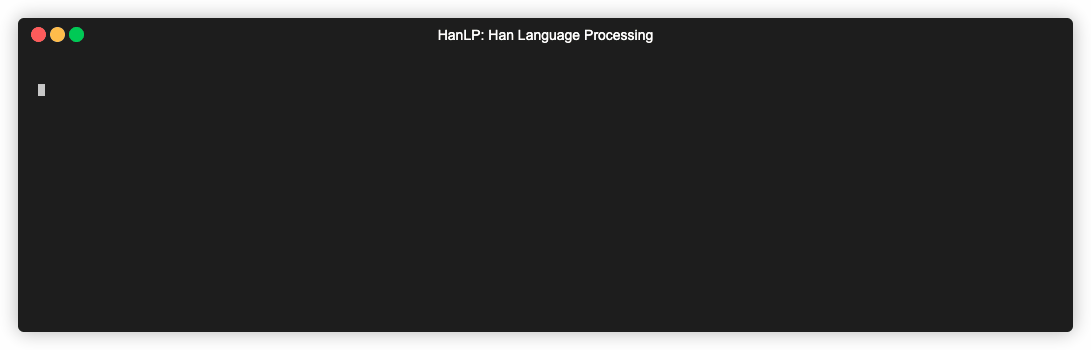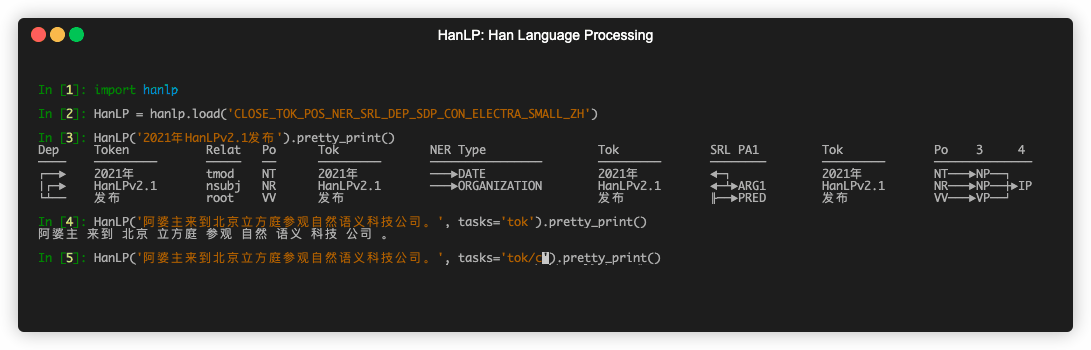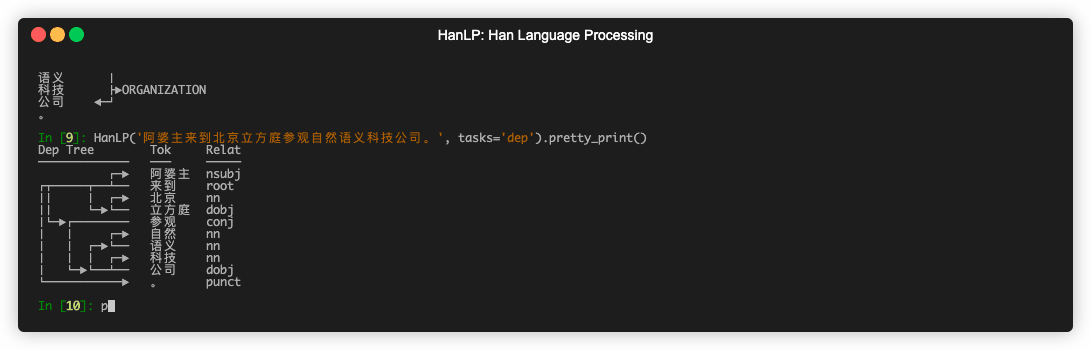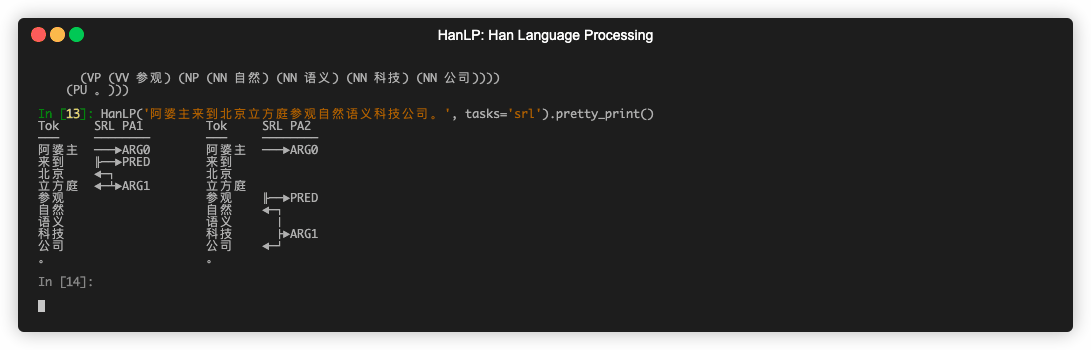
 HanLP is a production-oriented, multilingual NLP toolkit built on dual PyTorch/TensorFlow 2.x engines, supporting 130 languages with ten joint tasks such as tokenization, POS tagging, NER, dependency and constituency parsing, semantic role labeling, and text classification.
Is this a library I import, or a hosted API I call?Both — HanLP offers a lightweight RESTful API (no GPU setup needed) and a native Python package backed by PyTorch or TensorFlow for heavier local processing.
Both — HanLP offers a lightweight RESTful API (no GPU setup needed) and a native Python package backed by PyTorch or TensorFlow for heavier local processing.How do I start using it?For quick use, create a client in Python, Go, or Java and call the RESTful API with a free auth key; for local or large-scale use, install the native PyTorch/TensorFlow package and load a pretrained multi-task or single-task model.
For quick use, create a client in Python, Go, or Java and call the RESTful API with a free auth key; for local or large-scale use, install the native PyTorch/TensorFlow package and load a pretrained multi-task or single-task model.Is the RESTful API free without any limits?It's free, but anonymous users get a limited quota because server GPU capacity is finite; HanLP recommends applying for a free public API key for more generous access.
It's free, but anonymous users get a limited quota because server GPU capacity is finite; HanLP recommends applying for a free public API key for more generous access.Does it work the same on Windows, macOS, and Linux?Yes — every release is unit tested on Linux, macOS, and Windows across Python 3.6 to 3.10, so installation should work without issues on all three.
Yes — every release is unit tested on Linux, macOS, and Windows across Python 3.6 to 3.10, so installation should work without issues on all three.What format do the results come back in?Every task result, whether from the REST or native API, is returned as a unified JSON-compatible 'Document' object, with keys like tok/fine, pos/ctb, and ner/msra mapping task names to their outputs.
Every task result, whether from the REST or native API, is returned as a unified JSON-compatible 'Document' object, with keys like tok/fine, pos/ctb, and ner/msra mapping task names to their outputs.Can I add my own custom words to the tokenizer?Yes, HanLP includes an efficient trie-based custom dictionary with forced, merged, and corrective rule modes that apply seamlessly on top of the statistical models.
Yes, HanLP includes an efficient trie-based custom dictionary with forced, merged, and corrective rule modes that apply seamlessly on top of the statistical models.How many languages and tasks does HanLP actually cover?Version 2.1 supports 130 languages including simplified/traditional Chinese, English, Japanese, Russian, French, and German, with ten joint tasks plus many additional single-task models.
Version 2.1 supports 130 languages including simplified/traditional Chinese, English, Japanese, Russian, French, and German, with ten joint tasks plus many additional single-task models.Should I cite anything if I use HanLP in research?Yes, the authors published an EMNLP paper describing HanLP's architecture and ask that research using it cite that paper.
Yes, the authors published an EMNLP paper describing HanLP's architecture and ask that research using it cite that paper.What are similar projects?spaCy, funNLP, CoreNLP, bert, flair, Chinese-Word-Vectors, awesome-nlp, allennlp
spaCy, funNLP, CoreNLP, bert, flair, Chinese-Word-Vectors, awesome-nlp, allennlpWhich topics is it in?nlp-library, chinese-nlp, named-entity-recognition, text-classification, sentiment-analysis, tokenization, tensorflow, natural-language-processing, transformer, multilingual, nlp, pytorch
nlp-library, chinese-nlp, named-entity-recognition, text-classification, sentiment-analysis, tokenization, tensorflow, natural-language-processing, transformer, multilingual, nlp, pytorch