

Что это такое?
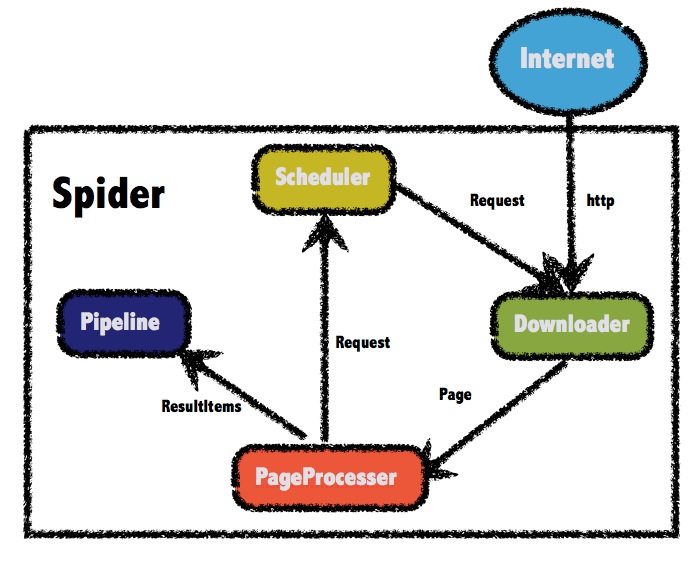
 WebMagic — это расширяемый фреймворк для веб-краулеров на Java. Он закрывает весь жизненный цикл краулера — скачивание страниц, управление URL, извлечение контента и сохранение результатов — чтобы упростить создание конкретного краулера.
Это готовый краулер, который можно просто запустить, или фреймворк, на котором я напишу свой?Это фреймворк, а не готовый краулер: вы пишете небольшой Java-класс, описывающий, что скачивать и что извлекать, а WebMagic берёт на себя весь конвейер вокруг него.
Это фреймворк, а не готовый краулер: вы пишете небольшой Java-класс, описывающий, что скачивать и что извлекать, а WebMagic берёт на себя весь конвейер вокруг него.Как добавить его в свой проект и запустить первый краулер?Добавьте зависимости WebMagic в свой pom.xml, затем напишите класс, реализующий интерфейс PageProcessor — в примере из README это краулер, собирающий информацию о репозиториях GitHub.
Добавьте зависимости WebMagic в свой pom.xml, затем напишите класс, реализующий интерфейс PageProcessor — в примере из README это краулер, собирающий информацию о репозиториях GitHub.Есть ли подводные камни с зависимостями?WebMagic логирует через slf4j и поставляется вместе с биндингом slf4j-log4j12; если вы используете свою реализацию slf4j, исключите slf4j-log4j12, чтобы избежать конфликтов.
WebMagic логирует через slf4j и поставляется вместе с биндингом slf4j-log4j12; если вы используете свою реализацию slf4j, исключите slf4j-log4j12, чтобы избежать конфликтов.Это что-то вроде Scrapy, только для Java?По сути да — архитектура явно построена по образцу Scrapy, фреймворка краулеров на Python; в README в качестве источника идей также упоминается Spiderman, более ранний Java-фреймворк для краулеров.
По сути да — архитектура явно построена по образцу Scrapy, фреймворка краулеров на Python; в README в качестве источника идей также упоминается Spiderman, более ранний Java-фреймворк для краулеров.Мне всегда нужно реализовывать PageProcessor, или есть способ попроще?Нет — краулер можно описать и аннотациями на обычном Java-POJO, вообще без конфигурации.
Нет — краулер можно описать и аннотациями на обычном Java-POJO, вообще без конфигурации.Как указать краулеру, по каким ссылкам идти дальше?Внутри вашего процессора вызовите page.addTargetRequests(links), чтобы поставить найденные на странице URL в очередь на обход.
Внутри вашего процессора вызовите page.addTargetRequests(links), чтобы поставить найденные на странице URL в очередь на обход.What are similar projects?crawlee, colly, Scrapegraph-ai, firecrawl, MediaCrawler, crawlab, scrapy, DrissionPage
crawlee, colly, Scrapegraph-ai, firecrawl, MediaCrawler, crawlab, scrapy, DrissionPageWhich topics is it in?scalable, web-crawler, scraper, multithreading, scraping, crawler, parser, web-scraping, http, distributed-systems, java, html
scalable, web-crawler, scraper, multithreading, scraping, crawler, parser, web-scraping, http, distributed-systems, java, html