




Что это такое?
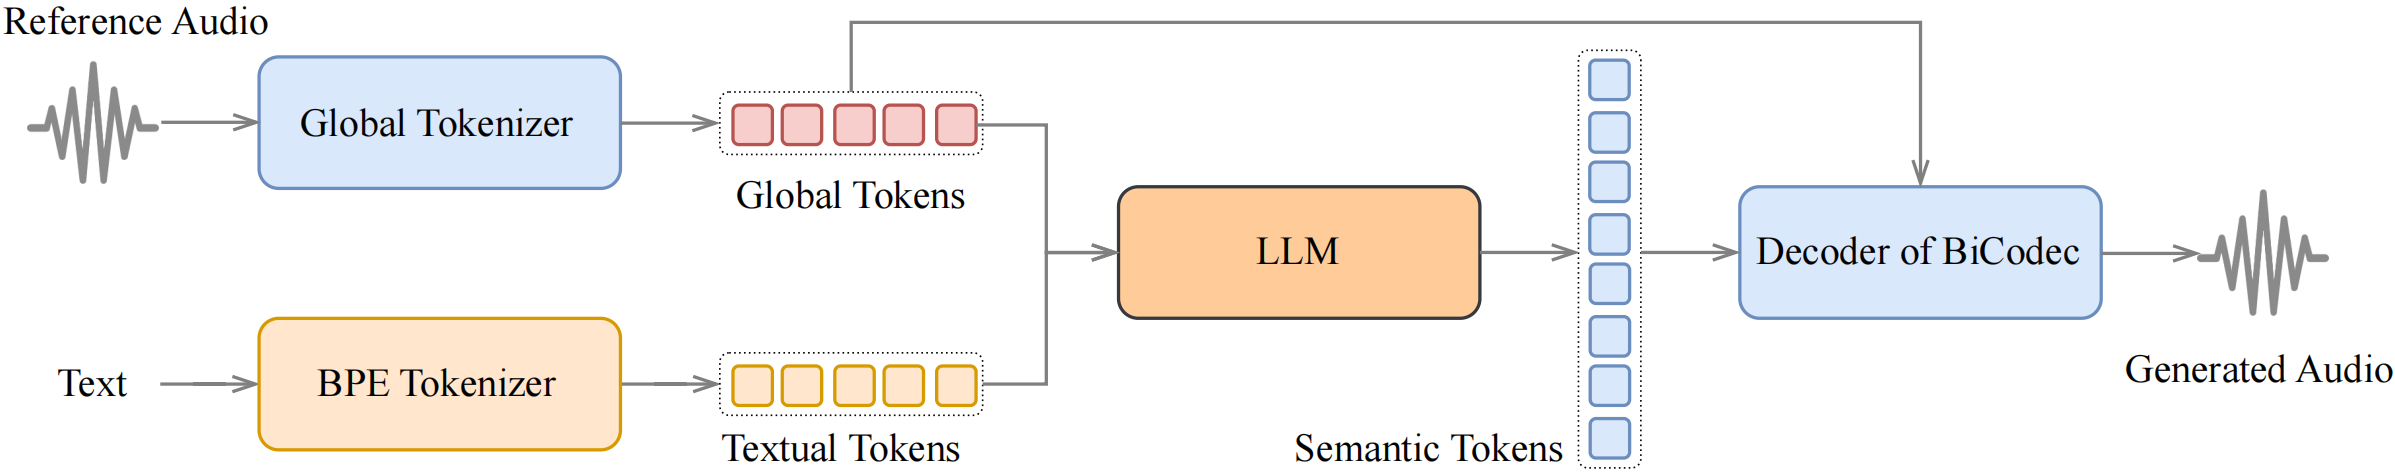
 Spark-TTS — это система синтеза речи по тексту, которая использует большую языковую модель (построенную на Qwen2.5) для генерации очень естественной и точной речи, включая клонирование голоса без обучения на образце (zero-shot).
Это готовое приложение или код, который я запускаю сам?Это код для инференса на PyTorch, который вы запускаете самостоятельно: через CLI-скрипты или через встроенный веб-интерфейс в стиле Gradio (webui.py). Это не готовое приложение.
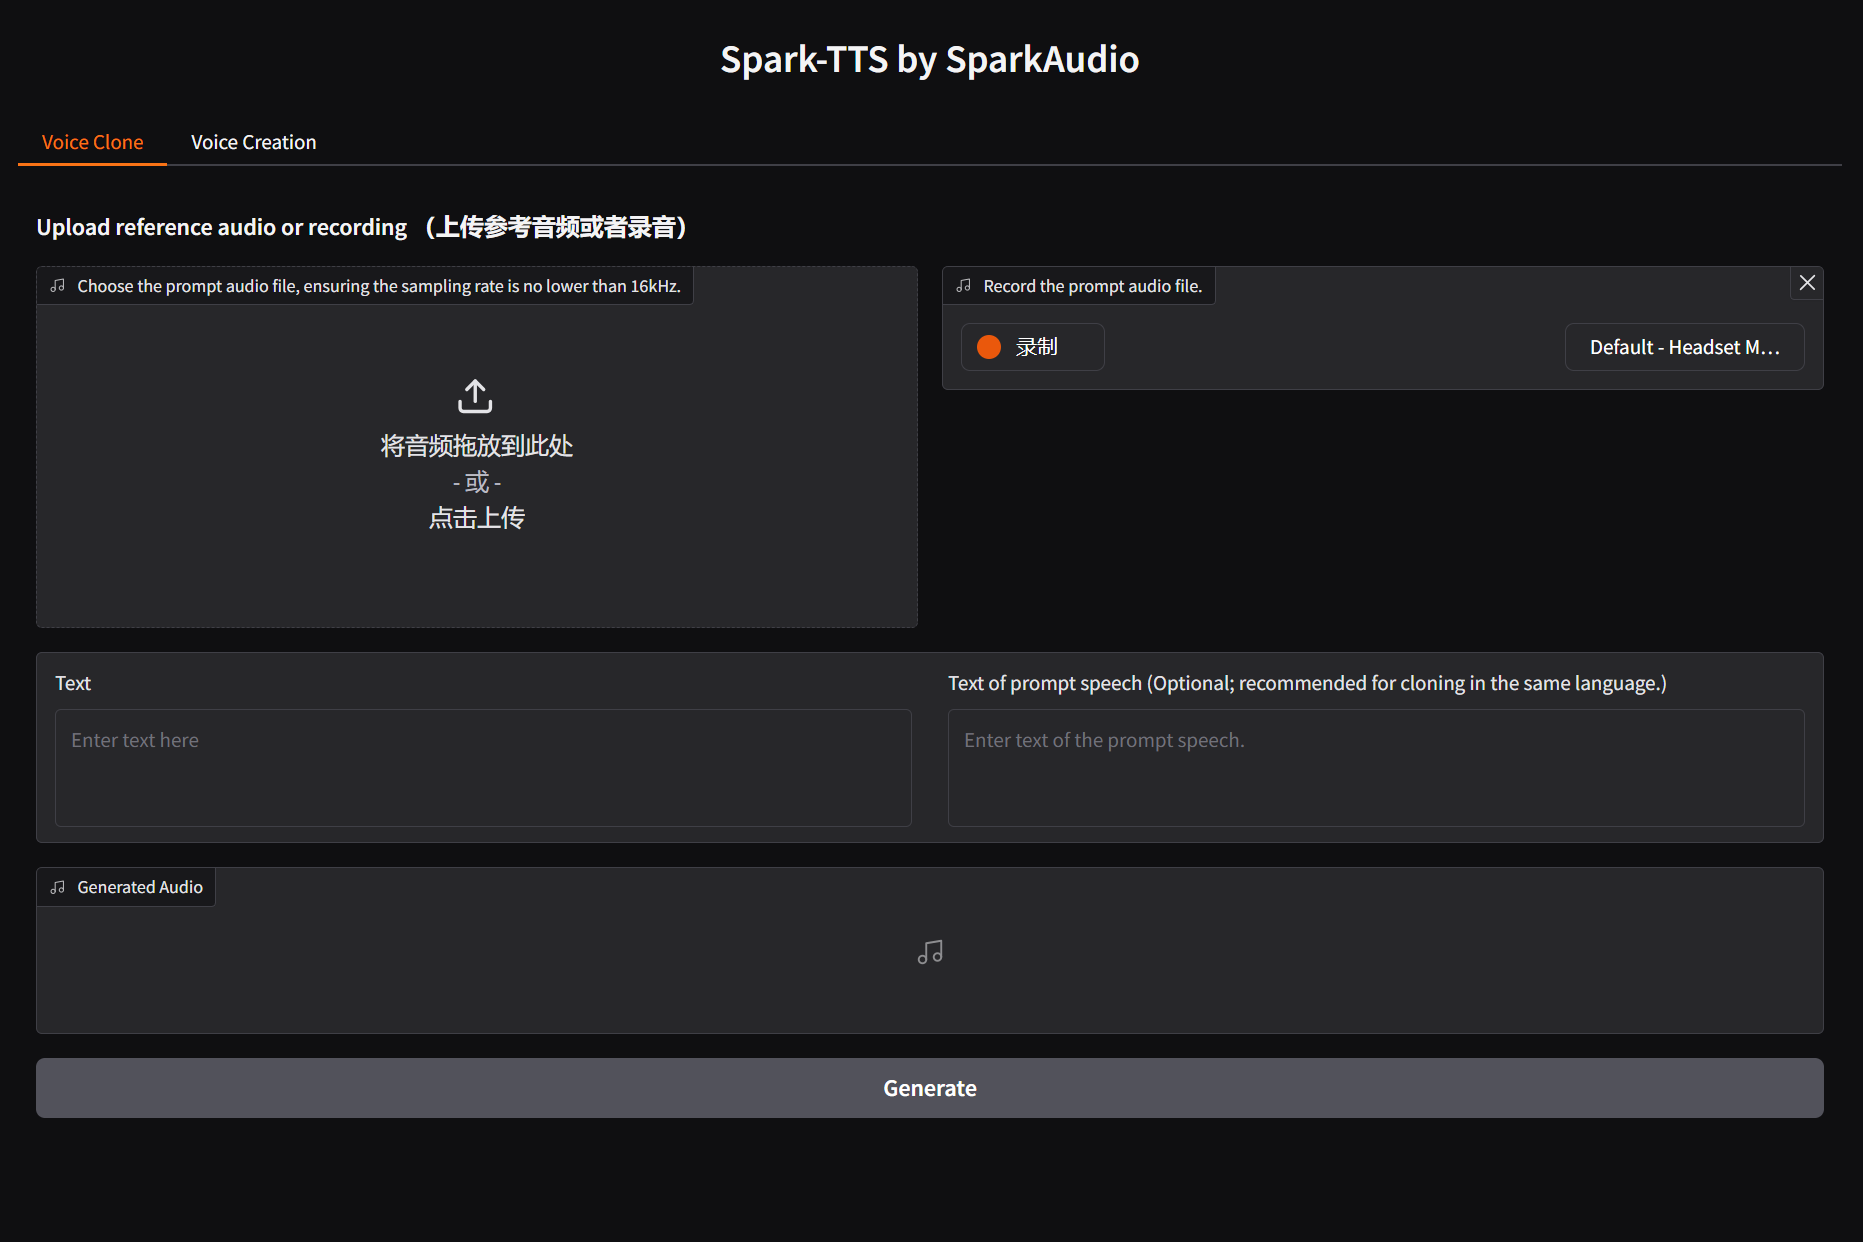
Это код для инференса на PyTorch, который вы запускаете самостоятельно: через CLI-скрипты или через встроенный веб-интерфейс в стиле Gradio (webui.py). Это не готовое приложение.Как это запустить?Склонируйте репозиторий, создайте окружение Conda, скачайте модель (через python или git clone), затем запустите демо через CLI или веб-интерфейс командой 'python webui.py --device 0'.
Склонируйте репозиторий, создайте окружение Conda, скачайте модель (через python или git clone), затем запустите демо через CLI или веб-интерфейс командой 'python webui.py --device 0'.Что нужно установить перед тем, как попробовать?Нужны Conda для настройки окружения Python и скачанные веса модели Spark-TTS. О том, что нужна видеокарта (GPU), говорят бенчмарки Nvidia Triton для serving.
Нужны Conda для настройки окружения Python и скачанные веса модели Spark-TTS. О том, что нужна видеокарта (GPU), говорят бенчмарки Nvidia Triton для serving.Код обучения тоже доступен?Нет, пока опубликован только код инференса. Код обучения и обучающий датасет VoxBox пока в планах и ещё не выложены.
Нет, пока опубликован только код инференса. Код обучения и обучающий датасет VoxBox пока в планах и ещё не выложены.Работает только на Linux?Основные инструкции рассчитаны на Linux, но есть отдельное руководство по установке для Windows, написанное участниками сообщества, поэтому запустить его можно и на Windows.
Основные инструкции рассчитаны на Linux, но есть отдельное руководство по установке для Windows, написанное участниками сообщества, поэтому запустить его можно и на Windows.Нужно знать о каком-нибудь отказе от ответственности при использовании?Да, авторы прямо предупреждают, что нельзя использовать его для клонирования голоса без разрешения, выдачи себя за другого человека, мошенничества или создания дипфейков. Авторы не несут ответственности за неправильное использование.
Да, авторы прямо предупреждают, что нельзя использовать его для клонирования голоса без разрешения, выдачи себя за другого человека, мошенничества или создания дипфейков. Авторы не несут ответственности за неправильное использование.Может ли он говорить на нескольких языках?Да, есть двуязычная поддержка китайского и английского. Он умеет клонировать голос при переходе между языками (zero-shot cross-lingual) и переключаться между языками внутри фразы (code-switching), то есть менять язык прямо во время речи, сохраняя тот же клонированный голос.
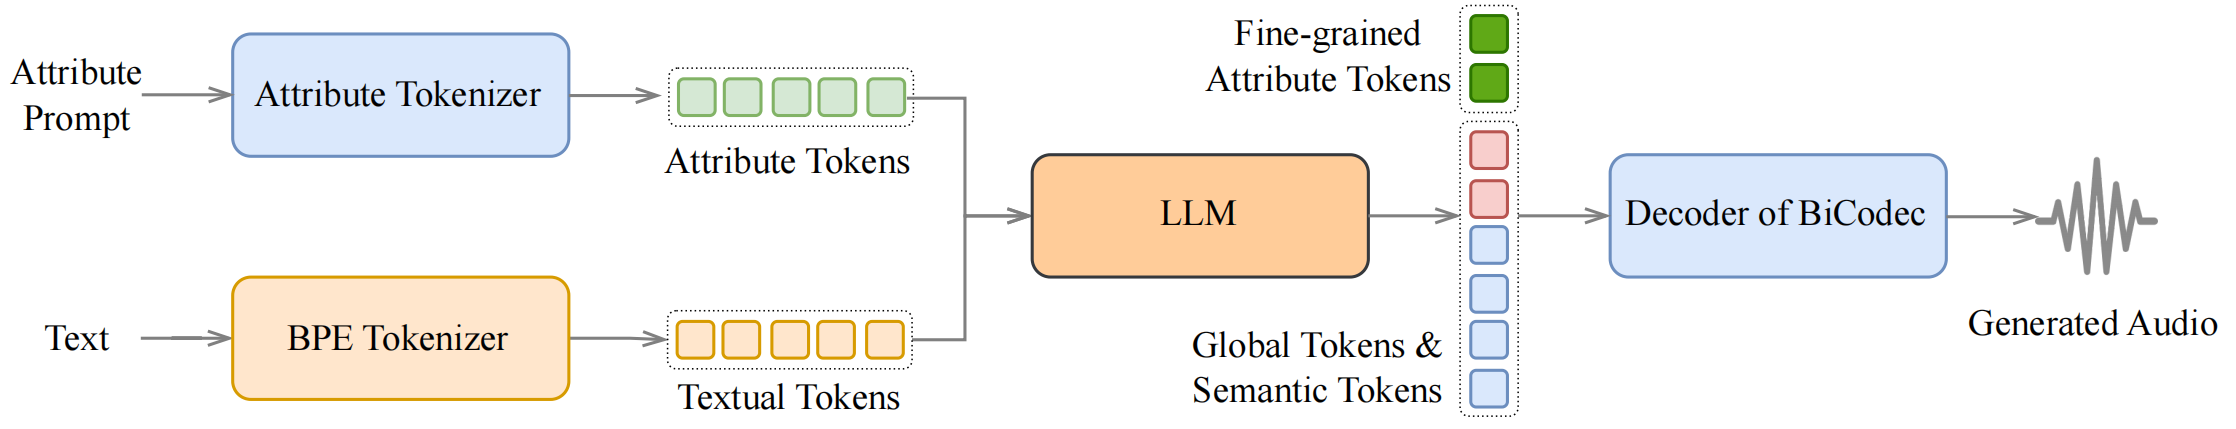
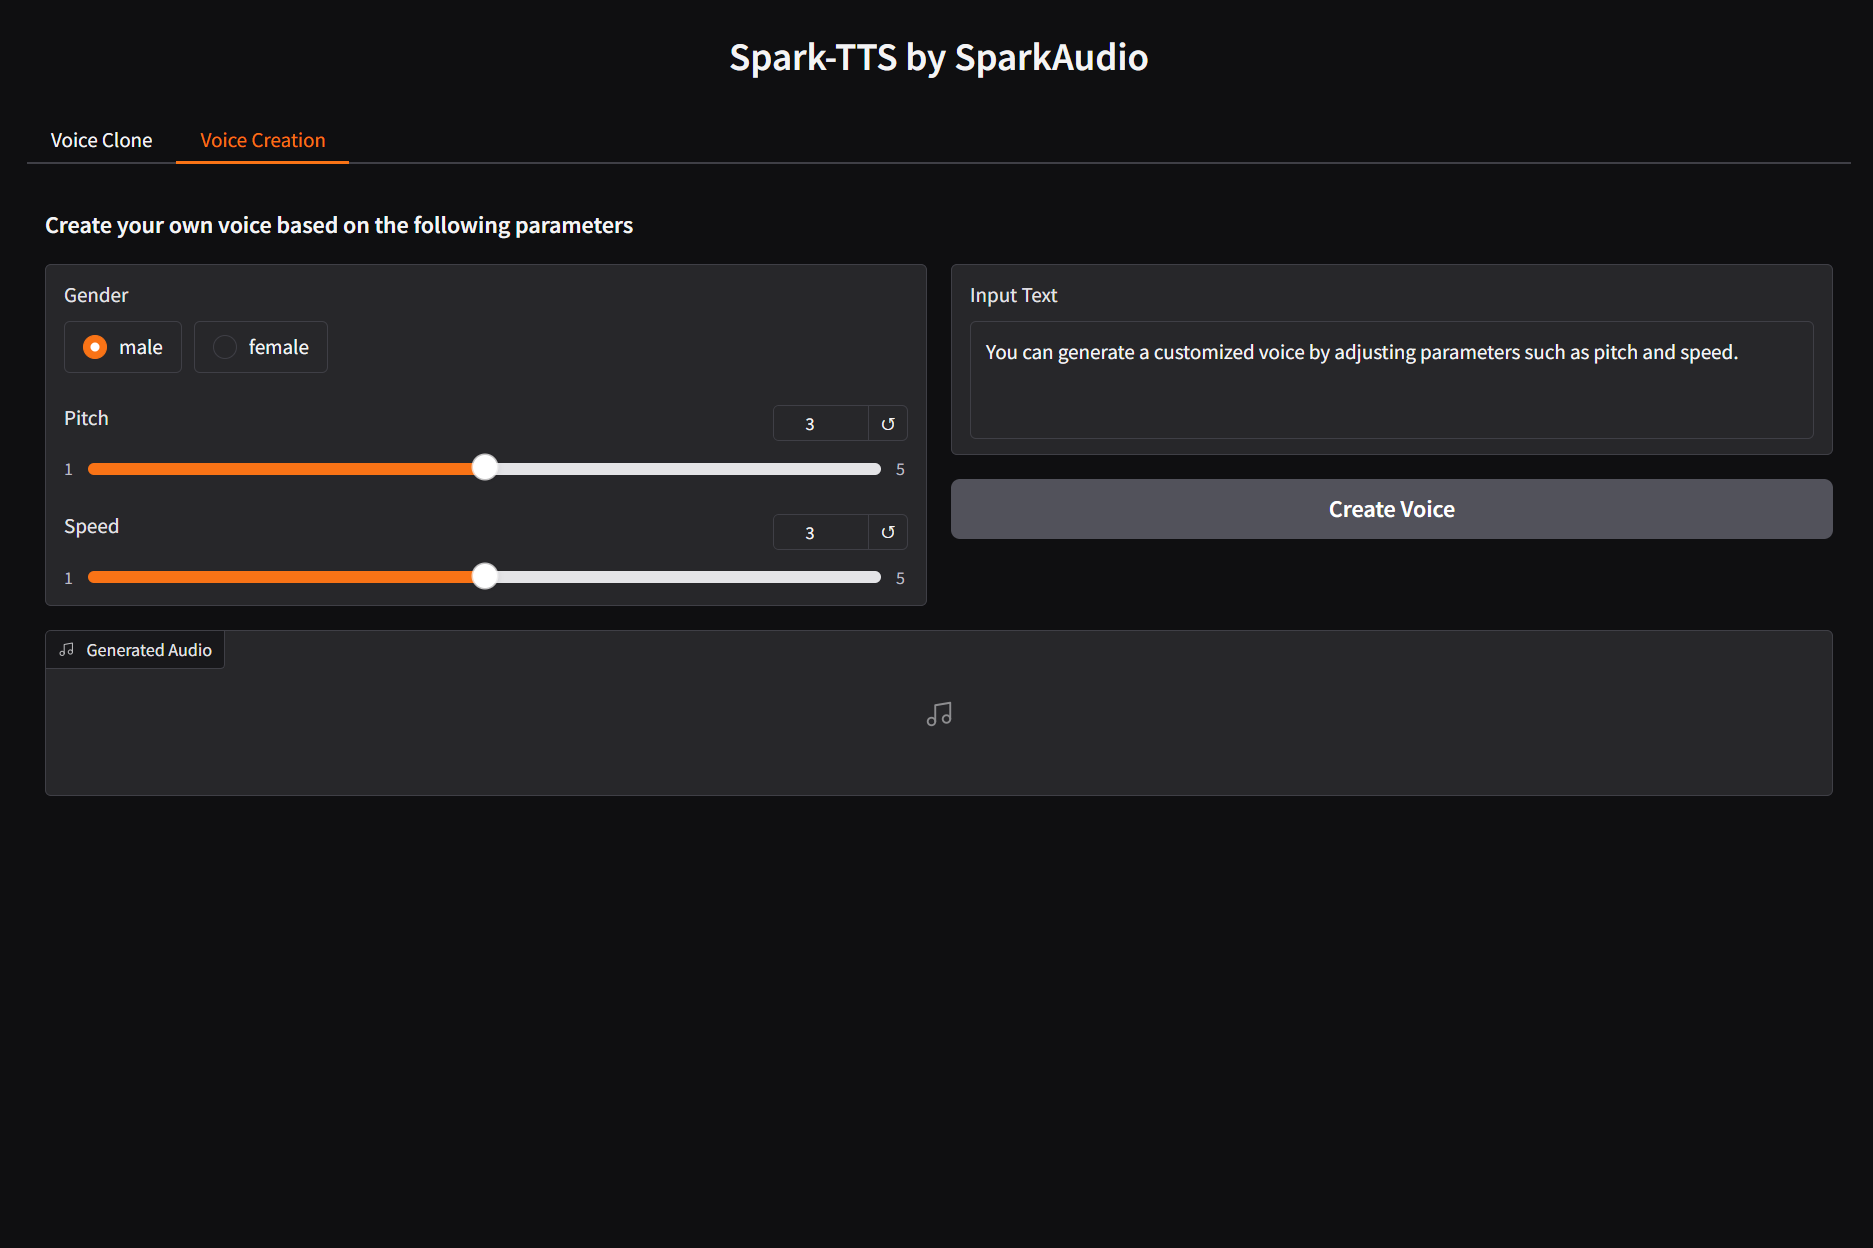
Да, есть двуязычная поддержка китайского и английского. Он умеет клонировать голос при переходе между языками (zero-shot cross-lingual) и переключаться между языками внутри фразы (code-switching), то есть менять язык прямо во время речи, сохраняя тот же клонированный голос.Можно ли создать синтетический голос без эталонной записи?Да, в режиме создания голоса веб-интерфейса можно собрать виртуального диктора, настраивая такие параметры, как пол, высота тона и скорость речи, вместо клонирования существующего голоса.
Да, в режиме создания голоса веб-интерфейса можно собрать виртуального диктора, настраивая такие параметры, как пол, высота тона и скорость речи, вместо клонирования существующего голоса.Насколько он быстр для продакшн-сервиса?Бенчмарки на одной видеокарте Nvidia L20 с Triton и TensorRT-LLM показывают среднюю задержку примерно от 876 мс до 1,6 с в зависимости от количества параллельных запросов, а RTF составляет всего 0,07.
Бенчмарки на одной видеокарте Nvidia L20 с Triton и TensorRT-LLM показывают среднюю задержку примерно от 876 мс до 1,6 с в зависимости от количества параллельных запросов, а RTF составляет всего 0,07.Почему обходятся без моделей flow-matching, как другие TTS-системы?Spark-TTS полностью построен на Qwen2.5 и восстанавливает звук напрямую из кодов, которые предсказывает языковая модель. Поэтому не нужна отдельная модель генерации акустических признаков, и конвейер проще.
Spark-TTS полностью построен на Qwen2.5 и восстанавливает звук напрямую из кодов, которые предсказывает языковая модель. Поэтому не нужна отдельная модель генерации акустических признаков, и конвейер проще.What are similar projects?breeze-tts, VoxCPM, fish-speech, OmniVoice, Index-Translate, Speech, MOSS-TTS, MOSS-TTS-Nano
breeze-tts, VoxCPM, fish-speech, OmniVoice, Index-Translate, Speech, MOSS-TTS, MOSS-TTS-NanoWhich topics is it in?triton, bilingual, speech-synthesis, voice-cloning, tts, text-to-speech, multilingual, inference, nvidia, command-line-tool, research, gpu
triton, bilingual, speech-synthesis, voice-cloning, tts, text-to-speech, multilingual, inference, nvidia, command-line-tool, research, gpu