



196 ·GitHub
这是什么?
 MatAnyone-E 是一个用于高分辨率视频抠像的研究模型,即把视频分离为前景和背景并生成 alpha 遮罩。与原版 MatAnyone 2 相比,它的运行速度快得多,所需 GPU 显存也少得多,同时仍能保留发丝等细节。
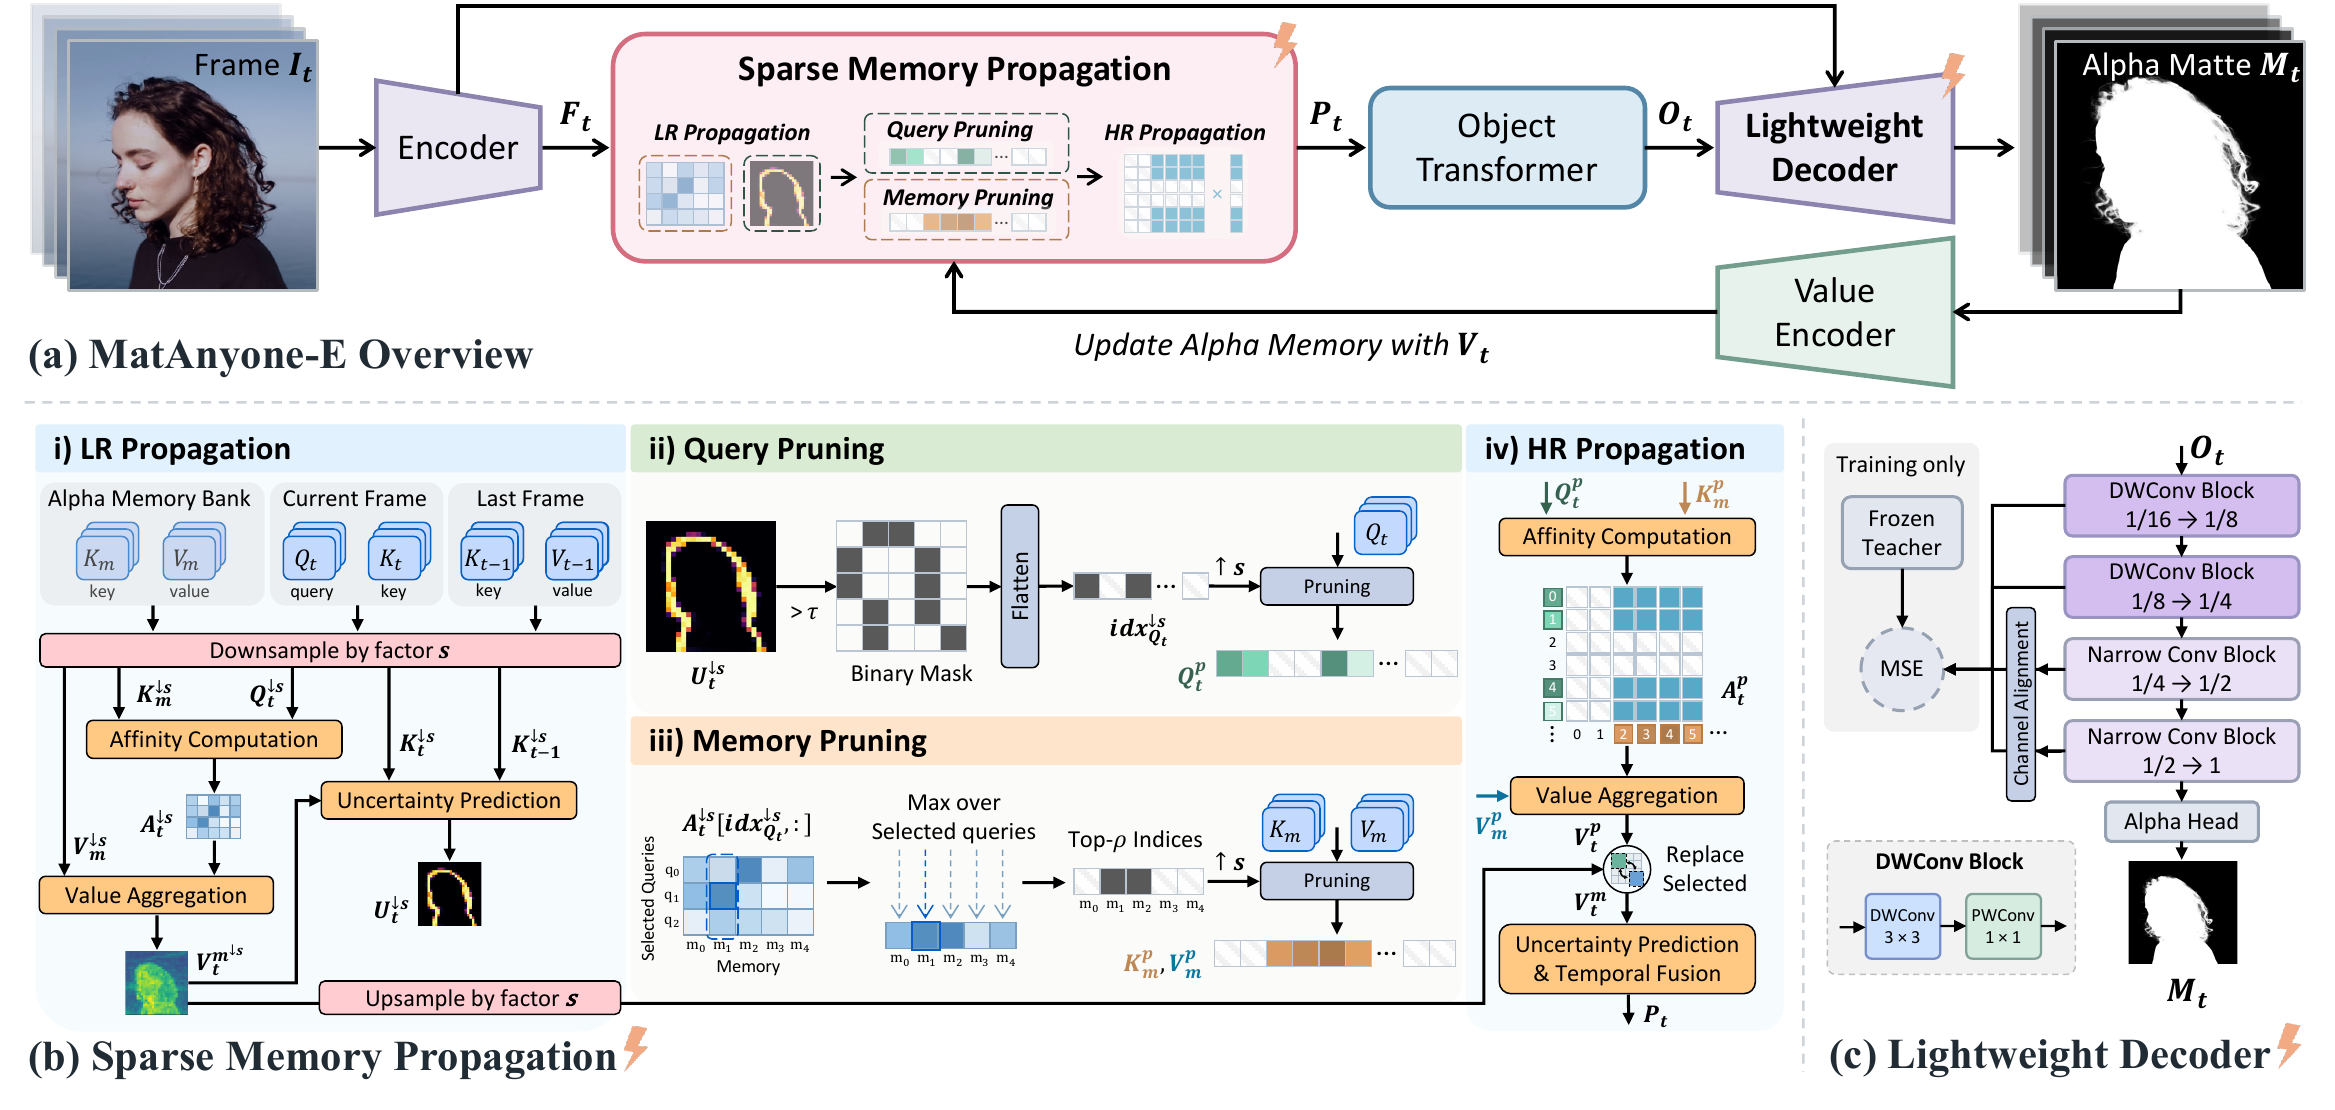
这是一个全新的模型,还是某个已有模型的改进版本?它保留了 MatAnyone 2 的架构,但替换了两个随分辨率提升而成本增长最快的部分:一个是稀疏记忆传播模块,它只对经过修剪的查询与记忆配对进行高分辨率匹配;另一个是通过蒸馏原版解码器训练得到的轻量级解码器。
它保留了 MatAnyone 2 的架构,但替换了两个随分辨率提升而成本增长最快的部分:一个是稀疏记忆传播模块,它只对经过修剪的查询与记忆配对进行高分辨率匹配;另一个是通过蒸馏原版解码器训练得到的轻量级解码器。我现在就能自己运行它吗?暂时不行。目前只发布了论文和项目页面;推理代码和模型权重、Hugging Face 演示以及 ComfyUI 自定义节点仍标记为 TODO。
暂时不行。目前只发布了论文和项目页面;推理代码和模型权重、Hugging Face 演示以及 ComfyUI 自定义节点仍标记为 TODO。代码发布后,我需要什么硬件?需要一块 CUDA GPU,显存大小取决于目标分辨率。论文的基准测试使用的是 NVIDIA A800-80GB 和 H200。即使使用 torch.compile 优化,原生 4K 抠像至少仍需约 3.9 GB 显存。
需要一块 CUDA GPU,显存大小取决于目标分辨率。论文的基准测试使用的是 NVIDIA A800-80GB 和 H200。即使使用 torch.compile 优化,原生 4K 抠像至少仍需约 3.9 GB 显存。无论分辨率多大,它都能保持快速和轻量吗?显存占用仍会随分辨率增长。在 4K 分辨率下,作者甚至无法直接测量 MatAnyone 2 的显存占用,只能进行推算,因为完整的记忆库无法装进 80GB 的 GPU 显存。
显存占用仍会随分辨率增长。在 4K 分辨率下,作者甚至无法直接测量 MatAnyone 2 的显存占用,只能进行推算,因为完整的记忆库无法装进 80GB 的 GPU 显存。为什么叫“稀疏记忆传播”?先通过一次低成本的低分辨率计算,找出哪些查询位置不确定,以及哪些已存储的记忆帧对它们真正有用;然后,高成本的高分辨率匹配只针对这一小部分经过修剪的配对进行,而不是对所有内容都执行。
先通过一次低成本的低分辨率计算,找出哪些查询位置不确定,以及哪些已存储的记忆帧对它们真正有用;然后,高成本的高分辨率匹配只针对这一小部分经过修剪的配对进行,而不是对所有内容都执行。它比原版 MatAnyone 2 快多少?在 H200 上使用 torch.compile 处理原生 4K 视频时,它可达到 28.6 FPS,而 MatAnyone 2 约为 1.1 FPS,快约 12 倍。同时,它的 GPU 显存占用为 3.1 GB,而 MatAnyone 2 推算约需 80 GB。
在 H200 上使用 torch.compile 处理原生 4K 视频时,它可达到 28.6 FPS,而 MatAnyone 2 约为 1.1 FPS,快约 12 倍。同时,它的 GPU 显存占用为 3.1 GB,而 MatAnyone 2 推算约需 80 GB。有哪些类似的项目?OraRL, VisionHOPE, video-prediction-policy-2, wuji-ego-mint, tapnet, idol-sdk, vggt, pointdit
OraRL, VisionHOPE, video-prediction-policy-2, wuji-ego-mint, tapnet, idol-sdk, vggt, pointdit