







67K ·GitHub
Что это такое?
 Мультиплатформенный краулер для китайских соцсетей: он собирает результаты поиска по ключевым словам, конкретные посты и комментарии к ним с Xiaohongshu, Douyin, Kuaishou, Bilibili, Weibo, Tieba и Zhihu.
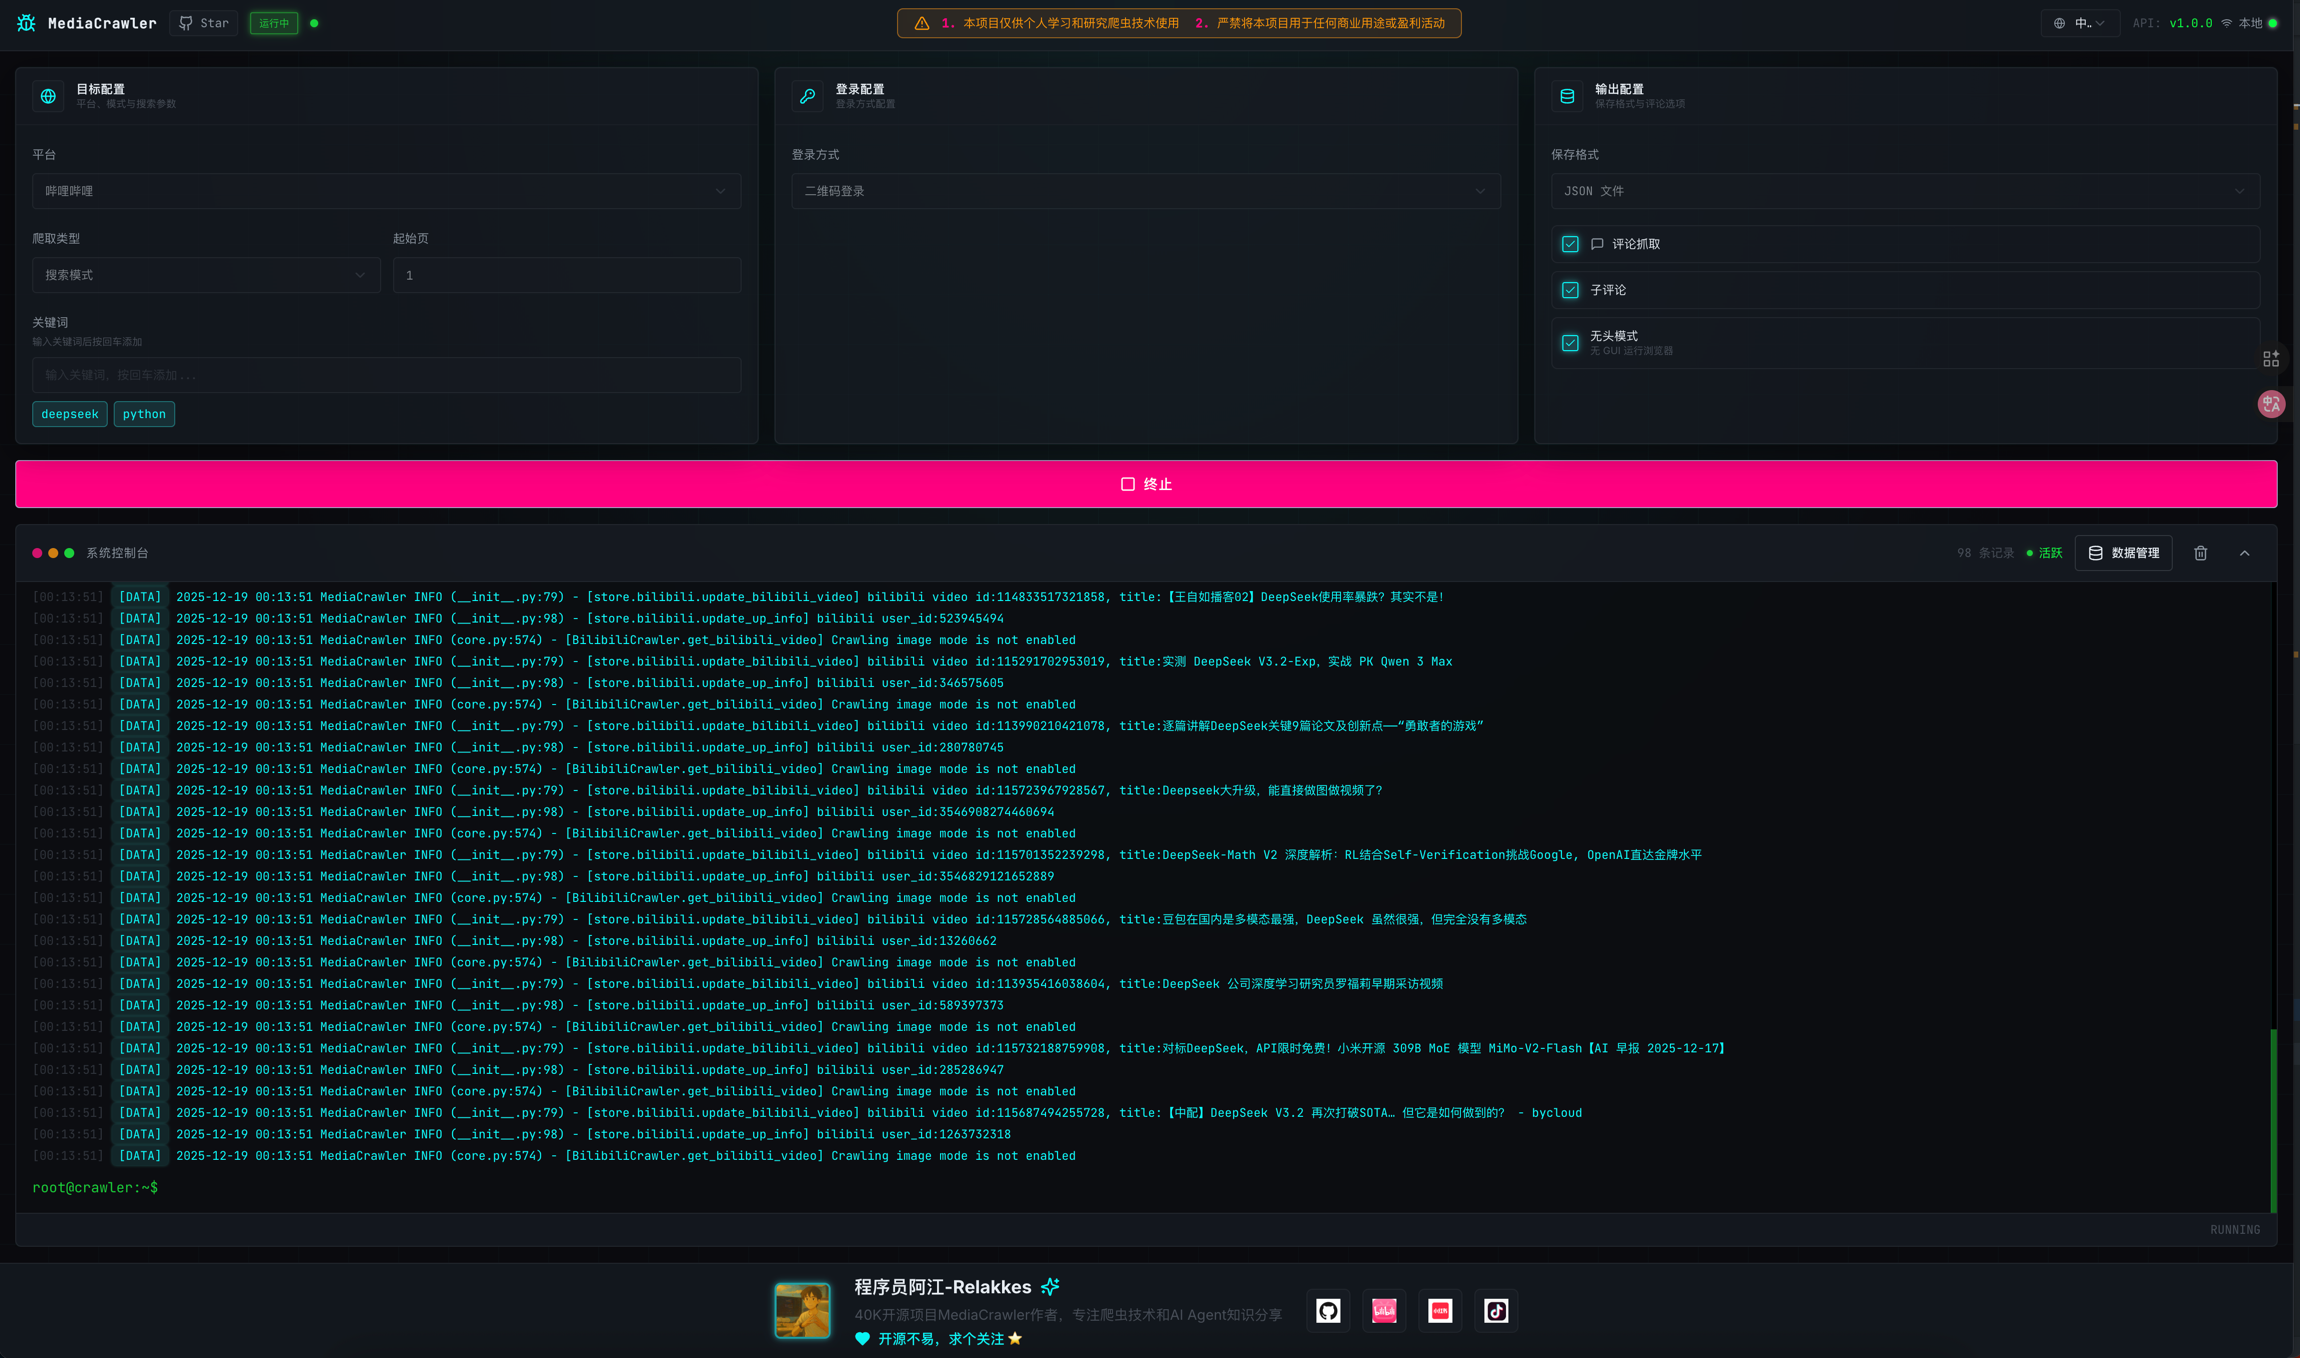
Мне придётся всё время сидеть в терминале, или есть интерфейс?Подойдёт и то, и другое: можно работать из командной строки, а можно через встроенный WebUI — настроить сбор данных, следить за статусом и логами в реальном времени, а также просматривать и экспортировать данные.
Подойдёт и то, и другое: можно работать из командной строки, а можно через встроенный WebUI — настроить сбор данных, следить за статусом и логами в реальном времени, а также просматривать и экспортировать данные.Как выглядит первый запуск?После установки зависимостей режим CDP по умолчанию требует Chrome 144+ с включённой удалённой отладкой на странице chrome://inspect/#remote-debugging; краулер затем работает через ваш браузер, в котором вы уже залогинены.
После установки зависимостей режим CDP по умолчанию требует Chrome 144+ с включённой удалённой отладкой на странице chrome://inspect/#remote-debugging; краулер затем работает через ваш браузер, в котором вы уже залогинены.Что должно быть на моём компьютере до установки?uv для Python-пакетов, а также Node.js версии 16 или новее — Node обязателен для краулинга Douyin и Zhihu. Драйвер браузера нужен, только если вы отключите режим CDP в пользу обычного Playwright.
uv для Python-пакетов, а также Node.js версии 16 или новее — Node обязателен для краулинга Douyin и Zhihu. Драйвер браузера нужен, только если вы отключите режим CDP в пользу обычного Playwright.Могу ли я использовать данные как захочу?Нет. В дисклеймере сказано, что проект предназначен только для обучения и исследований: коммерческое использование запрещено, как и массовый краулинг платформ и любое другое незаконное применение.
Нет. В дисклеймере сказано, что проект предназначен только для обучения и исследований: коммерческое использование запрещено, как и массовый краулинг платформ и любое другое незаконное применение.Он запустится на моём компьютере с Windows, или это только для Mac/Linux?Это обычный Python плюс Node и Chrome, поэтому работают Windows, macOS и Linux; всё выполняется на вашем собственном компьютере, а результаты сохраняются локально.
Это обычный Python плюс Node и Chrome, поэтому работают Windows, macOS и Linux; всё выполняется на вашем собственном компьютере, а результаты сохраняются локально.Как он получает подписи запросов, не взламывая каждую платформу?Он логинится через реальный браузер под управлением Playwright, а затем читает нужные параметры подписи с помощью JS-выражений внутри этой залогиненной сессии — так что шифрование платформ взламывать не приходится.
Он логинится через реальный браузер под управлением Playwright, а затем читает нужные параметры подписи с помощью JS-выражений внутри этой залогиненной сессии — так что шифрование платформ взламывать не приходится.Какие функции сбора данных работают на всех семи платформах?На каждой платформе поддерживаются поиск по ключевым словам, краулинг по ID поста, комментарии второго уровня, страница выбранного автора, сохранённое состояние входа, пул IP-прокси и создание облака слов из комментариев.
На каждой платформе поддерживаются поиск по ключевым словам, краулинг по ID поста, комментарии второго уровня, страница выбранного автора, сохранённое состояние входа, пул IP-прокси и создание облака слов из комментариев.В каких форматах можно сохранять собранные данные?Локально — в любом настроенном хранилище: CSV, JSON, JSONL, Excel, SQLite или база данных MySQL.
Локально — в любом настроенном хранилище: CSV, JSON, JSONL, Excel, SQLite или база данных MySQL.Что такое MediaCrawlerPro?Это платный подписочный аналог от того же автора: там есть возобновляемый краулинг, работа с несколькими аккаунтами, убрана зависимость от Playwright, полная поддержка Linux, десктопный загрузчик видео и переработанная архитектура, которую, по словам автора, стоит изучить.
Это платный подписочный аналог от того же автора: там есть возобновляемый краулинг, работа с несколькими аккаунтами, убрана зависимость от Playwright, полная поддержка Linux, десктопный загрузчик видео и переработанная архитектура, которую, по словам автора, стоит изучить.What are similar projects?catbus, social-auto-upload, creatorhub, Agent-Reach, scraping-apis-for-devs, crawlee, crawl4ai, Douyin_TikTok_Download_API
catbus, social-auto-upload, creatorhub, Agent-Reach, scraping-apis-for-devs, crawlee, crawl4ai, Douyin_TikTok_Download_APIWhich topics is it in?rednote, kuaishou, weibo, data-collection, web-crawler, data-mining, douyin, xiaohongshu, data-extraction, bilibili, scraper, scraping
rednote, kuaishou, weibo, data-collection, web-crawler, data-mining, douyin, xiaohongshu, data-extraction, bilibili, scraper, scraping