
ESP32s3-LLM-Cluster README

The project's README from github.com/Low-Zi-Hong/ESP32s3-LLM-Cluster. As one markdown file: README.md.

ESP32s3-LLM-Cluster

A distributed pipeline inference engine on multiple ESP32S3 running 1.58-bit (BitNet) Language model.

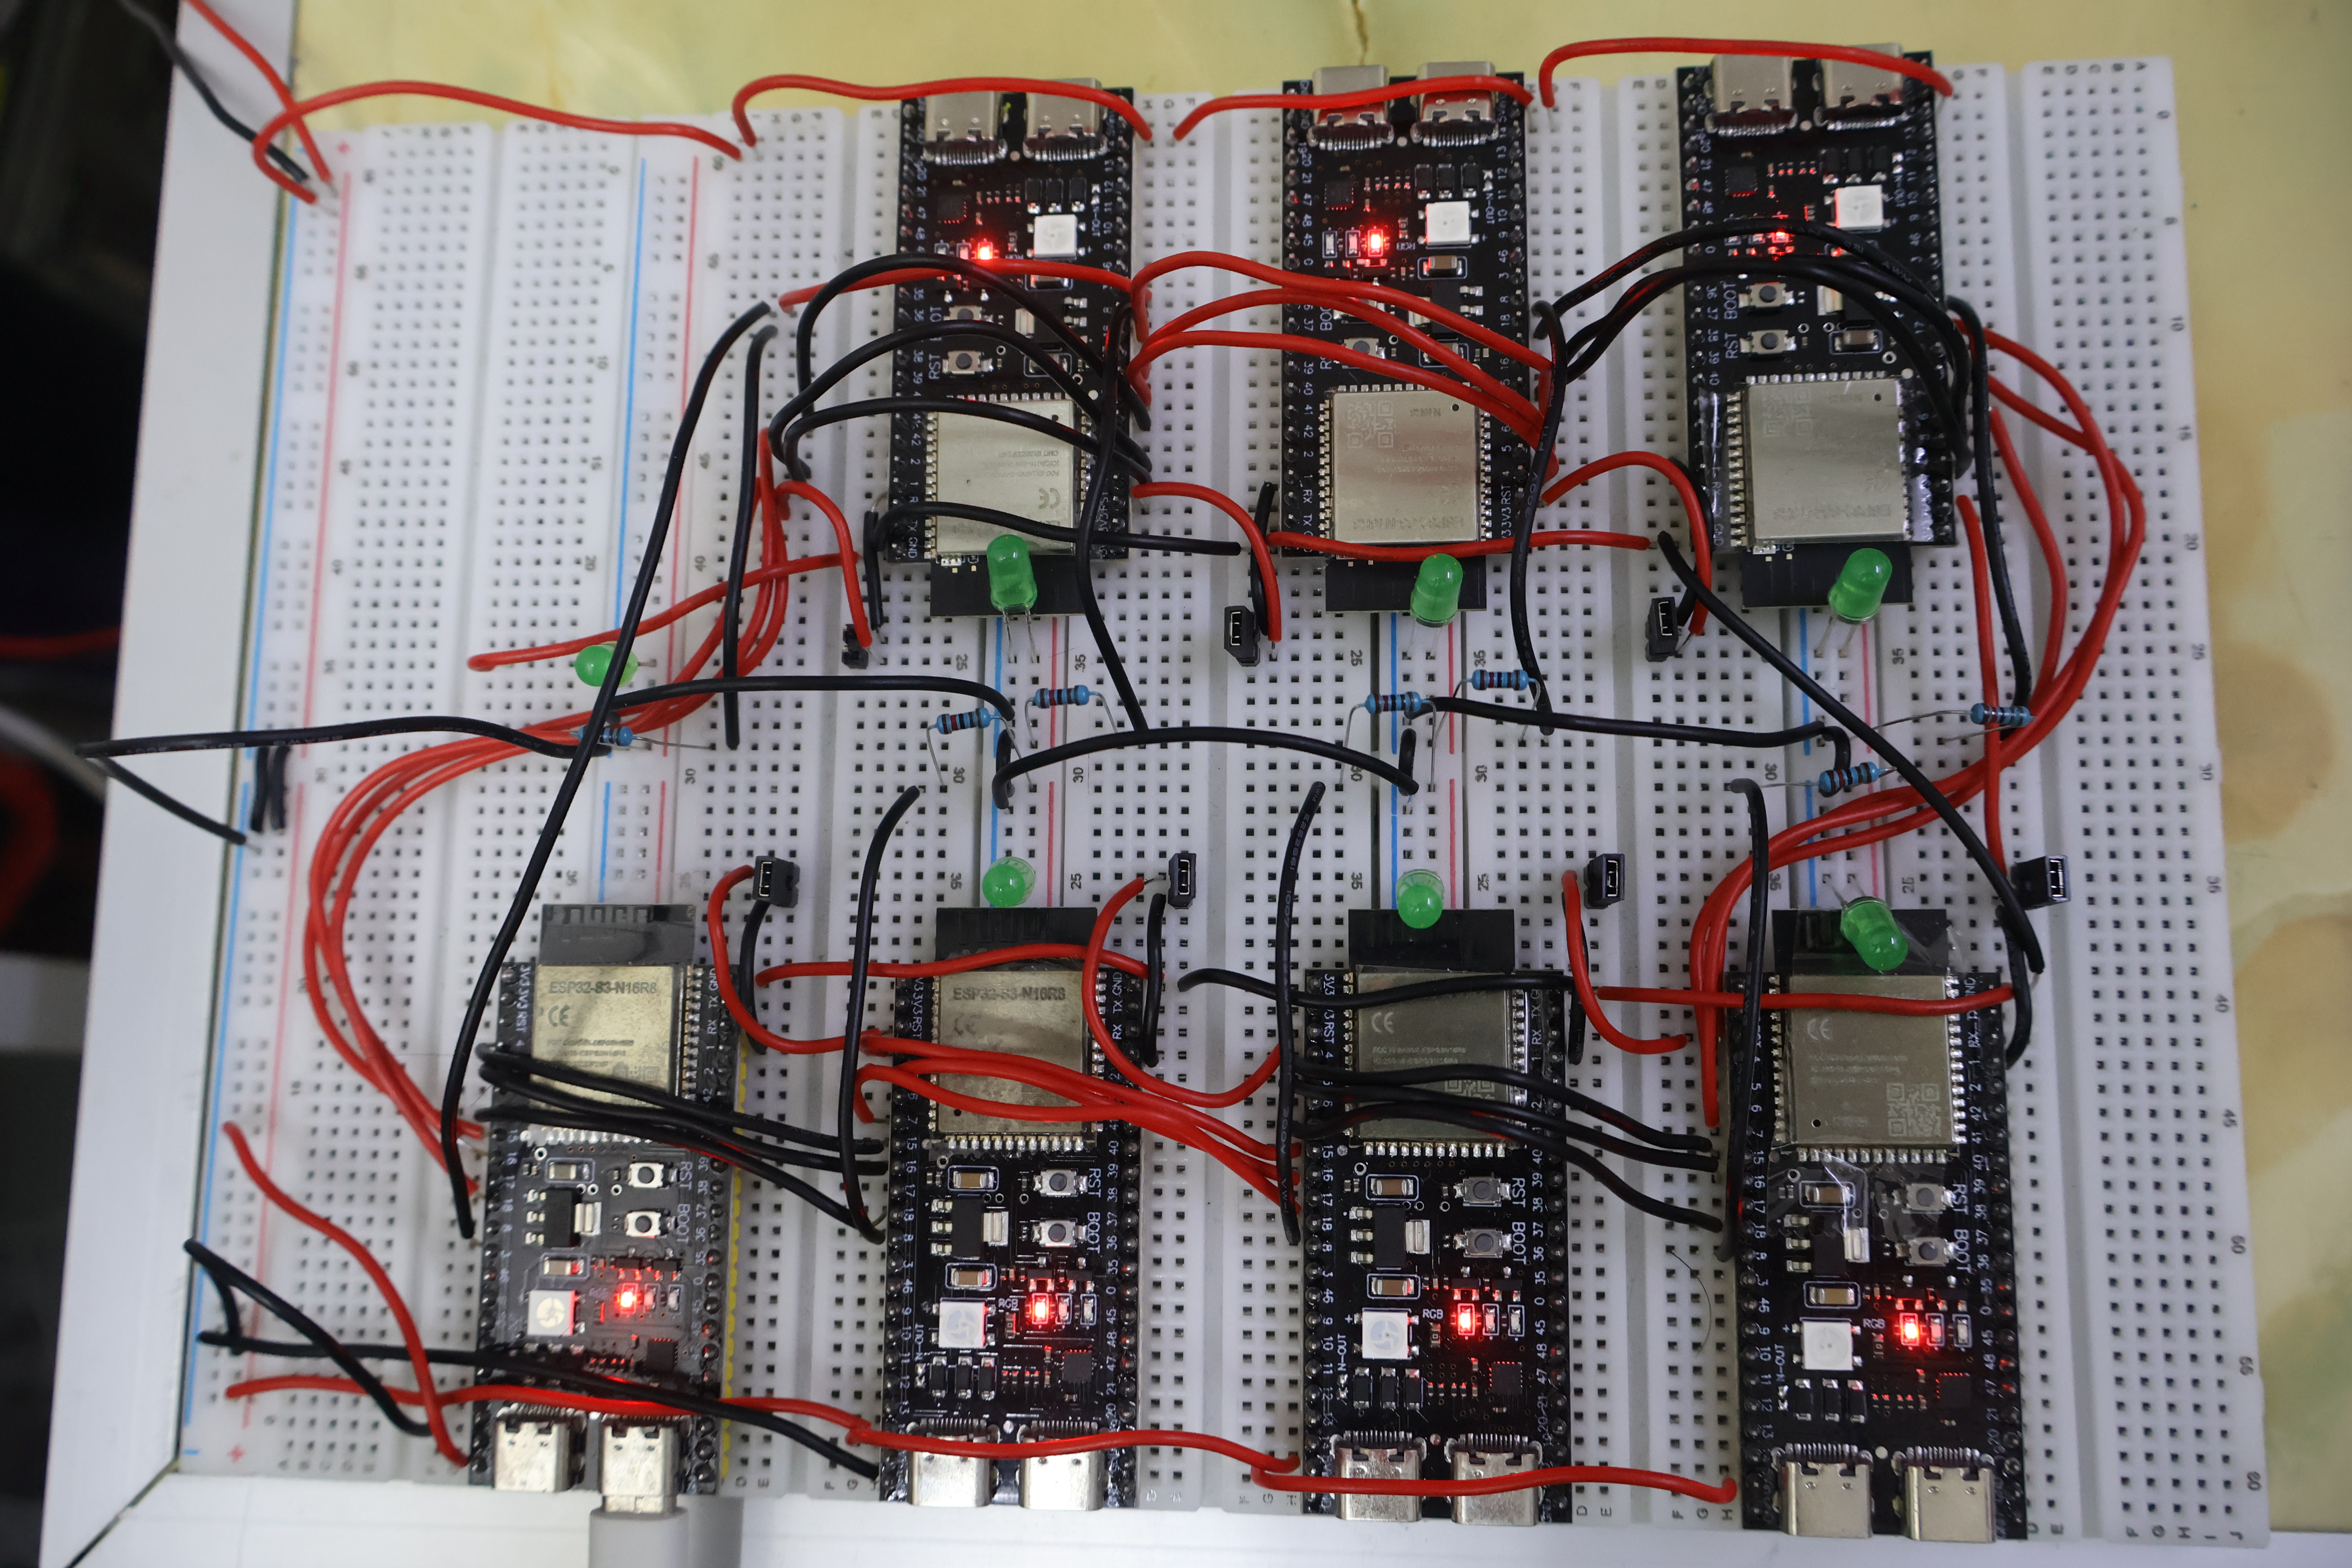
ESP32S3 boards

Architecture

This project runs a sliced 0.5B LLM across a cluster of 7 ESP32s3. One act as master and others are node. The master node runs the tokenizer and embeding and the other attention layer and MLP ran on the nodes. The master and node communicate through high speed SPI Daisy-Chain.

┌─────────────────────────────────────────────────────────┐
│                     MASTER NODE                         │
│                                                         │
│  [ Prompt ] ---> BPE Tokenizer                          │
│                       │                                 │
│                 Token Embedding                         │
│             (INT4, ~14MB in Flash)                      │
│                       │                                 │
│             (SPI CH A - TX to Node 1)                   │
└───────────────────────┬─────────────────────────────────┘
                        │ Hidden State Vector (FP32)
                        ▼
┌─────────────────────────────────────────────────────────┐
│                    COMPUTE NODE 1                       │
│             (SPI CH B - RX from Master)                 │
│                                                         │
│  ► Layer 0 to 3 (4x Transformer Blocks)                 │
│    • RMSNorm (FP16 scaled to FP32)                      │
│    • 1.58-bit Attention (Q, K, V, O proj) + RoPE        │
│    • KV Cache (PSRAM)                                   │
│    • 1.58-bit MLP (Gate, Up, Down proj)                 │
│                                                         │
│             (SPI CH A - TX to Node 2)                   │
└───────────────────────┬─────────────────────────────────┘
                        │
                       ... (Nodes 2 to 5)
                        │
                        ▼
┌─────────────────────────────────────────────────────────┐
│                    COMPUTE NODE 6                       │
│             (SPI CH B - RX from Node 5)                 │
│                                                         │
│  ► Layer 20 to 23 (4x Transformer Blocks)               │
│    • Same 1.58-bit Architecture                         │
│                                                         │
│             (SPI CH A - TX back to Master)              │
└───────────────────────┬─────────────────────────────────┘
                        │
                        ▼
┌─────────────────────────────────────────────────────────┐
│                     MASTER NODE                         │
│             (SPI CH B - RX from Node 6)                 │
│                                                         │
│                 Final RMS Norm                          │
│             (FP16, 64KB in 'fnorm' partition)           │
│                       │                                 │
│         LM Head (Tied to INT4 Embeddings)               │
│                       │                                 │
│               Greedy Sampling                           │
│                       │                                 │
│  [ Output ] <--- Next Token ID                          │
└─────────────────────────────────────────────────────────┘

Getting Started

pls refer workflow guide to start with the project.

Project Structure

.
├── README.md                   # Project documentation
├── workflow.md                 # Step-by-step flashing, model prep & wiring guide
├── .gitignore                  # Git ignore rules for build files & binaries
│
├── docs/                       
│   └── images/                 # Architecture diagrams and hardware photos
│
├── master_board/               # Firmware for the Master Node (ESP-IDF)
│   ├── main/
│   │   ├── main.cpp            # Master orchestrator, user I/O & BPE tokenizer
│   │   ├── embedding.cpp       # INT4 embedding lookup logic
│   │   ├── lm_head.cpp         # LM Head mapping and greedy sampling
│   │   └── spi_bus.cpp         # Master dual-channel SPI driver
│   ├── partitions.csv          # Custom partition table (token, model, fnorm)
│   └── CMakeLists.txt
│
├── node_firmware/              # Firmware for the Compute Nodes (ESP-IDF)
│   ├── main/
│   │   ├── main.cpp            # Node worker entry point & inference loop
│   │   ├── bitlinear.cpp       # 1.58-bit ternary linear layer implementation
│   │   ├── bitlinear_forward.S # Assembly optimized MAC ops for 1.58-bit
│   │   ├── qwen_attention.cpp  # Qwen Attention, RoPE & KV-Cache runtime
│   │   ├── lut_table.cpp       # Look-up tables for extreme optimization
│   │   └── spi_bus.cpp         # Daisy-chain SPI DMA receiver/transmitter
│   ├── partitions.csv          # Layer partition layout for Node
│   └── CMakeLists.txt
│
├── python_tools/               # PC-side quantization & preprocessing suite
    ├── crop_token.py           # Vocabulary pruning (scales down to 32K tokens)
    ├── crop_model_weight.py    # Embedding matrix slicing
    ├── qat_158.py              # BitNet QAT (Quantization-Aware Training) fine-tuning
    ├── bit4_embedding.py       # INT4 weight packer for embeddings
    ├── pack_tokenizer_bin.py   # Serializes tokenizer rules into ESP32 .bin
    ├── pack_model_bin.py       # Packs 1.58-bit layer chunks for physical alignment
    ├── look_model_structure.py # Debug tool for inspecting .safetensors
    └── flash_*.bat             # Multi-threaded fast flashing scripts

License

This project is licensed under the MIT License - see the LICENSE file for details.

Acknowledgments

Inspiration, related works, and references:

ESP32s3-LLM-Cluster (Low-Zi-Hong/ESP32s3-LLM-Cluster)

Searching Database…

Что это такое?Этот проект — распределённый движок инференса, который запускает LLM на 0,5 млрд параметров, квантованную в 1,58-битные (BitNet) троичные веса, распределённую по кластеру из 7 микроконтроллеров ESP32-S3, соединённых через SPI.
Это одно устройство ESP32-S3 или кластер из нескольких плат?Это кластер из 7 плат, а не один чип: один ESP32-S3 выступает мастером, выполняя токенизатор и шаг эмбеддингов, а остальные шесть выполняют слои внимания и MLP модели.
Как это запустить?README лишь отсылает к отдельному гайду по рабочему процессу для настройки; пошаговых инструкций по сборке или прошивке в нём самом нет.
Какое железо нужно, чтобы собрать это?Нужны 7 физических плат ESP32-S3, соединённых в цепочку (daisy-chain) по SPI, плюс заранее квантованная модель BitNet (1,58-битные троичные веса) для загрузки на мастер- и узловые платы.
Насколько проект зрелый — есть ли проверенный гайд по сборке?Сам README скуден, с пустым разделом «Project Structure», а реальную настройку перекладывает на внешний гайд по рабочему процессу, так что ждите настоящей сборки и распайки, а не отполированного quick-start.
Зачем распределять модель по 7 платам, а не на один ESP32-S3?Разделение токенизатора/эмбеддингов (мастер) и слоёв внимания и MLP (узлы) позволяет кластеру запустить модель, чьи потребности в памяти и вычислениях превышают то, что один ESP32-S3 осилит сам.
Что такое квантизация BitNet 1.58-бит?BitNet ограничивает веса модели троичными значениями (-1, 0, 1), резко сокращая занимаемую память, чтобы LLM реально поместилась на железе класса микроконтроллеров вроде ESP32-S3.
Что вдохновило этот проект?Автор благодарит «ESP-32-s3-Story-maker-LLM» за одноузловое развёртывание квантованной LLM на ESP32-S3 и «esp32s3-distributed-ai» за многоузловую распределённую ИИ-архитектуру, объединяя обе идеи с квантизацией BitNet.
Size
8.6 MB
Stars
243
Updated
CommitOct 08
Age
2mo
Commits · 90 Days