


Что это такое?
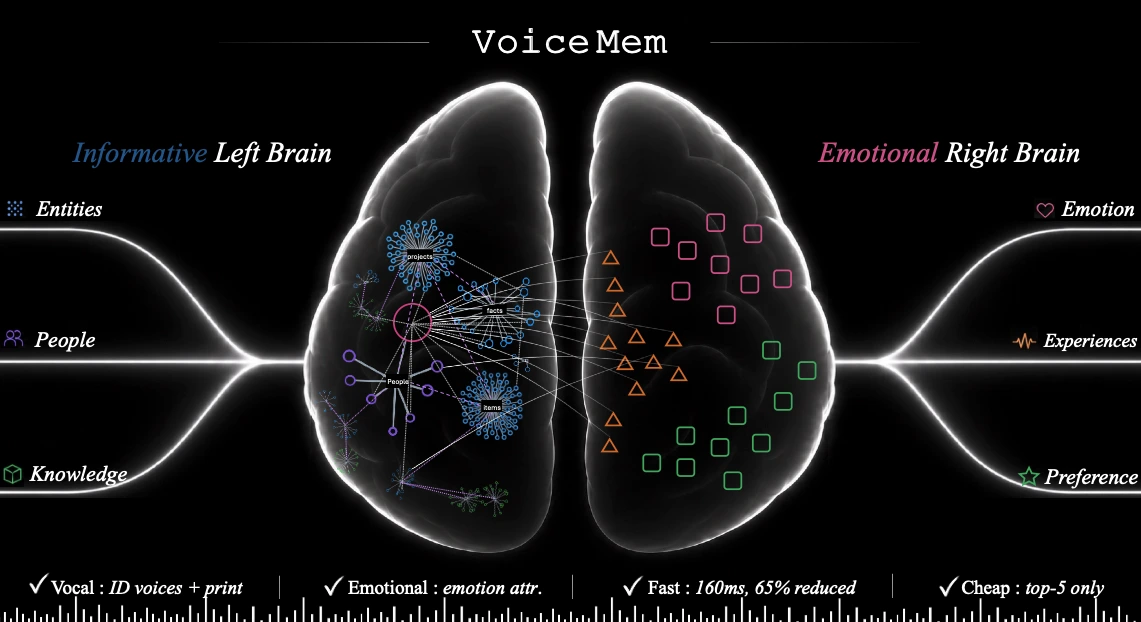
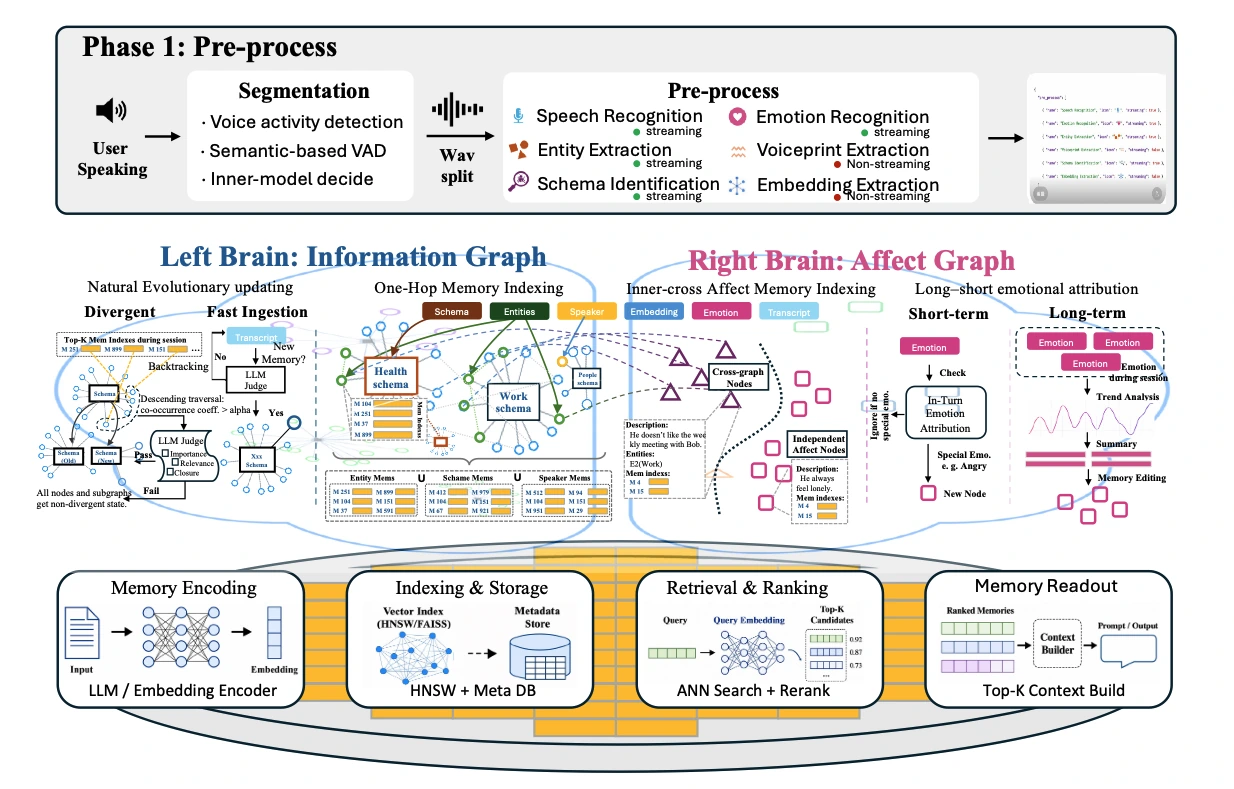
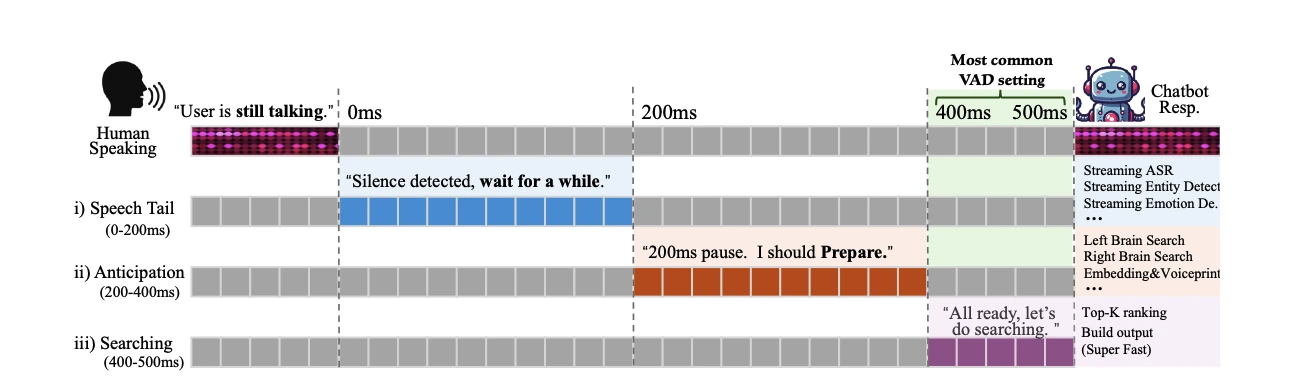
 VoiceMem — это open-source инфраструктура памяти для голосовых агентов реального времени: она даёт им долгосрочную память через архитектуру «двух мозгов» — «левый мозг» хранит фактическую информацию, а «правый мозг» отслеживает эмоции и личность, — и построена на полностью стриминговом конвейере, чтобы задержка оставалась низкой.
VoiceMem — это самостоятельное приложение или то, что я встраиваю в своего голосового агента?Это устанавливаемый через pip слой памяти на Python, который вы встраиваете в свой конвейер: поток такой — микрофон в VoiceMem (он слушает и заранее подбирает релевантные воспоминания), затем в вашу модель (она читает эти воспоминания и генерирует ответ) — вы меняете только шаг генерации.
Это устанавливаемый через pip слой памяти на Python, который вы встраиваете в свой конвейер: поток такой — микрофон в VoiceMem (он слушает и заранее подбирает релевантные воспоминания), затем в вашу модель (она читает эти воспоминания и генерирует ответ) — вы меняете только шаг генерации.Как его запустить?Вы устанавливаете Python-пакет, скачиваете нужные локальные модели, затем запускаете VoiceMem либо как офлайн-движок памяти, либо в стриминговом режиме; в репозитории также есть интерактивное демо (с сервером WebSocket/Uvicorn), если его склонировать.
Вы устанавливаете Python-пакет, скачиваете нужные локальные модели, затем запускаете VoiceMem либо как офлайн-движок памяти, либо в стриминговом режиме; в репозитории также есть интерактивное демо (с сервером WebSocket/Uvicorn), если его склонировать.Нужен ли мне API-ключ OpenAI?Да, для полного агентного цикла — VoiceMem использует OpenAI API для функций Chat, TTS и Realtime, — но сам движок памяти поставляется с локальными моделями (стриминговый ASR на базе FunASR, Silero VAD, эмбеддинги multilingual-e5), так что извлечение может работать и без него.
Да, для полного агентного цикла — VoiceMem использует OpenAI API для функций Chat, TTS и Realtime, — но сам движок памяти поставляется с локальными моделями (стриминговый ASR на базе FunASR, Silero VAD, эмбеддинги multilingual-e5), так что извлечение может работать и без него.Цифры бенчмарка основаны на полной истории беседы или только на извлечённых воспоминаниях?Только на извлечённых воспоминаниях — отвечающая модель в оценках никогда не видит сырую расшифровку, потому что подача полной беседы превратила бы бенчмарк в тест на понимание прочитанного вместо теста на память.
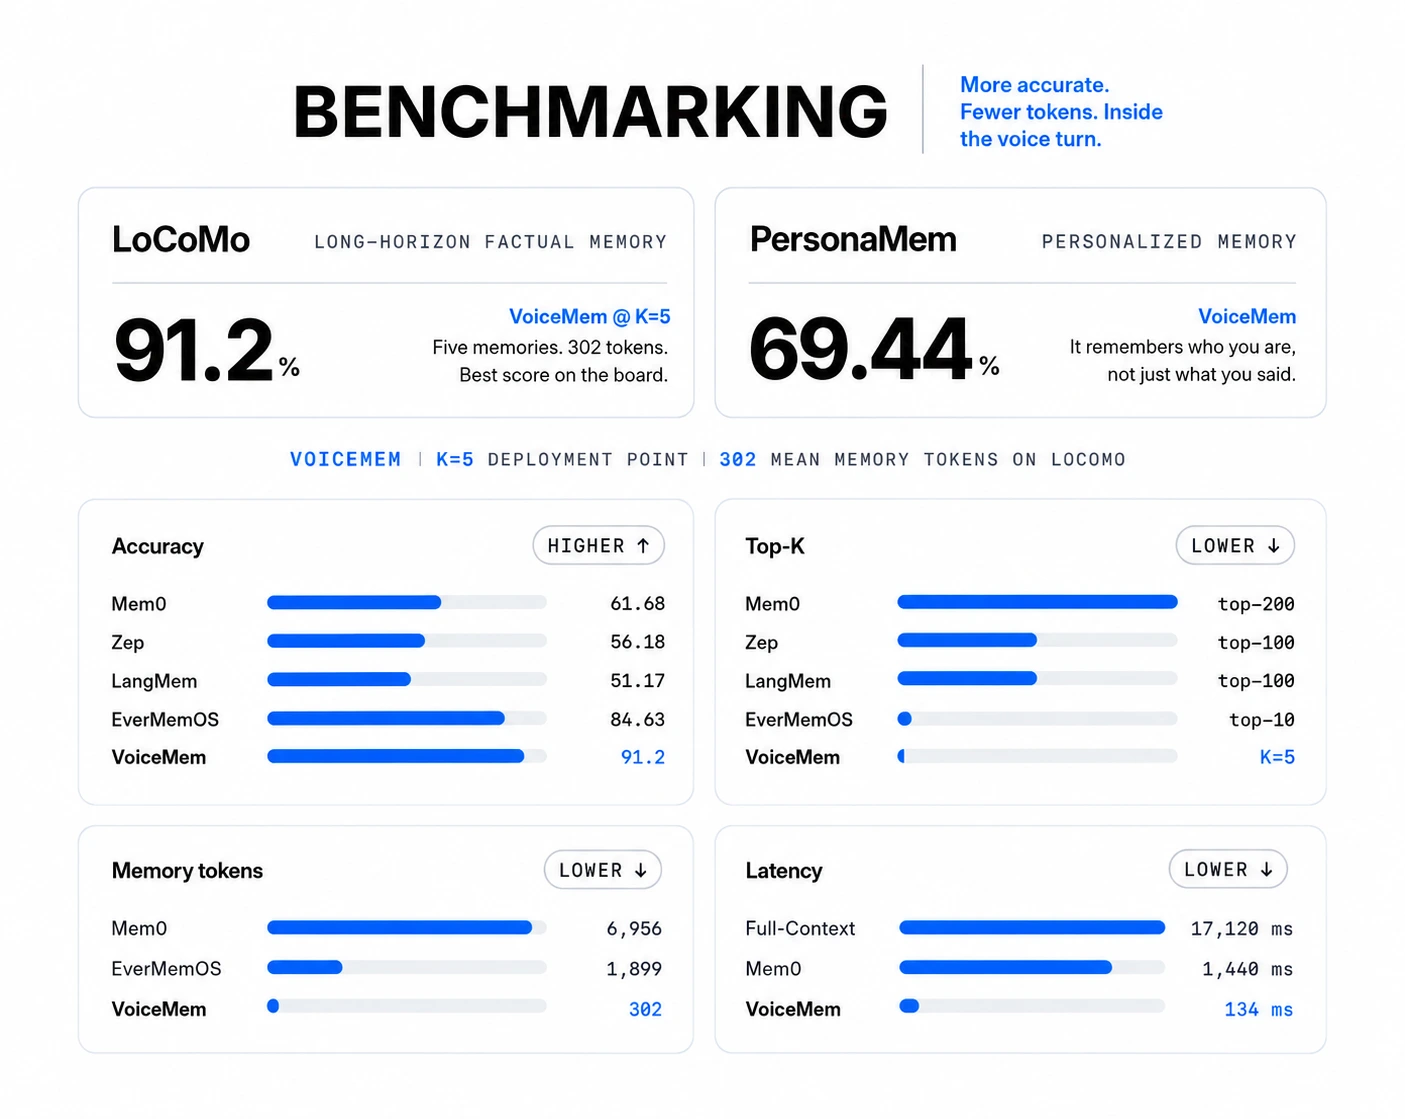
Только на извлечённых воспоминаниях — отвечающая модель в оценках никогда не видит сырую расшифровку, потому что подача полной беседы превратила бы бенчмарк в тест на понимание прочитанного вместо теста на память.Насколько точное извлечение памяти у VoiceMem по сравнению с Mem0?На бенчмарке LoCoMo VoiceMem достигает точности 91,2% против 61,68% у Mem0, используя лишь свои топ-5 извлечённых воспоминаний, и отвечает примерно за 134 мс против 1 440 мс у Mem0.
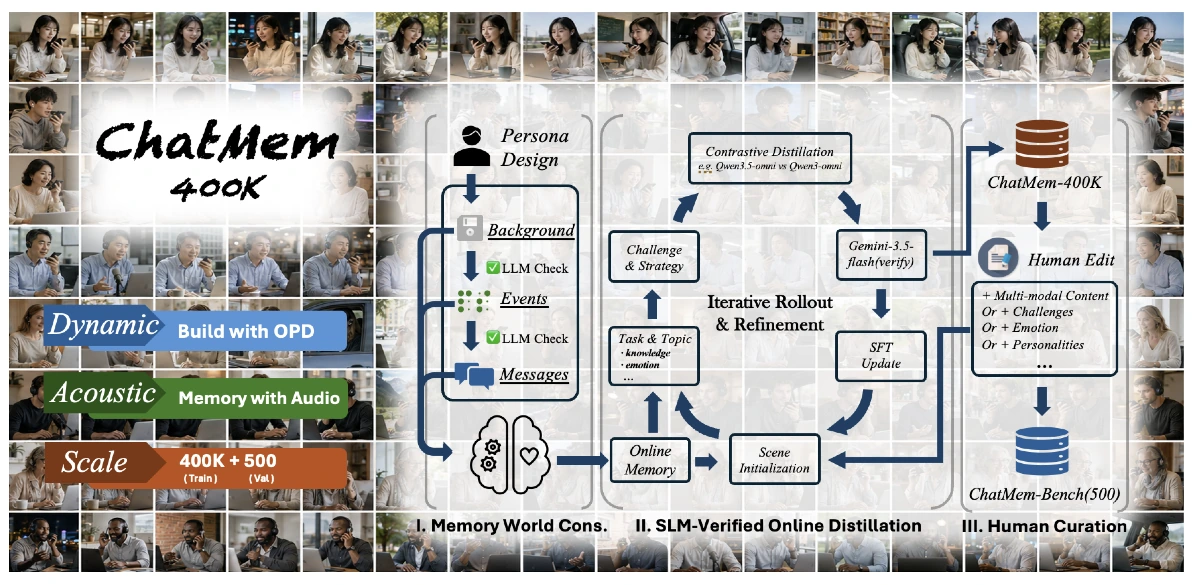
На бенчмарке LoCoMo VoiceMem достигает точности 91,2% против 61,68% у Mem0, используя лишь свои топ-5 извлечённых воспоминаний, и отвечает примерно за 134 мс против 1 440 мс у Mem0.Что такое ChatMem-400K?Это открытый датасет на 400 тыс. примеров, построенный через трёхэтапный конвейер (построение мира памяти, on-policy дистилляция с валидацией SLM и человеческая доработка), используемый для обучения семейства моделей VoiceMem и создания оценочного набора ChatMem-Bench.
Это открытый датасет на 400 тыс. примеров, построенный через трёхэтапный конвейер (построение мира памяти, on-policy дистилляция с валидацией SLM и человеческая доработка), используемый для обучения семейства моделей VoiceMem и создания оценочного набора ChatMem-Bench.Какие модели уже понимают воспоминания VoiceMem?Открытое семейство моделей VoiceMem включает адаптеры для Qwen2.5-Omni, Qwen3-Omni и Step-Audio2-Mini, которые могут напрямую читать и использовать воспоминания, предоставляемые VoiceMem.
Открытое семейство моделей VoiceMem включает адаптеры для Qwen2.5-Omni, Qwen3-Omni и Step-Audio2-Mini, которые могут напрямую читать и использовать воспоминания, предоставляемые VoiceMem.Зачем делить память на левый и правый мозг вместо одного хранилища?Левый мозг организует факты через схемы и сущности для точного извлечения, а правый мозг отдельно отслеживает личность, эмоции и отношения через межсущностные узлы — чтобы эмоциональный контекст не размывал точность поиска фактов.
Левый мозг организует факты через схемы и сущности для точного извлечения, а правый мозг отдельно отслеживает личность, эмоции и отношения через межсущностные узлы — чтобы эмоциональный контекст не размывал точность поиска фактов.What are similar projects?mem0, memoket-kite, jargo, EverOS, Qwen3-Omni, Omni-Interaction-Agent, Memslides, SimpleMem
mem0, memoket-kite, jargo, EverOS, Qwen3-Omni, Omni-Interaction-Agent, Memslides, SimpleMemWhich topics is it in?memory-engine, voice-agent, application, audio-streaming, memory-system, genai, conversational-ai, memory-management, long-term-memory, voice-assistant, speech-recognition, ai-tools
memory-engine, voice-agent, application, audio-streaming, memory-system, genai, conversational-ai, memory-management, long-term-memory, voice-assistant, speech-recognition, ai-tools