Что это?
 GVS5H — код и экспериментальные данные исследовательской работы, вводящей «ledger-based zero-shot self-orchestration» (оркестрацию без обучения на основе реестра): свежие экземпляры одной модели декомпозируют задачу кодирования и координируются через общую файловую систему, где лежат план, заметки и текущее решение, что позволяет нескольким дешёвым открытым моделям догонять или приближаться к точности куда более крупной проприетарной модели.
Это универсальный агентный фреймворк или код экспериментов конкретной статьи?Это эталонная реализация, стоящая за статьёй, а не универсальный фреймворк: она запускает либо мультиагентный оркестратор, либо простой бейзлайн с одним вызовом на задачах LiveCodeBench и печатает оценку pass@1.
Это эталонная реализация, стоящая за статьёй, а не универсальный фреймворк: она запускает либо мультиагентный оркестратор, либо простой бейзлайн с одним вызовом на задачах LiveCodeBench и печатает оценку pass@1.Как запустить эксперименты?Установите uv, получите API-ключ для бэкенда, который хотите протестировать, затем запустите скрипт с --engine multiagent или --engine single; оценка pass@1 печатается в конце, а полные результаты сохраняются в runs/results.json.
Установите uv, получите API-ключ для бэкенда, который хотите протестировать, затем запустите скрипт с --engine multiagent или --engine single; оценка pass@1 печатается в конце, а полные результаты сохраняются в runs/results.json.Какие бэкенды моделей поддерживаются?Из коробки поддерживаются Anthropic, DashScope (Qwen) и OpenRouter, каждому нужен свой API-ключ.
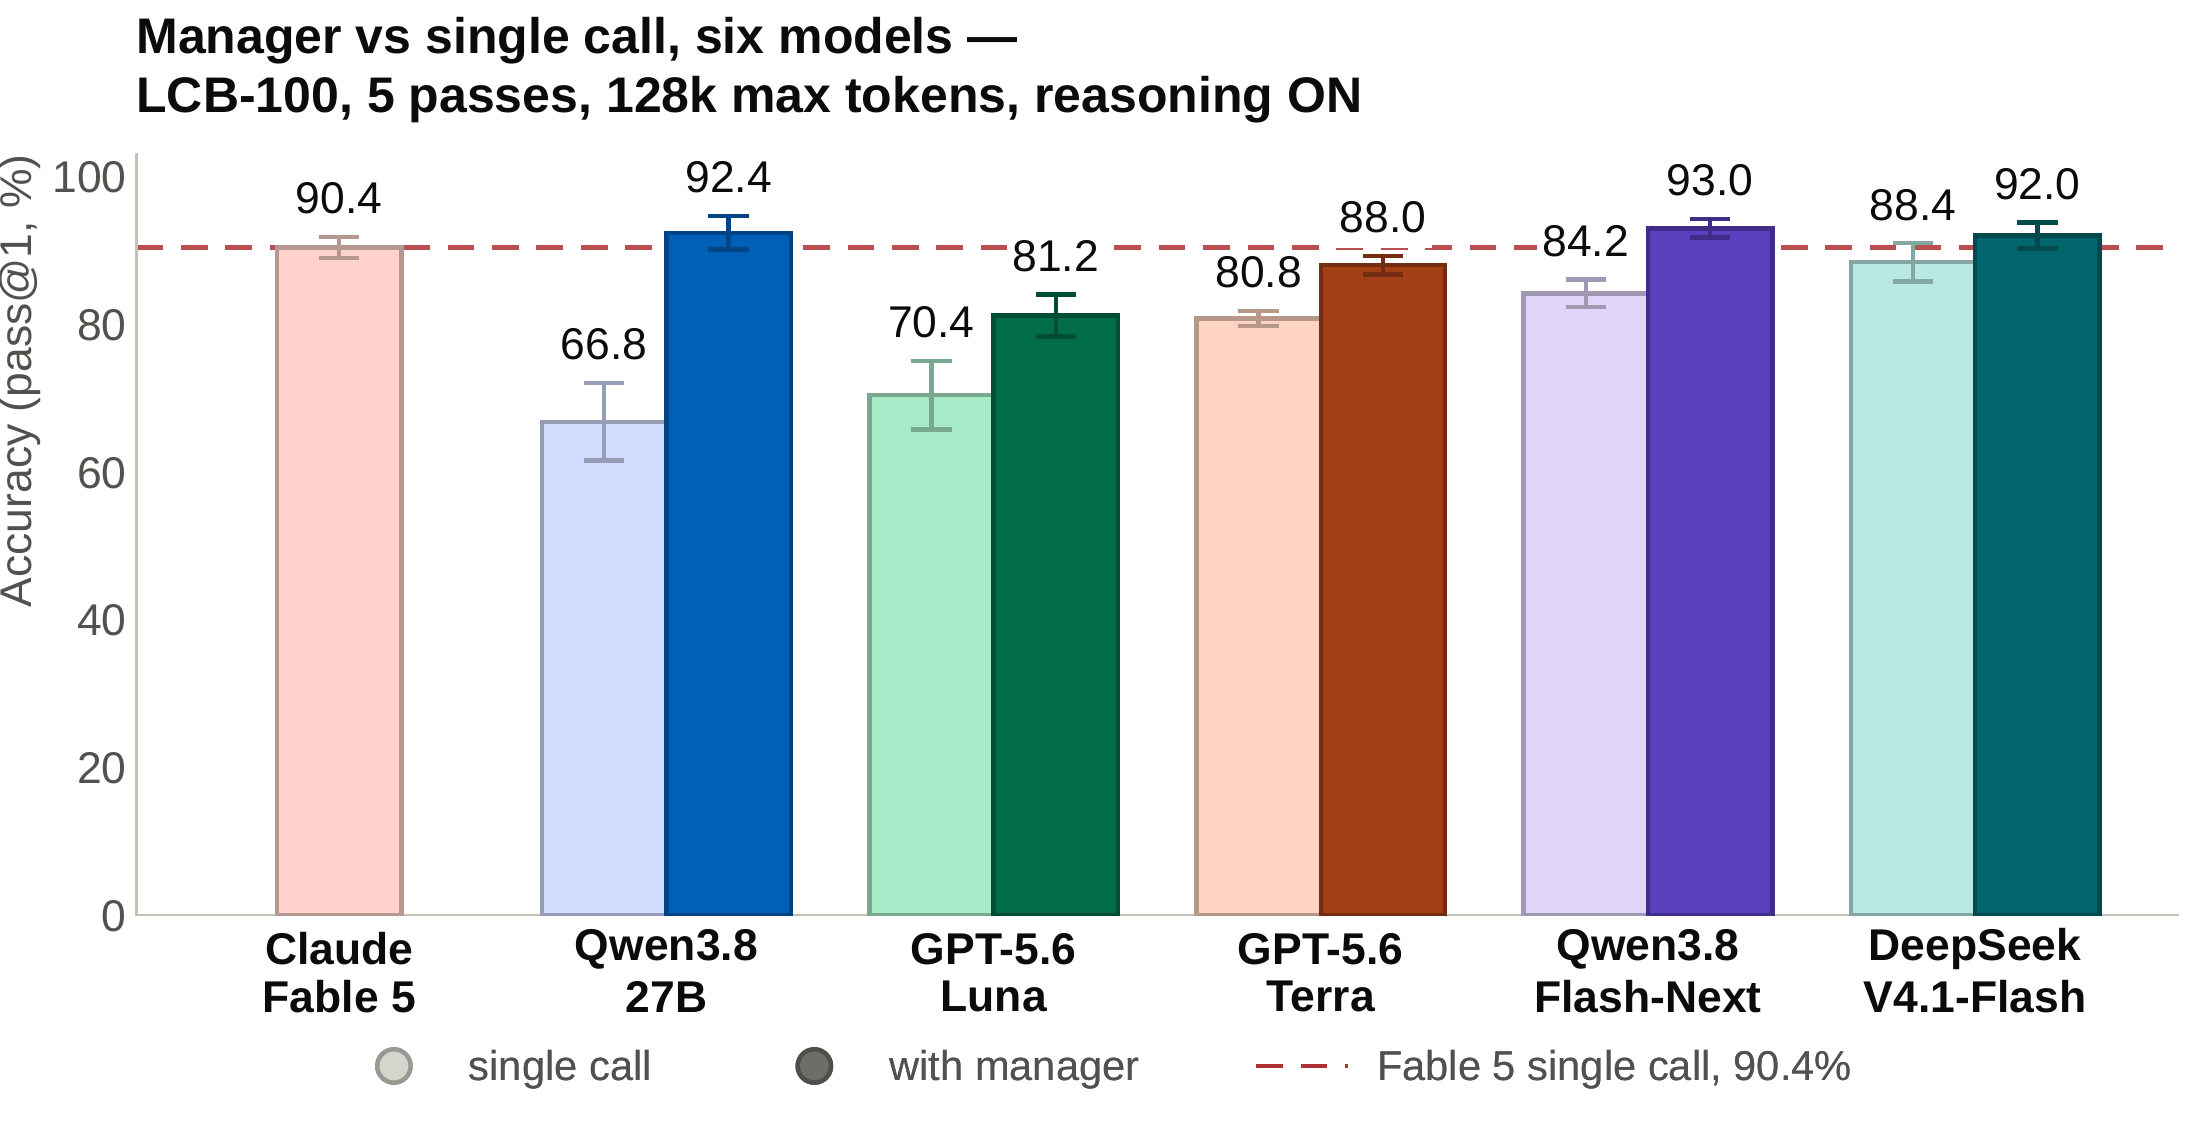
Из коробки поддерживаются Anthropic, DashScope (Qwen) и OpenRouter, каждому нужен свой API-ключ.Помогает ли трюк с оркестрацией каждой модели одинаково?Нет — в статье прямо отмечено, что выигрыш не универсален; некоторые протестированные модели не показывают улучшения или даже регрессируют по сравнению с бейзлайном с одним вызовом.
Нет — в статье прямо отмечено, что выигрыш не универсален; некоторые протестированные модели не показывают улучшения или даже регрессируют по сравнению с бейзлайном с одним вызовом.Какой бенчмарк используется для оценки моделей?100 последних сложных задач из LiveCodeBench, оцениваемых по точности pass@1.
100 последних сложных задач из LiveCodeBench, оцениваемых по точности pass@1.Кто или что такое Claude Fable 5 в этом сравнении?Fable 5 — название из статьи для фронтирной проприетарной модели Claude, служащей бейзлайном по точности и стоимости, относительно которого измеряются оркестрированные конфигурации Qwen.
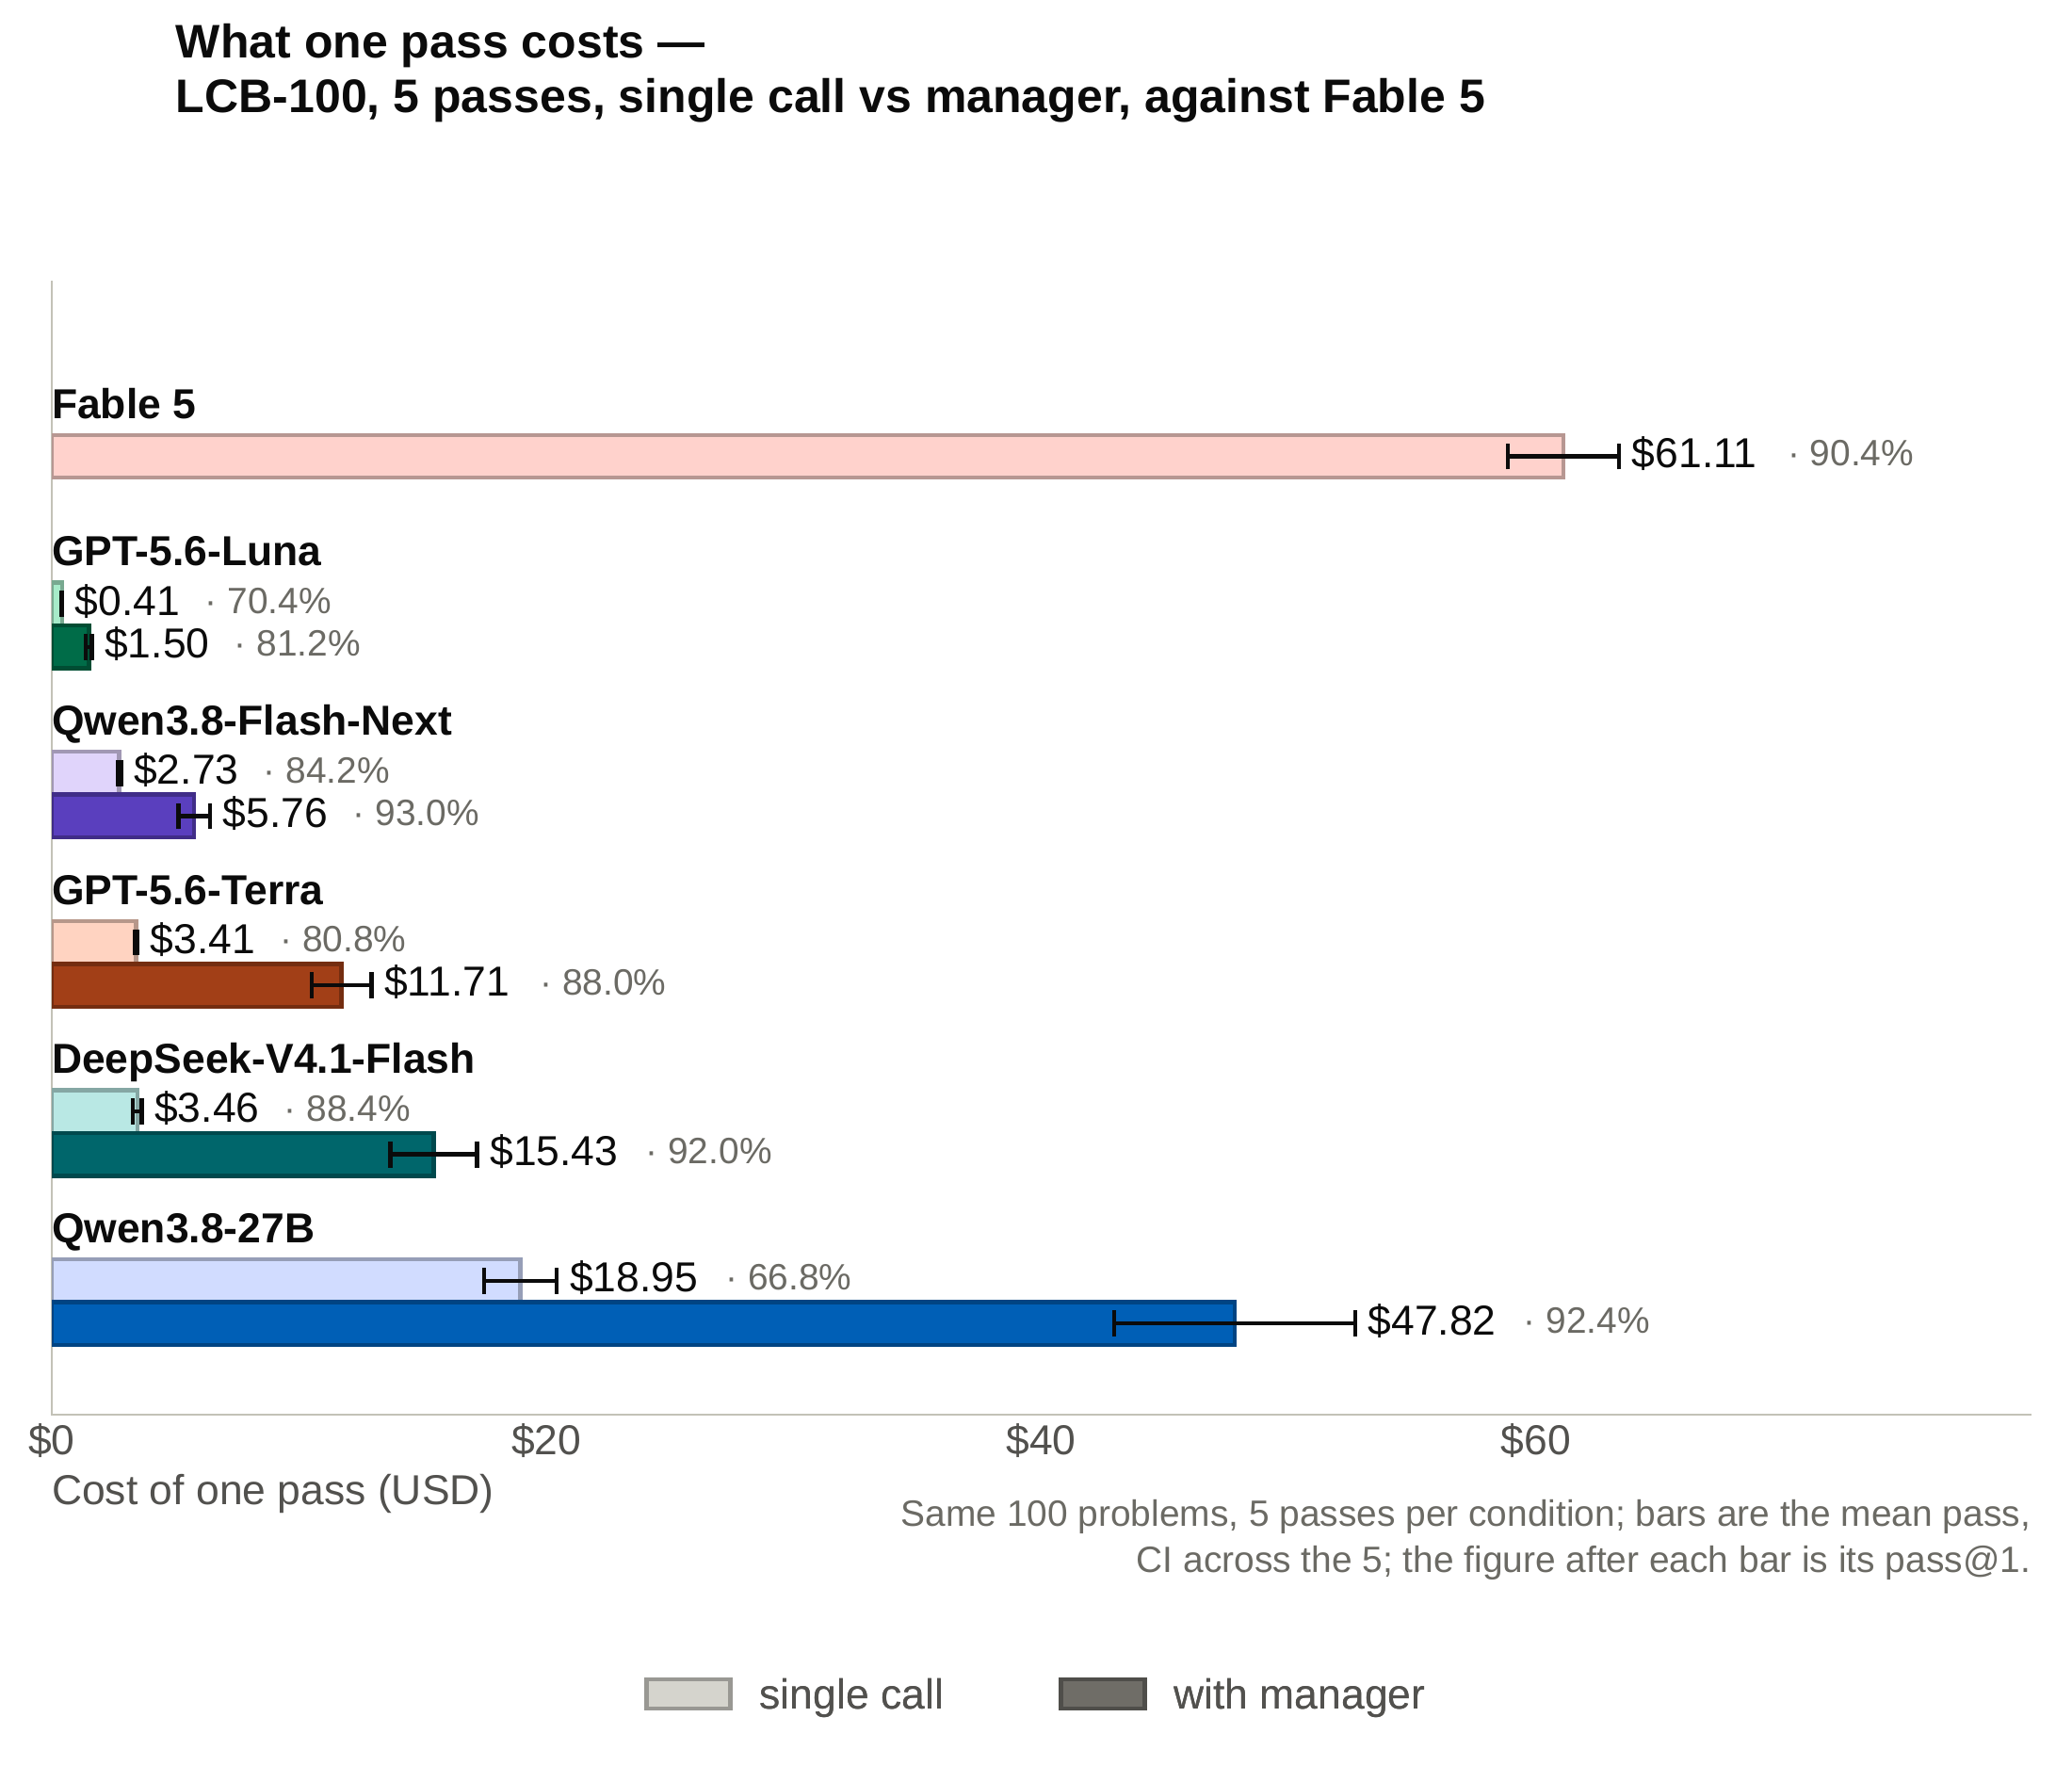
Fable 5 — название из статьи для фронтирной проприетарной модели Claude, служащей бейзлайном по точности и стоимости, относительно которого измеряются оркестрированные конфигурации Qwen.Почему метод оркестрации экономит деньги?Вместо вызова одной крупной проприетарной модели несколько более дешёвых экземпляров моделей координируются через общие заметки и план, что позволяет лучшей оркестрированной конфигурации Qwen3.8 достичь 93.0% pass@1 примерно за 9% стоимости Fable 5.
Вместо вызова одной крупной проприетарной модели несколько более дешёвых экземпляров моделей координируются через общие заметки и план, что позволяет лучшей оркестрированной конфигурации Qwen3.8 достичь 93.0% pass@1 примерно за 9% стоимости Fable 5.Куда сохраняются результаты запусков?Итоговые оценки pass@1 попадают в runs/results.json, а рабочие файлы каждого запуска (план, заметки, решение) хранятся в runs/ws/.
Итоговые оценки pass@1 попадают в runs/results.json, а рабочие файлы каждого запуска (план, заметки, решение) хранятся в runs/ws/.What are similar projects?context-language-models, ruflo, hive, agentcraft, PocketFlow, open-multi-agent, decider, ai-agents-the-definitive-guide
context-language-models, ruflo, hive, agentcraft, PocketFlow, open-multi-agent, decider, ai-agents-the-definitive-guideWhich topics is it in?benchmarking, llm-evaluation, openrouter, multi-agent-systems, paper, code-generation, qwen, academic-research, large-language-models, local-llm, orchestration, agent-orchestration
benchmarking, llm-evaluation, openrouter, multi-agent-systems, paper, code-generation, qwen, academic-research, large-language-models, local-llm, orchestration, agent-orchestration