

Что это такое?
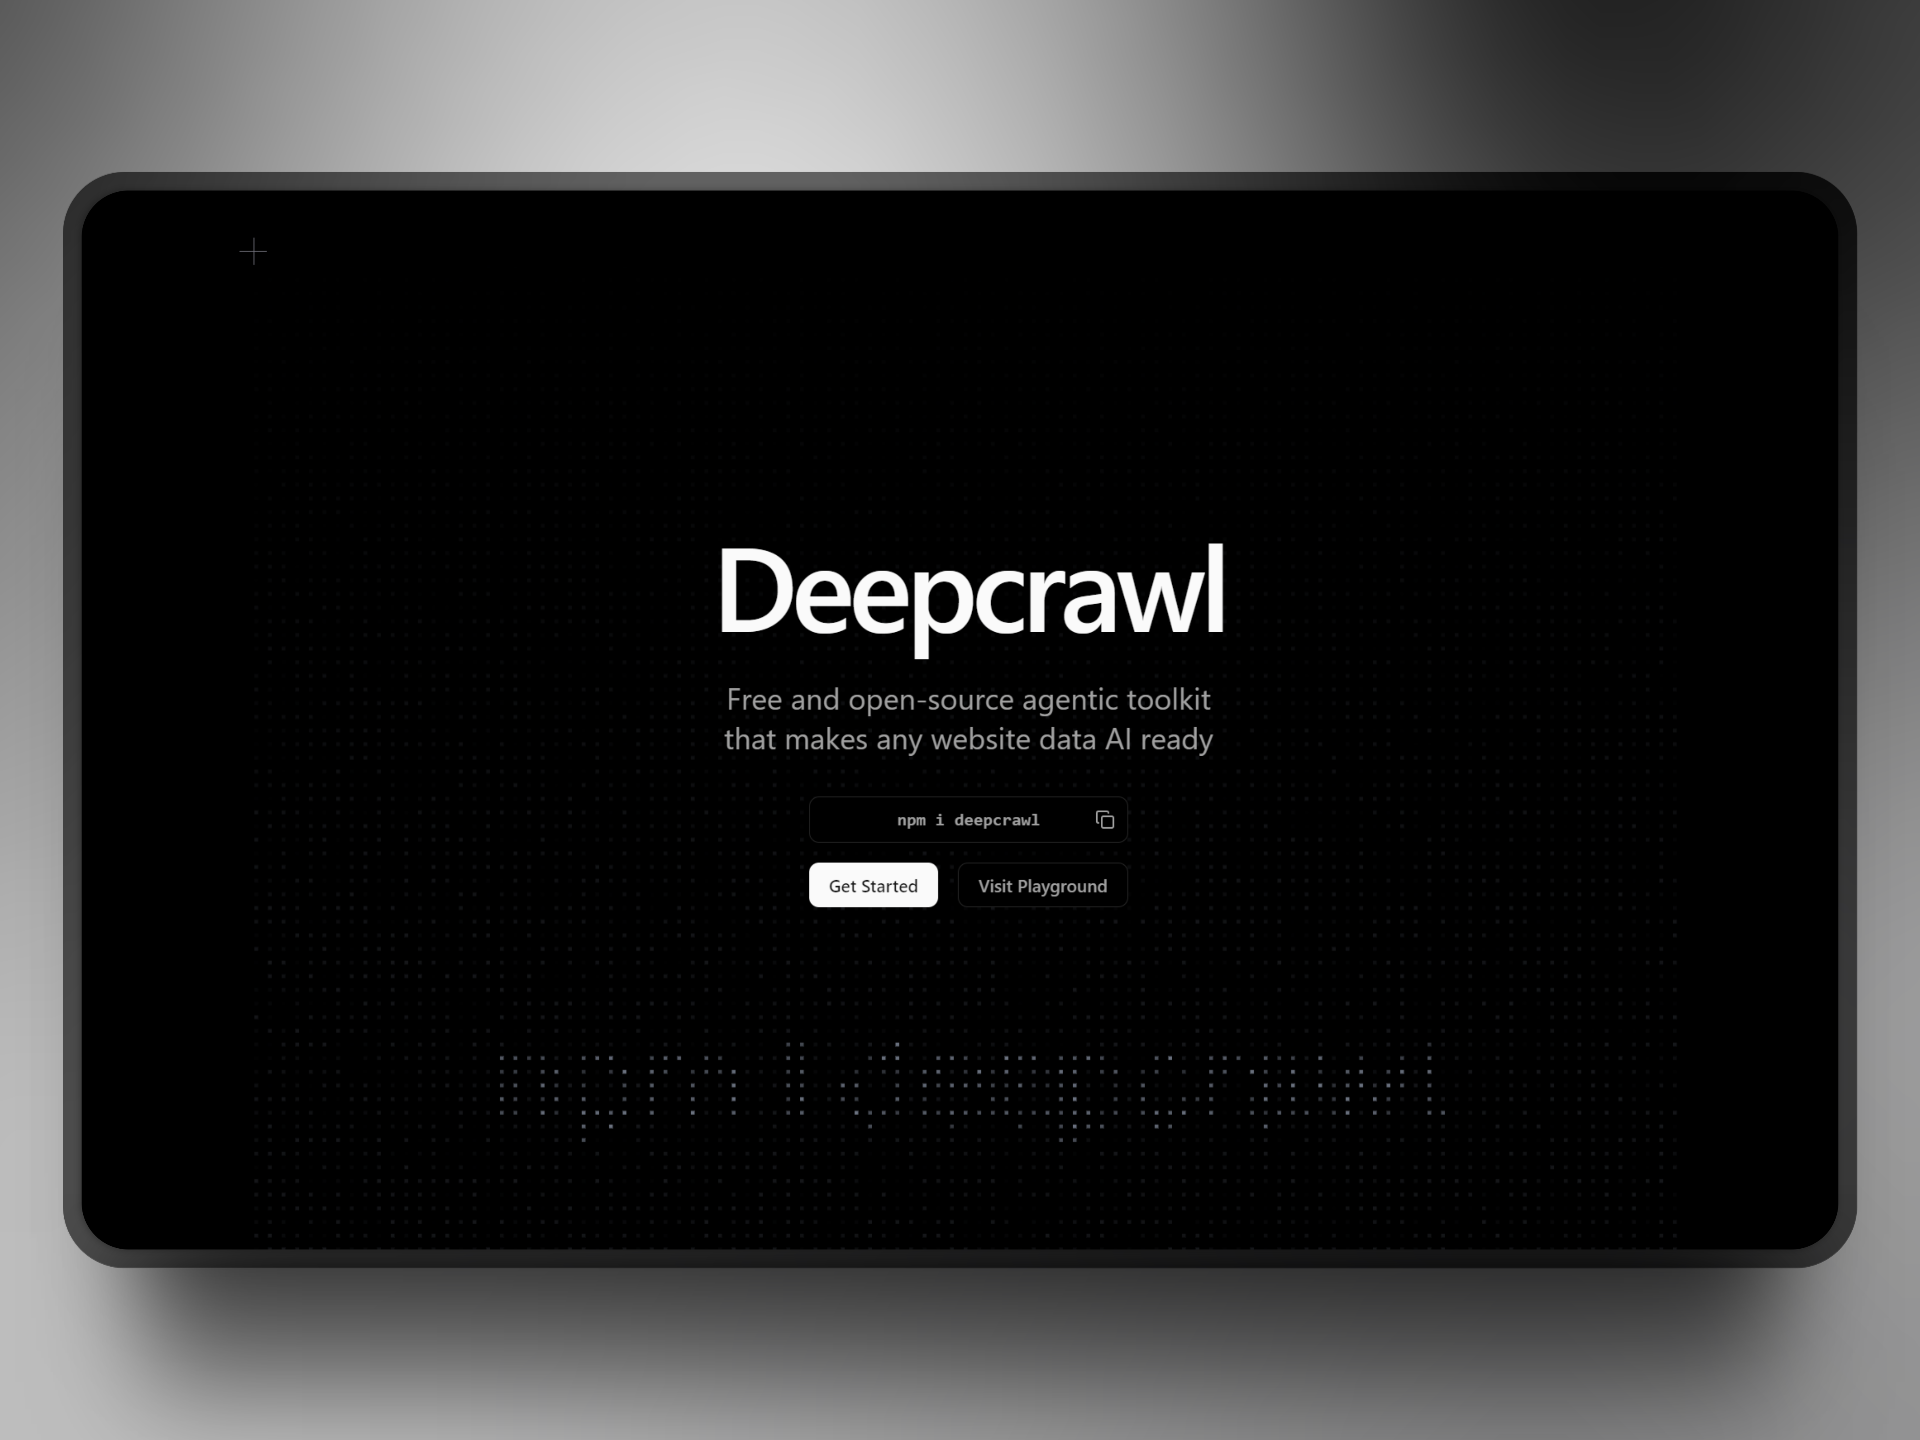
 Открытая платформа для извлечения веб-данных, ориентированная на агентов — самостоятельная альтернатива Firecrawl, которая превращает публичные страницы в чистый Markdown, дерево ссылок и метаданные, удобные для LLM.
Это хостинговое API, на которое я подписываюсь, как Firecrawl, или то, что я запускаю сам?Вы запускаете его сами: вся платформа — дашборд на Next.js, API-воркеры, воркеры аутентификации и база данных — с открытым исходным кодом, а разворачивается она в Cloudflare Workers или Vercel.
Вы запускаете его сами: вся платформа — дашборд на Next.js, API-воркеры, воркеры аутентификации и база данных — с открытым исходным кодом, а разворачивается она в Cloudflare Workers или Vercel.Как мне развернуть свой собственный экземпляр?Склонируйте репозиторий (это монорепозиторий на pnpm + Turborepo), выполните 'pnpm install' с Node.js 20+ и запускайте 'turbo dev' локально; в репозиторий также входят GitHub Actions воркфлоу, которые разворачивают воркеры аутентификации и API.
Склонируйте репозиторий (это монорепозиторий на pnpm + Turborepo), выполните 'pnpm install' с Node.js 20+ и запускайте 'turbo dev' локально; в репозиторий также входят GitHub Actions воркфлоу, которые разворачивают воркеры аутентификации и API.Безопасно ли использовать это сейчас в продакшене?Пока нет — README предостерегает от использования в продакшене: Deepcrawl активно разрабатывается, может измениться, и вы используете его на свой страх и риск.
Пока нет — README предостерегает от использования в продакшене: Deepcrawl активно разрабатывается, может измениться, и вы используете его на свой страх и риск.Мне нужно заниматься созданием AI-агентов, чтобы это было полезно?В первую очередь это для разработчиков AI-агентов — платформа оптимизирована под высокочастотные агентские нагрузки, которые парсят публичные страницы и получают чистый Markdown и дерево ссылок в качестве контекста для модели.
В первую очередь это для разработчиков AI-агентов — платформа оптимизирована под высокочастотные агентские нагрузки, которые парсят публичные страницы и получают чистый Markdown и дерево ссылок в качестве контекста для модели.Она правда полностью бесплатна, или тут есть подвох?Да, она бесплатна — лицензия MIT по метаданным репозитория, а README подчёркивает open source и открытый код; единственная реальная стоимость — ваш собственный хостинг на Cloudflare или Vercel.
Да, она бесплатна — лицензия MIT по метаданным репозитория, а README подчёркивает open source и открытый код; единственная реальная стоимость — ваш собственный хостинг на Cloudflare или Vercel.Что Deepcrawl возвращает для каждой просканированной страницы?Очищенный Markdown содержимого страницы, иерархическое дерево ссылок (любимое агентами) и метаданные — всё упаковано так, чтобы LLM усваивали это с минимальным расходом токенов, что снижает переключение контекста и галлюцинации.
Очищенный Markdown содержимого страницы, иерархическое дерево ссылок (любимое агентами) и метаданные — всё упаковано так, чтобы LLM усваивали это с минимальным расходом токенов, что снижает переключение контекста и галлюцинации.Почему стоит выбрать Deepcrawl, а не Firecrawl?Автор подаёт его как 100% бесплатную полностью open-source альтернативу с лучшей производительностью, гибкостью и извлечением ссылок для агентов — а поскольку вся платформа (дашборд, воркеры, база данных) открыта, вы можете запустить свой экземпляр на Cloudflare или Vercel.
Автор подаёт его как 100% бесплатную полностью open-source альтернативу с лучшей производительностью, гибкостью и извлечением ссылок для агентов — а поскольку вся платформа (дашборд, воркеры, база данных) открыта, вы можете запустить свой экземпляр на Cloudflare или Vercel.Может ли он обходить антибот-защиту или CAPTCHA?Нет — README прямо говорит, что Deepcrawl не предназначен для обхода анти-скрейпинга или антибот-защиты; он создан для высокочастотного парсинга публичных страниц.
Нет — README прямо говорит, что Deepcrawl не предназначен для обхода анти-скрейпинга или антибот-защиты; он создан для высокочастотного парсинга публичных страниц.На каком стеке он работает?TypeScript от начала до конца в монорепозитории на pnpm + Turborepo: дашборд на Next.js, API- и auth-воркеры на Hono, oRPC для слоя API и Better Auth для аутентификации, всё требует Node.js 20+.
TypeScript от начала до конца в монорепозитории на pnpm + Turborepo: дашборд на Next.js, API- и auth-воркеры на Hono, oRPC для слоя API и Better Auth для аутентификации, всё требует Node.js 20+.What are similar projects?maxun, firecrawl, Scrapegraph-ai, hono, Scrapling, react-starter-kit, scrapy, all-set-tw
maxun, firecrawl, Scrapegraph-ai, hono, Scrapling, react-starter-kit, scrapy, all-set-twWhich topics is it in?ai-sdk, crawling, hono, web-scraper, ai-agent-tools, data-extraction, crawler, vercel, cloudflare-workers, serverless, cloudflare, web-scraping
ai-sdk, crawling, hono, web-scraper, ai-agent-tools, data-extraction, crawler, vercel, cloudflare-workers, serverless, cloudflare, web-scraping