
ChatPaper README

The project's README from github.com/kaixindelele/ChatPaper. As one markdown file: README.md.

中文 | English

💥💥💥11.19 ChinarXiv - Arxiv论文翻译工具 我最近开源了本地PDF翻译+Arxiv翻译的一个完整解决方案,欢迎大家使用和star!也欢迎使用免费不用注册的chinarxiv.chatpaper.top

💥💥💥7.23 MasterYip 同学开源了 ChatPaper2Xmind! 将论文PDF通过Chat一键生成 图片+公式的简要XMind笔记。

💥💥💥7.22 仓库的文件做了一个整理,可能会有些路径和bug,正在修复中。 增加全新的本地PDF全文翻译功能!⛏️PDF全文翻译配置教程

历史重大更新
  • 🌟2023.07.23: MasterYip 同学开源了 ChatPaper2Xmind! 将论文PDF通过Chat一键生成 图片+公式的简要XMind笔记。
  • 🌟2023.07.22: 增加全新的本地PDF全文翻译功能!⛏️PDF全文翻译配置教程
  • 🌟2023.07.21: 仓库的文件做了一个整理,可能会有些路径和bug,正在修复中。
  • 🌟2023.07.09: 师弟red-tie在auto-draft的基础上,优化了一款一键文献综述的功能. 适用于大家对具体某个领域快速掌握,并且支持直接生成中文文献调研报告。文件配置简单,欢迎大家使用和反馈!
  • 🌟2023.07.05: 昨天我做了一个新的小玩具:ChatSensitiveWords,利用LLM+敏感词库,来自动判别是否涉及敏感词。已经在学术版GPT网页端上线,欢迎LLM的开发者一起完善这个工作。
  • 🌟2023.04.30: 唯一官方网站:https://chatpaper.org/ ,以及小白教程【ChatPaper网页版使用小白教程-哔哩哔哩】 https://b23.tv/HpDkcBU, 第三方文档:https://chatpaper.readthedocs.io .
  • 🌟2023.04.22: 为了庆祝ChatPaper获得一万⭐,我们将联合两位同学,推出两个AI辅助文献总结工具,第一个是auto-draft,AI自动搜集整理出文献总结!
  • 🌟2023.04.17: 为了降低学术伦理风险,我们为Chat_Reviewer增加了复杂的文字注入,效果如图:示例图 ,希望各位老师同学在使用的时候,一定要注意学术伦理和学术声誉,不要滥用工具。如果谁有更好的方法来限制少数人的不规范使用,欢迎留言,为科研界做一份贡献。
  • 🌟2023.03.31: 目前已经离线总结了3w+的CCF-A会议论文了,以后大家可以不用等那么久了!
  • 🌟2023.03.28: 荣胜同学今天发布了一个非常有意思的工作ChatGenTitle,提供摘要生成标题,基于220wArXiv论文的数据微调的结果!
  • 🌟2023.03.23: chat_arxiv.py可以从arxiv网站,根据关键词,最近几天,几篇论文,直接爬取最新的领域论文了!解决了之前arxiv包的搜索不准确问题!
  • 🌟2023.03.23: ChatPaper终于成为完成体了!现在已经有论文总结+论文润色+论文分析与改进建议+论文审稿回复等功能了!

ChatPaper

希望让语言不再成为中国人获取最新知识的障碍

GitHub Contributors Issues GitHub pull requests GitHub stars
一站式服务 / 简单 / 快速 / 高效
视频教程 · 在线体验

ChatPaper全流程加速科研:论文总结+专业级翻译+润色+审稿+审稿回复

工具名称 工具作用 是否在线? 在线预览 备注
ChatPaper 通过ChatGPT实现对论文进行总结,帮助科研人进行论文初筛 访问chatpaper.org 使用 ![F LJTRX$DNFU`KR M7{E6Q](https://github.com/kaixindelele/ChatPaper/assets/28528386/ceda14e8-7330-40d2-859e-0d39d99a2dfb) 原项目地址
ChatReviewer 利用ChatGPT对论文进行优缺点分析,提出改进建议 访问ShiwenNi/ChatReviewer 使用 Animation Demo 原项目地址
ChatImprovement 利用ChatGPT对论文初稿进行润色、翻译等 访问学术版GPT 使用 网页版 原项目地址
ChatResponse 利用ChatGPT对审稿人的提问进行回复 访问ShiwenNi/ChatResponse 使用 Animation Demo 原项目地址
ChatGenTitle 利用百万arXiv论文元信息训练出来的论文题目生成模型,根据论文摘要生成合适题目 Open In Colab Animation Demo 原项目地址

所有功能免费,代码开源,大家放心使用! 关于API如何获取,首先你得有一个没有被封的ChatGPT账号,然后获取Api Key ,填入即可!

目录:

最新讯息

开发动机

开发动机细节

面对每天海量的arxiv论文,以及AI极速的进化,我们人类必须也要一起进化才能不被淘汰。

作为中科大强化学习方向的博士生,我深感焦虑,现在AI的进化速度,我开脑洞都赶不上。

因此我开发了这款ChatPaper,尝试用魔法打败魔法。

ChatPaper是一款论文总结工具。AI用一分钟总结论文,用户用一分钟阅读AI总结的论文。

它可以根据用户输入的关键词,自动在arxiv上下载最新的论文,再利用ChatGPT3.5的API接口强大的总结能力,将论文总结为固定的格式,以最少的文本,最低的阅读门槛,为大家提供最大信息量,以决定该精读哪些文章。

也可以提供本地的PDF文档地址,直接处理。

一般一个晚上就可以速通一个小领域的最新文章。我自己测试了两天了。

祝大家在这个极速变化的时代中,能够和AI一起进化!

欢迎大家的赞助,以帮助支付网页运营的API和服务器成本,并让我们有动力继续开发更多更高质量的服务!

您的支持,是我持续更新的动力和赞赏!

欢迎大家加入光荣的进化!

技术原理:

技术原理细节

论文总结遵循下面四个问题:

  1. 研究背景

  2. 过去的方案是什么?他们有什么问题?

  3. 本文方案是什么?具体步骤是什么?

  4. 本文在哪些任务中,取得了什么效果?

基本上是大家做论文汇报的主要内容了。

实现细节: 提取摘要和introduction的内容,因为abstract很少会告诉你过去的方案是什么,存在什么问题。

然后提取method章节,总结方法的具体步骤

最后提取conclusion章节,总结全文。

分三次总结和喂入,如果每个部分超过了长度,则截断(目前这个方案太粗暴了,但也没有更好的更优雅的方案)

作为初筛,勉强够用。

配置教程

配置教程细节

一、以脚本方式运行

Windows, Mac和Linux系统应该都可以

python版本最好是3.9,其他版本应该也没啥问题

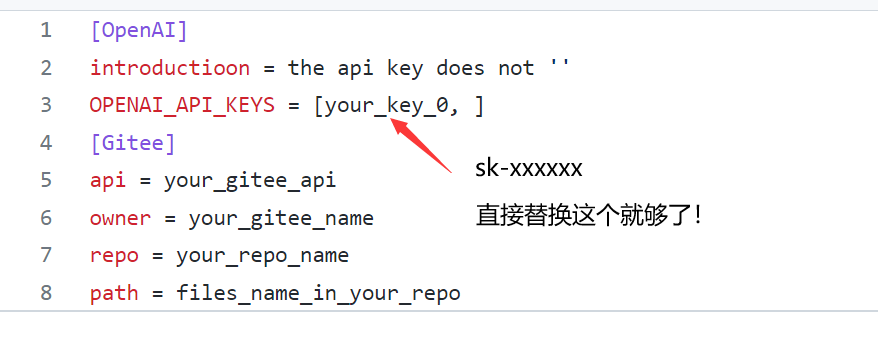
  1. 在apikey.ini中填入你的openai key。注意,这个代码纯本地项目,你的key很安全!如果不被OpenAI封的话~ 小白用户比较多,我直接给截图示意下可能会更好:
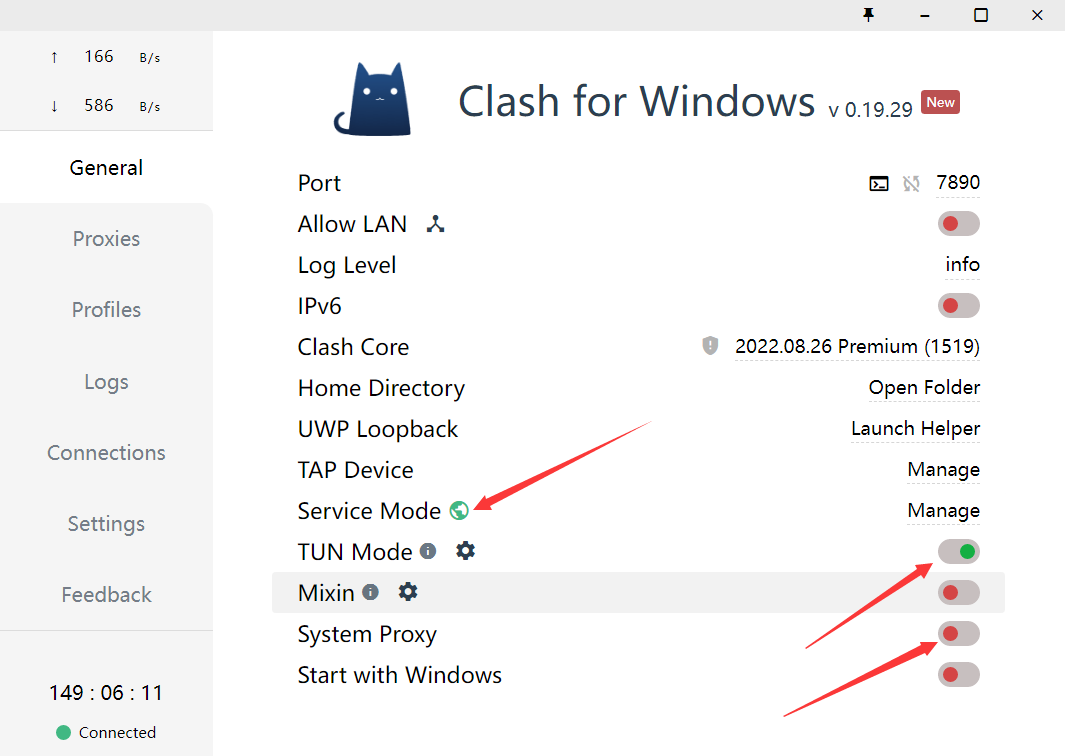
  1. 使用过程要保证全局代理! 如果客户端时clash的话,可以参考这个进行配置:
  1. 安装依赖:最好翻墙,或者用国内源。
pip install -r requirements.txt

4.1. Arxiv在线批量搜索+下载+总结: 运行chat_paper.py, 比如:

python chat_paper.py --query "chatgpt robot" --filter_keys "chatgpt robot" --max_results 3

更准确的脚本是chat_arxiv.py,使用方案,命令行更加简洁:

python chat_arxiv.py --query "chatgpt robot" --page_num 2 --max_results 3 --days 10

其中query仍然是关键词,page_num是搜索的页面,每页和官网一样,最大是50篇,max_results是最终总结前N篇的文章,days是选最近几天的论文,严格筛选!

注意:搜索词无法识别-,只能识别空格!所以原标题的连字符最好不要用! 感谢网友提供的信息

4.2. Arxiv在线批量搜索+下载+总结+高级搜索: 运行chat_paper.py, 比如:

python chat_paper.py --query "all: reinforcement learning robot 2023" --filter_keys "reinforcement robot" --max_results 3

💥💥💥7K星了,发布一个猫娘版提示词,希望大家一起让猫娘活起来~:脚本:chat_arxiv_maomao.py, 总结图片

4.3. Arxiv在线批量搜索+下载+总结+高级搜索+指定作者: 运行chat_paper.py, 比如:

python chat_paper.py --query "au: Sergey Levine" --filter_keys "reinforcement robot" --max_results 3

4.4. 本地pdf总结: 运行chat_paper.py, 比如:

python chat_paper.py --pdf_path "demo.pdf"

4.5. 本地文件夹批量总结: 运行chat_paper.py, 比如:

python chat_paper.py --pdf_path "your_absolute_path"

4.6. 谷歌学术论文整理: 运行google_scholar_spider.py, 比如:

python google_scholar_spider.py --kw "deep learning" --nresults 30 --csvpath "./data" --sortby "cit/year" --plotresults 1

此命令在Google Scholar上搜索与“deep learning”相关的文章,检索30个结果,将结果保存到“./data”文件夹中的CSV文件中,按每年引用次数排序数据,并绘制结果。

具体使用和参数请参考https://github.com/JessyTsu1/google_scholar_spider

4.7. Gitee图床的配置教程(选配,比较麻烦)

效果和配置视频:https://www.bilibili.com/video/BV1Rh4y1173t/ 教程文章:https://zhuanlan.zhihu.com/p/644326031


另外注意,目前这个不支持综述类文章。

B站讲解视频:我把ChatPaper开源了!AI速读PDF论文和速通Arxiv论文

注意:key_word不重要,但是filter_keys非常重要! 一定要修改成你的关键词。

另外关于arxiv的搜索关键词可以参考下图:

  1. 参数介绍:
[--pdf_path 是否直接读取本地的pdf文档?如果不设置的话,直接从arxiv上搜索并且下载] 
[--query 向arxiv网站搜索的关键词,有一些缩写示范:all, ti(title), au(author),一个query示例:all: ChatGPT robot] 
[--key_word 你感兴趣领域的关键词,重要性不高] 
[--filter_keys 你需要在摘要文本中搜索的关键词,必须保证每个词都出现,才算是你的目标论文] 
[--max_results 每次搜索的最大文章数,经过上面的筛选,才是你的目标论文数,chat只总结筛选后的论文] 
[--sort arxiv的排序方式,默认是相关性,也可以是时间,arxiv.SortCriterion.LastUpdatedDate 或者 arxiv.SortCriterion.Relevance, 别加引号] 
[--save_image 是否存图片,如果你没注册gitee的图床的话,默认为false] 
[--file_format 文件保存格式,默认是markdown的md格式,也可以是txt] 

parser.add_argument("--pdf_path", type=str, default='', help="if none, the bot will download from arxiv with query")
parser.add_argument("--query", type=str, default='all: ChatGPT robot', help="the query string, ti: xx, au: xx, all: xx,")    
parser.add_argument("--key_word", type=str, default='reinforcement learning', help="the key word of user research fields")
parser.add_argument("--filter_keys", type=str, default='ChatGPT robot', help="the filter key words, 摘要中每个单词都得有,才会被筛选为目标论文")
parser.add_argument("--max_results", type=int, default=1, help="the maximum number of results")
parser.add_argument("--sort", default=arxiv.SortCriterion.Relevance, help="another is arxiv.SortCriterion.LastUpdatedDate")    
parser.add_argument("--save_image", default=False, help="save image? It takes a minute or two to save a picture! But pretty")
parser.add_argument("--file_format", type=str, default='md', help="导出的文件格式,如果存图片的话,最好是md,如果不是的话,txt的不会乱")

二、 以Flask服务运行

Flask配置教程

注意:更新版本后,可能有路径的报错

  1. 下载项目并进入项目目录
git clone https://github.com/kaixindelele/ChatPaper.git
cd ChatPaper
  1. 在项目根目录下的 apikey.ini 文件中填入您的 OpenAI 密钥。
  2. 配置虚拟环境并下载依赖
pip install virtualenv 
安装虚拟环境工具
virtualenv venv 
新建一个名为venv的虚拟环境
Linux/Mac下:
source venv/bin/activate

Windows下:
.\venv\Scripts\activate.bat

pip install -r requirements.txt
  1. 启动服务
python3 app.py
# 启动 Flask 服务。运行此命令后,Flask 服务将在本地的 5000 端口上启动�

ChatPaper (kaixindelele/ChatPaper)

Searching Database…

19.9K ·GitHub
这是什么?ChatPaper 通过 ChatGPT API 来总结 arXiv 论文:你给它几个关键词,它会下载最新匹配的论文,并把每篇压缩成固定格式的摘要,帮助科研人员快速判断哪些论文值得细读。
它是一个单独的总结脚本,还是一整套工具箱?是一整套工具箱:ChatPaper(总结)、ChatReviewer(优缺点分析)、ChatImprovement(润色和翻译稿件)、ChatResponse(起草给审稿人的回复)以及 ChatGenTitle(根据摘要生成论文标题)。
怎么在我自己的电脑上跑起来?以 Python 脚本方式运行(推荐 3.9;Windows、Mac 和 Linux 都支持):把你的 OpenAI key 填进 apikey.ini,安装依赖,然后运行 chatpaper.py 或 chatarxiv.py。还有一个 Flask 模式,用 python3 app.py 启动,会在本机 5000 端口提供服务。
我需要有 ChatGPT 账号才能用吗?需要——README 说你要有一个没被封禁的 ChatGPT 账号和自己的 OpenAI API key。它还提醒使用时保持全局代理开启,如果 pip 太慢可以通过镜像源安装依赖。
相信它的总结之前,有什么我该知道的吗?不支持综述类论文,搜索关键词不能带连字符(只能用空格),过长的段落会被生硬地截断,而且作者自己也说它只是一个初筛工具,不能代替精读。
除了 arXiv 关键词搜索,我还能给它喂什么?四种输入:通过 chatarxiv.py 按 arXiv 关键词抓取(可按最近天数和引用量前 N 篇筛选,每个搜索页最多 50 篇)、单个本地 PDF 文件、对整个本地文件夹批量处理,以及 Google Scholar 查询——googlescholarspider.py 会把结果按年度引用量排序导出成 CSV。
一份总结实际会告诉你论文的哪些内容?四个固定问题:研究背景、已有方法及其不足、这篇论文方法的具体步骤,以及它取得的结果。内部会提取摘要、引言、方法和结论部分,分三轮进行总结。
能不能不装任何东西就先试试?可以——chatpaper.org 有官方在线版,B 站上有新手视频教程,README 里也介绍了如何把应用部署到 HuggingFace。
作者为什么要做这个?他是中科大的强化学习博士生,觉得每天 arXiv 上新论文太多根本追不过来,于是做了 ChatPaper 来'以魔法打败魔法':AI 一分钟总结一篇论文,你花一分钟读完总结。
Size
36.2 MB
Stars
19.9K
Updated
CommitNov 19
Age
3y
Commits · 90 Days