
6.1K ·GitHub
Что это?
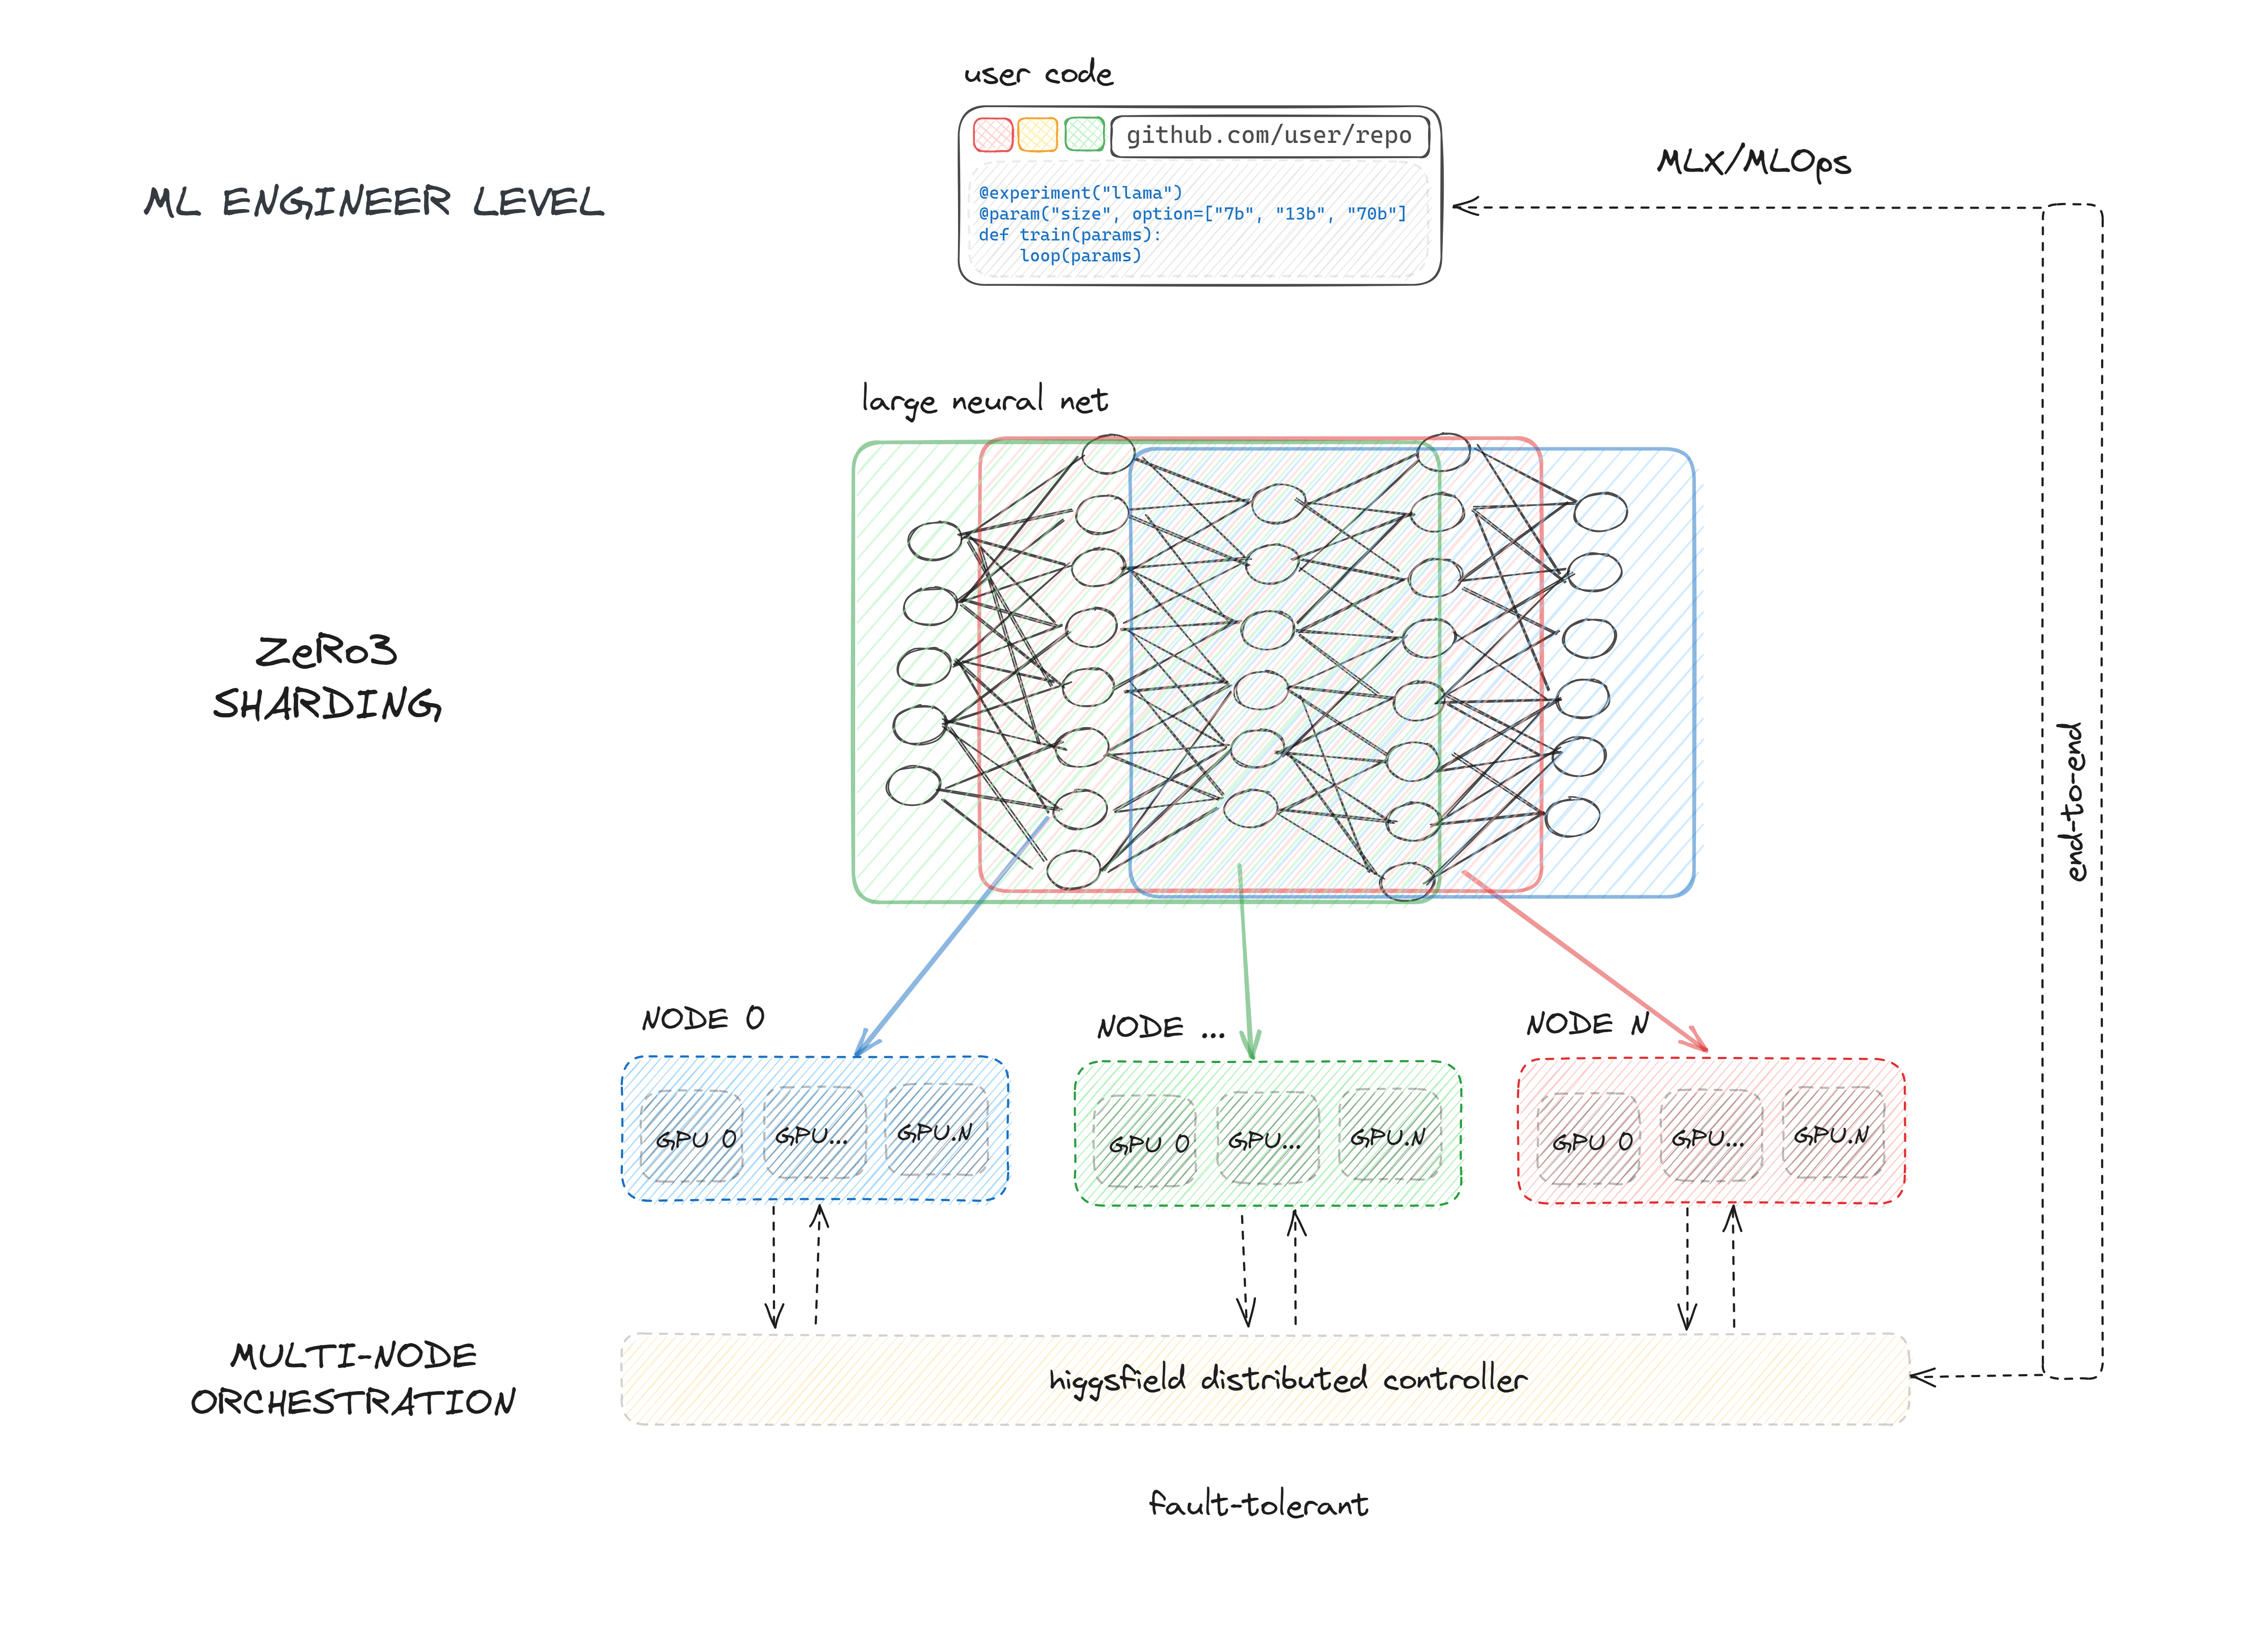
 Higgsfield — open-source отказоустойчивая система оркестрации GPU и фреймворк машинного обучения для обучения огромных моделей — от миллиардов до триллионов параметров, например LLM.
Это планировщик кластера, фреймворк обучения или и то, и другое?И то, и другое: это менеджер GPU-нагрузок, распределяющий вычисления между пользователями и ставящий эксперименты в очередь, плюс фреймворк на базе PyTorch для запуска, выполнения и мониторинга распределённых задач обучения.
И то, и другое: это менеджер GPU-нагрузок, распределяющий вычисления между пользователями и ставящий эксперименты в очередь, плюс фреймворк на базе PyTorch для запуска, выполнения и мониторинга распределённых задач обучения.Как запустить задачу обучения?Вы устанавливаете бинарник higgsfield, который настраивает Docker, ключи развёртывания и инструменты на вашем сервере, затем он генерирует GitHub-воркфлоу deploy и run, так что пуш в GitHub автоматически разворачивает ваш код на узлах.
Вы устанавливаете бинарник higgsfield, который настраивает Docker, ключи развёртывания и инструменты на вашем сервере, затем он генерирует GitHub-воркфлоу deploy и run, так что пуш в GitHub автоматически разворачивает ваш код на узлах.Каким требованиям должны соответствовать мои узлы обучения?Каждый узел должен работать на Ubuntu, быть доступным по SSH и иметь пользователя без root с правами sudo без пароля.
Каждый узел должен работать на Ubuntu, быть доступным по SSH и иметь пользователя без root с правами sudo без пароля.С какими облачными провайдерами он реально работает?Он проверен только на Azure, LambdaLabs и FluidStack; другие облака могут работать, но без гарантий, а при проблемах просят открыть issue.
Он проверен только на Azure, LambdaLabs и FluidStack; другие облака могут работать, но без гарантий, а при проблемах просят открыть issue.Поддерживает ли он шардирование DeepSpeed или PyTorch FSDP?Да, Higgsfield поддерживает ZeRO-3 DeepSpeed API и API полностью шардированной параллельной обработки данных (FSDP) в PyTorch для эффективного шардирования моделей с триллионами параметров.
Да, Higgsfield поддерживает ZeRO-3 DeepSpeed API и API полностью шардированной параллельной обработки данных (FSDP) в PyTorch для эффективного шардирования моделей с триллионами параметров.Какую проблему решает очередь экспериментов?Она управляет борьбой пользователей за ресурсы, держа очередь запуска экспериментов, чтобы эксклюзивный и неэксклюзивный доступ к узлам распределялся честно.
Она управляет борьбой пользователей за ресурсы, держа очередь запуска экспериментов, чтобы эксклюзивный и неэксклюзивный доступ к узлам распределялся честно.Почему бы просто не писать обычные скрипты обучения на PyTorch?Higgsfield создан, чтобы убить «ад окружений» и «ад конфигов»: он стандартизирует версии зависимостей/драйверов на всех узлах и заменяет разросшиеся YAML-конфиги простым интерфейсом эксперимента.
Higgsfield создан, чтобы убить «ад окружений» и «ад конфигов»: он стандартизирует версии зависимостей/драйверов на всех узлах и заменяет разросшиеся YAML-конфиги простым интерфейсом эксперимента.Как GitHub вписывается в процесс обучения?GitHub Actions используется как основа развёртывания: когда код эксперимента попадает в GitHub, воркфлоу автоматически разворачивают его на ваших узлах, а запуски и чекпоинты можно наблюдать через интерфейс GitHub.
GitHub Actions используется как основа развёртывания: когда код эксперимента попадает в GitHub, воркфлоу автоматически разворачивают его на ваших узлах, а запуски и чекпоинты можно наблюдать через интерфейс GitHub.What are similar projects?metaflow, ray, ludwig, Meshy, skypilot, verl, train-llm-from-scratch, ColossalAI
metaflow, ray, ludwig, Meshy, skypilot, verl, train-llm-from-scratch, ColossalAIWhich topics is it in?cluster-management, llama2, model-training, distributed, distributed-training, mlops, azure, llama, training, ssh, neural-network, github-actions
cluster-management, llama2, model-training, distributed, distributed-training, mlops, azure, llama, training, ssh, neural-network, github-actions