




19.8K ·GitHub
这是什么?
 一组真实场景中的 Python 网页爬虫项目,每个项目针对一个特定的中国网站或应用:Taobao、JD、NetEase Music、Bilibili、12306 火车票、Douyin、小说网站、漫画网站等。
这是一个工具,还是一堆独立的脚本?它是一组独立的脚本和小项目,每个目标网站对应一个(例如 biqukan.py、douyin.py、bilibili.py、jd.py),而不是统一的框架或库。
它是一组独立的脚本和小项目,每个目标网站对应一个(例如 biqukan.py、douyin.py、bilibili.py、jd.py),而不是统一的框架或库。怎么运行其中一个爬虫?选择你想要的网站对应的脚本(例如 python biqukan.py、python bilibili.py -d cat -k cat -p 10、python jd.py -k mango),安装其中列出的第三方依赖,然后直接运行即可。
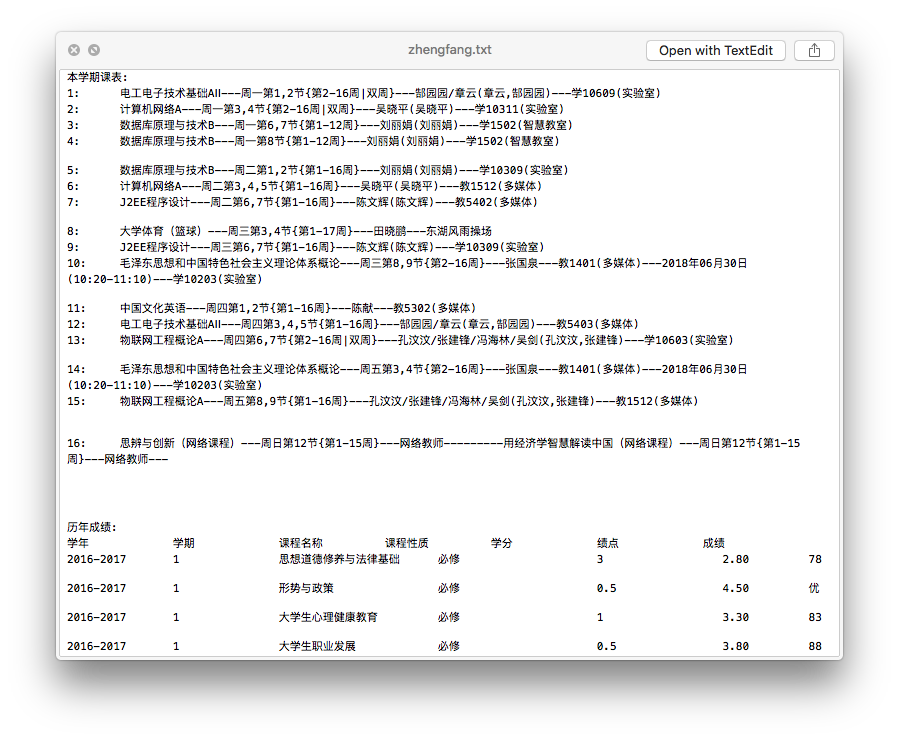
选择你想要的网站对应的脚本(例如 python biqukan.py、python bilibili.py -d cat -k cat -p 10、python jd.py -k mango),安装其中列出的第三方依赖,然后直接运行即可。运行这些脚本之前需要安装什么?主要是 requests 和 beautifulsoup4(pip3 install beautifulsoup4 / pip3 install requests beautifulsoup4);部分子项目(如 zhengfangsystemspider)有各自的 requirements.txt。
主要是 requests 和 beautifulsoup4(pip3 install beautifulsoup4 / pip3 install requests beautifulsoup4);部分子项目(如 zhengfangsystemspider)有各自的 requirements.txt。这些爬虫能保证一直可用吗?不能。它们抓取的是正在运行的第三方网站或应用,依赖其当前的页面结构或接口,随着时间推移很可能失效;部分脚本(如 baiduwenku.py)已明确标注为不完整,且不具有通用性。
不能。它们抓取的是正在运行的第三方网站或应用,依赖其当前的页面结构或接口,随着时间推移很可能失效;部分脚本(如 baiduwenku.py)已明确标注为不完整,且不具有通用性。这是面向谁的?面向初学者和希望动手学习 Python 网页爬虫技术的人,内容从简单的静态网站抓取,到应用接口的逆向分析都有涉及。
面向初学者和希望动手学习 Python 网页爬虫技术的人,内容从简单的静态网站抓取,到应用接口的逆向分析都有涉及。抖音下载器到底能做什么?它可以下载 Douyin 应用中的视频;后续版本新增了无水印下载功能,通过直接解析视频链接实现,而不是依赖第三方解析网站。
它可以下载 Douyin 应用中的视频;后续版本新增了无水印下载功能,通过直接解析视频链接实现,而不是依赖第三方解析网站。这个工具能下载音乐或视频内容吗?可以。有脚本可以根据歌单文件批量下载 NetEase Cloud Music 的歌曲,也有脚本可以批量下载 Bilibili 视频及其弹幕(评论浮层)文件。
可以。有脚本可以根据歌单文件批量下载 NetEase Cloud Music 的歌曲,也有脚本可以批量下载 Bilibili 视频及其弹幕(评论浮层)文件。有没有用来搭建代理 IP 池的工具?有。daili.py 可以搭建一个代理 IP 池,供仓库中的其他爬虫复用,以避免被封禁。
有。daili.py 可以搭建一个代理 IP 池,供仓库中的其他爬虫复用,以避免被封禁。有没有针对 12306 火车票抢票的内容?有。12306.py 是一个简单的抢票脚本,可以进一步扩展,适合有一定爬虫基础的人。
有。12306.py 是一个简单的抢票脚本,可以进一步扩展,适合有一定爬虫基础的人。What are similar projects?learn_python3_spider, PythonPark, MediaCrawler, Douyin_TikTok_Download_API, Python-Core-50-Courses, crawlab, TikTokDownloader, BettaFish
learn_python3_spider, PythonPark, MediaCrawler, Douyin_TikTok_Download_API, Python-Core-50-Courses, crawlab, TikTokDownloader, BettaFishWhich topics is it in?douyin, video-downloader, bilibili, scraper, crawler, python3, music, web-scraping, beginner-friendly, proxy, learning, tutorial
douyin, video-downloader, bilibili, scraper, crawler, python3, music, web-scraping, beginner-friendly, proxy, learning, tutorial