 Next-Concept Modeling



Что это такое?
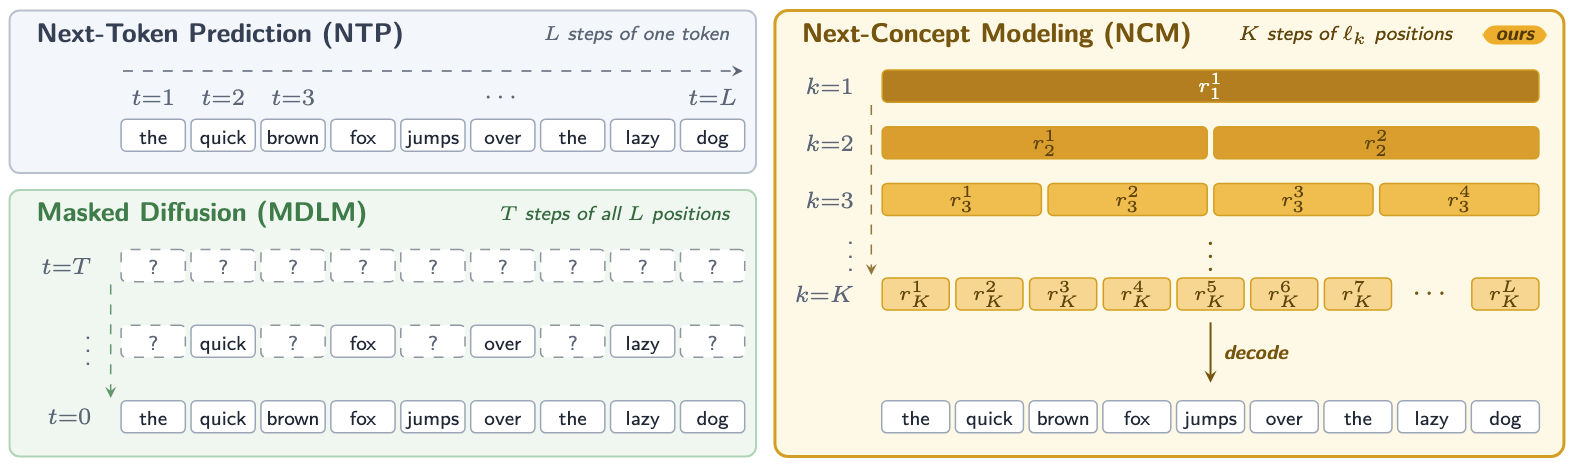
 NCM (Next-Concept Modeling) — это двухэтапная система для быстрой параллельной генерации текста: остаточный VQ-токенизатор превращает последовательность в иерархию дискретных кодов, а трансформер предсказывает эту иерархию от грубого к детальному, а не генерирует текст токен за токеном.
Это готовое приложение или исследовательский код с опубликованными весами модели?Это исследовательский код: код моделей-токенизатора и генератора плюс набор для оценки. Предобученные чекпойнты и токенизированные датасеты размещены отдельно на Hugging Face.
Это исследовательский код: код моделей-токенизатора и генератора плюс набор для оценки. Предобученные чекпойнты и токенизированные датасеты размещены отдельно на Hugging Face.Как мне запустить оценку опубликованной модели?Скачайте чекпойнт и входные данные для оценки под нужную задачу, затем запустите evaluate.py с подходящим конфигурационным файлом из config/eval/.
Скачайте чекпойнт и входные данные для оценки под нужную задачу, затем запустите evaluate.py с подходящим конфигурационным файлом из config/eval/.Что нужно установить перед запуском NCM?Python 3.10 или новее и сборку PyTorch с поддержкой CUDA. Нужны GPU, так как задачи оценки распределяются между всеми видимыми GPU.
Python 3.10 или новее и сборку PyTorch с поддержкой CUDA. Нужны GPU, так как задачи оценки распределяются между всеми видимыми GPU.Идёт ли в комплекте собственная обученная модель или мне нужно обучать её с нуля?Репозиторий содержит только код. Чтобы что-то сгенерировать, нужно скачать один из опубликованных чекпойнтов с замороженным токенизатором и генератором с Hugging Face для конкретной задачи, например XSum, WMT14 или судоку.
Репозиторий содержит только код. Чтобы что-то сгенерировать, нужно скачать один из опубликованных чекпойнтов с замороженным токенизатором и генератором с Hugging Face для конкретной задачи, например XSum, WMT14 или судоку.Какие задачи и датасеты поддерживает NCM из коробки?Опубликованные модели охватывают суммаризацию на XSum, перевод с немецкого на английский (WMT14), решение головоломок судоку и языковое моделирование на LM1B, TinyStories и OpenWebText.
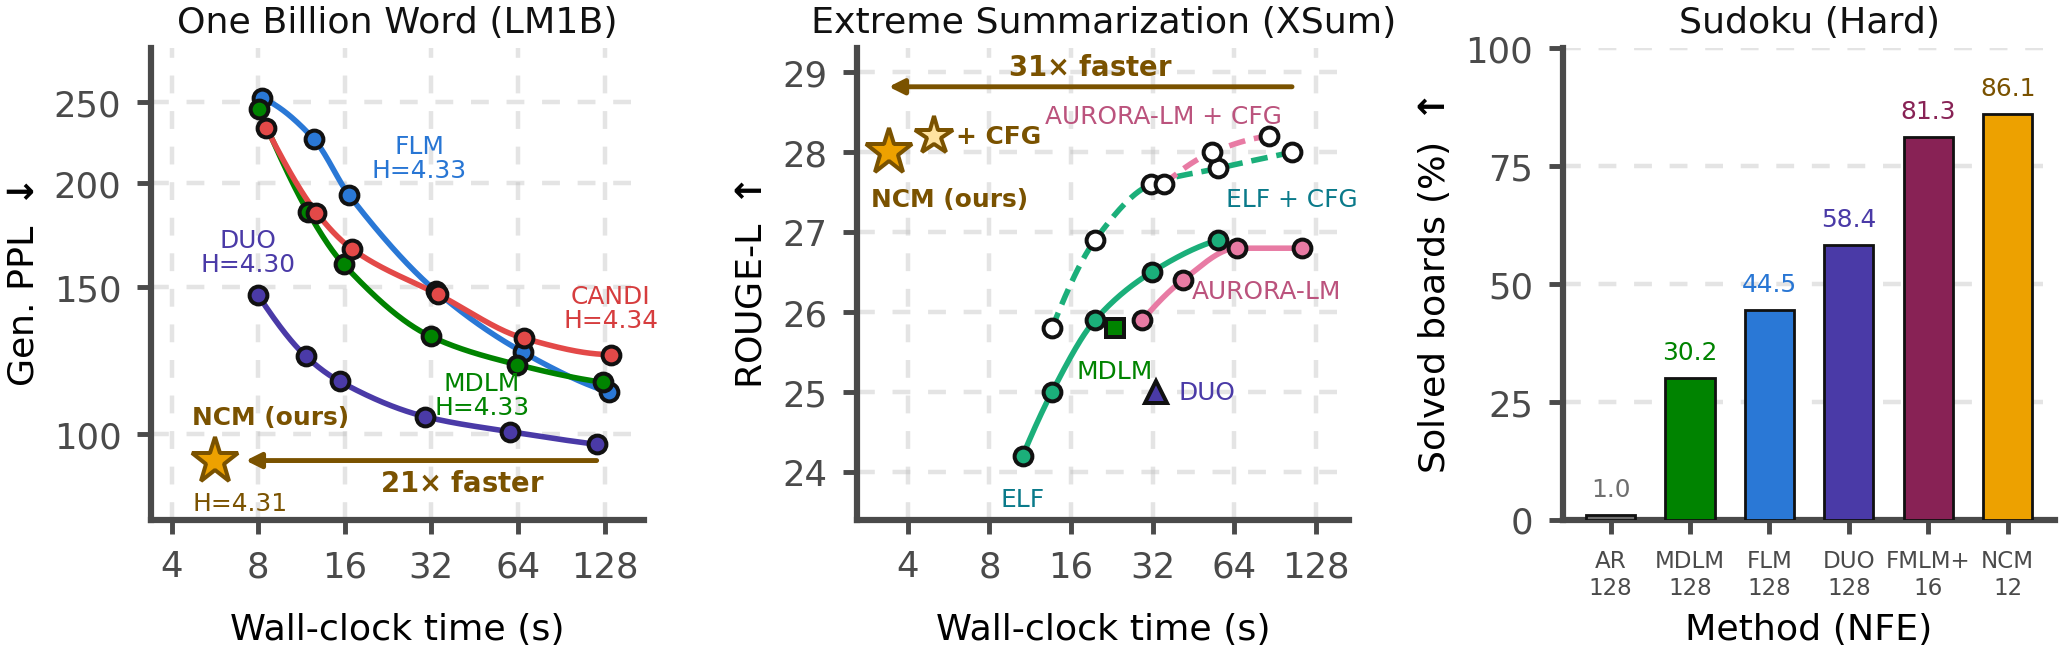
Опубликованные модели охватывают суммаризацию на XSum, перевод с немецкого на английский (WMT14), решение головоломок судоку и языковое моделирование на LM1B, TinyStories и OpenWebText.Насколько NCM быстрее диффузионной генерации текста?NCM не уступает или превосходит сильные диффузионные базовые модели и при этом генерирует в 9–31 раз быстрее, так как каждому уровню от грубого к детальному достаточно одного параллельного прохода вперёд.
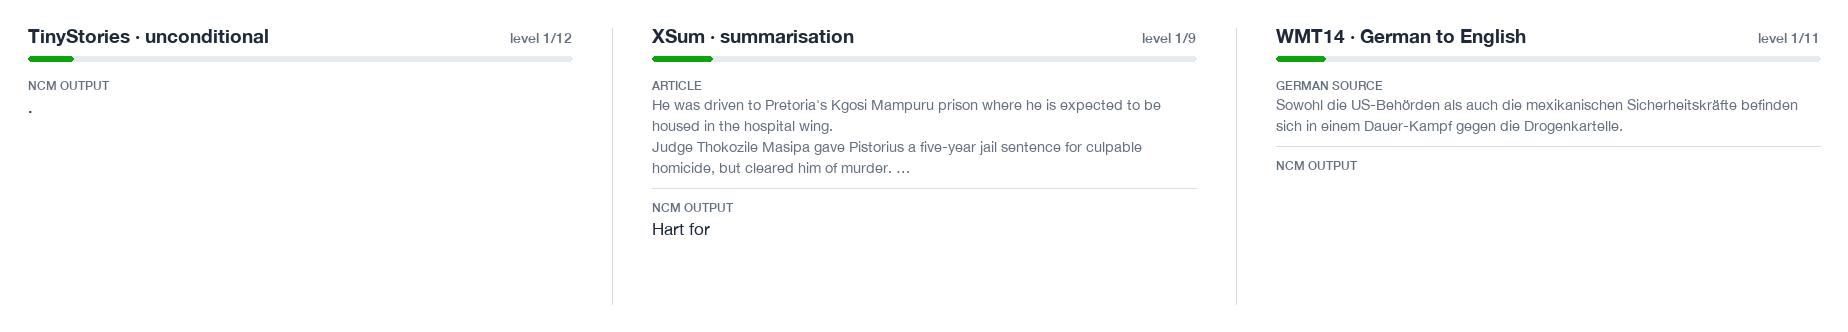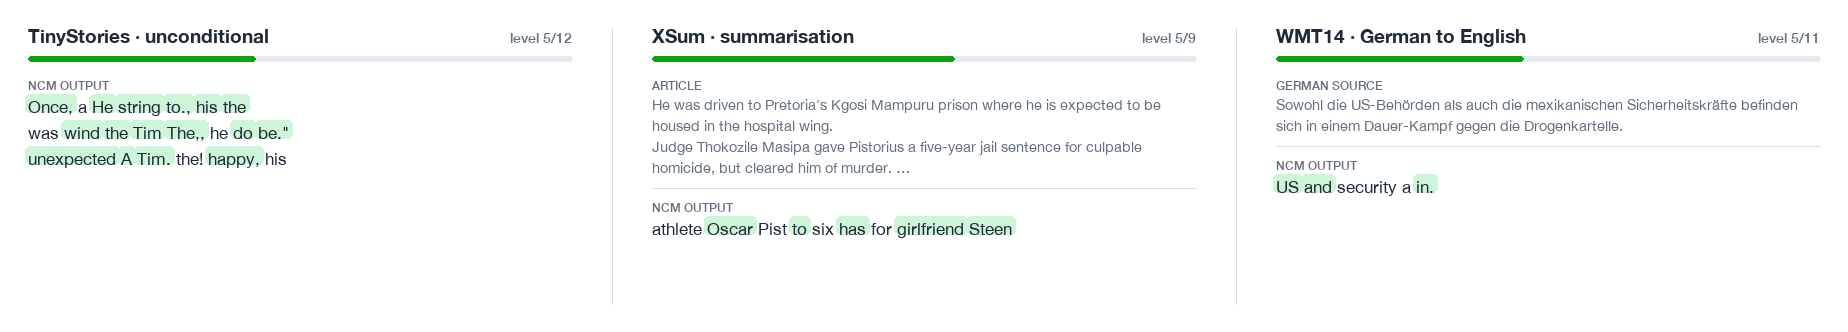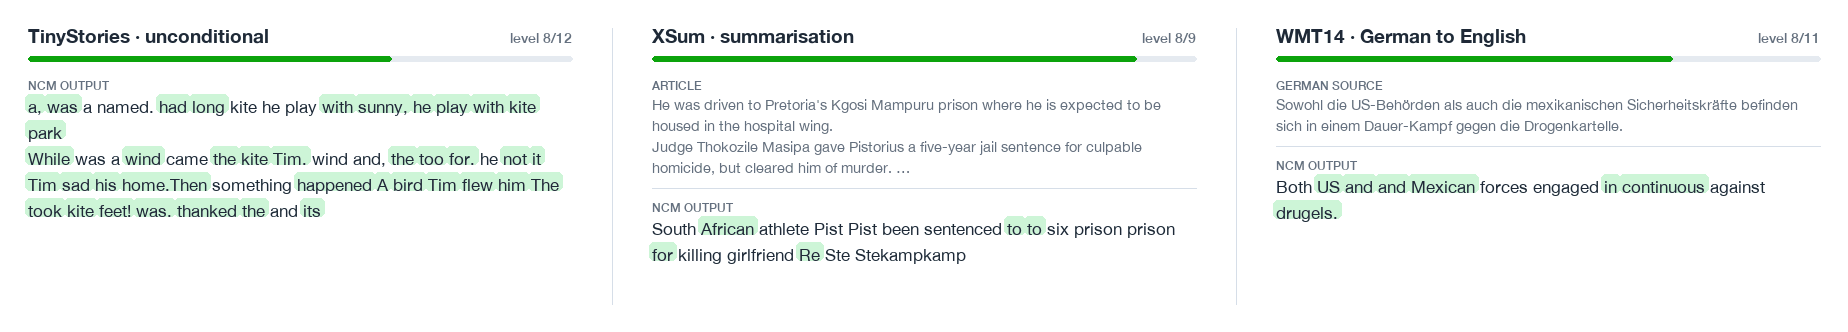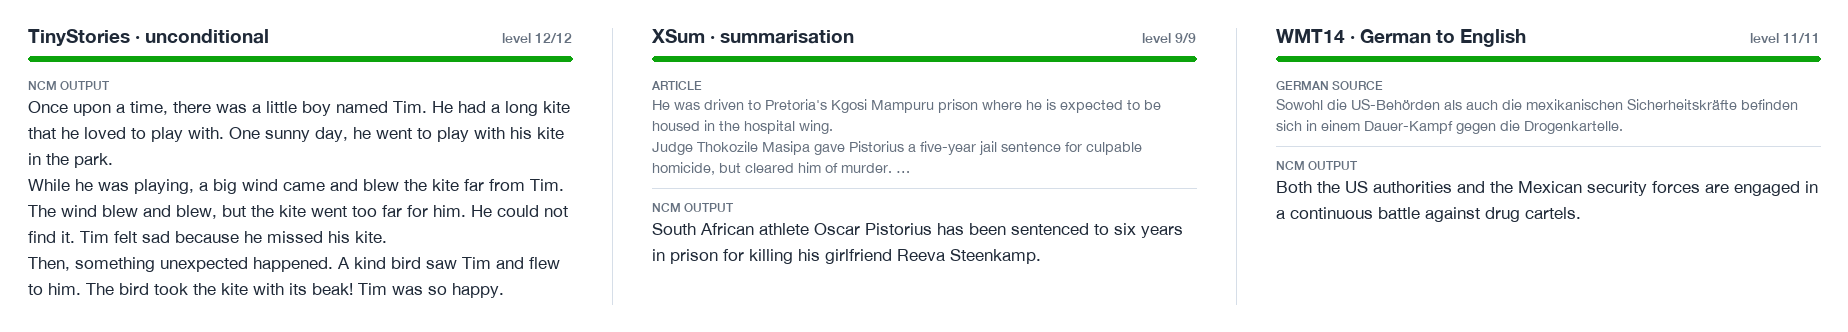
NCM не уступает или превосходит сильные диффузионные базовые модели и при этом генерирует в 9–31 раз быстрее, так как каждому уровню от грубого к детальному достаточно одного параллельного прохода вперёд.Как на самом деле выглядит генерация от грубого к детальному?Каждый уровень иерархии параллельно предсказывает последовательность длиннее предыдущей. Поэтому декодирование за несколько шагов постепенно превращает грубый набросок в итоговый результат полного разрешения.
Каждый уровень иерархии параллельно предсказывает последовательность длиннее предыдущей. Поэтому декодирование за несколько шагов постепенно превращает грубый набросок в итоговый результат полного разрешения.Для чего нужен флаг --cfg?Он включает classifier-free guidance при оценке на XSum и WMT14. В README результат с guidance приведён для --cfg 1.0.
Он включает classifier-free guidance при оценке на XSum и WMT14. В README результат с guidance приведён для --cfg 1.0.Какие есть похожие проекты?jeeves, pointdit, Chinese-BERT-wwm, PrismQuant, EasyWAM, Model-Optimizer, SparkDiffusion, marigold-v2
jeeves, pointdit, Chinese-BERT-wwm, PrismQuant, EasyWAM, Model-Optimizer, SparkDiffusion, marigold-v2