



1.7K ·GitHub
What is this?
 A pre-boot UEFI tool that lifts the Tensor compute limit on NVIDIA RTX 20, 30 and 40 cards. It boots from a USB stick, unlocks the card, then continues into Windows, Linux or another system, without flashing the VBIOS.
Is it a driver, a patch, or a firmware flash?None of those. It is a pre-driver UEFI loader that runs from a USB stick before the OS starts, then hands boot back to the normal system.
None of those. It is a pre-driver UEFI loader that runs from a USB stick before the OS starts, then hands boot back to the normal system.How do I get it running?Download the release package, run the USB-creation script on the target machine (it detects your GPU generation and fetches the matching firmware), then copy the contents of usbroot/ to a FAT32 stick. Boot the target from its one-time boot menu, pick the stick, press space at the version screen, and wait until it chains back to the system. Verify with ssdiag on Windows or tools/diag-unlock.py on Linux. Replay the unlock after every cold boot.
Download the release package, run the USB-creation script on the target machine (it detects your GPU generation and fetches the matching firmware), then copy the contents of usbroot/ to a FAT32 stick. Boot the target from its one-time boot menu, pick the stick, press space at the version screen, and wait until it chains back to the system. Verify with ssdiag on Windows or tools/diag-unlock.py on Linux. Replay the unlock after every cold boot.What do I need before starting?UEFI boot with Secure Boot turned off, or an EFI binary self-signed and trusted. Turing cards need a one-time admin PowerShell step and a reboot on Windows, and GSP firmware must be running before you build the stick. Windows needs PowerShell 5+, the Linux version needs glibc 2.34+, and building from source needs a Rust toolchain.
UEFI boot with Secure Boot turned off, or an EFI binary self-signed and trusted. Turing cards need a one-time admin PowerShell step and a reboot on Windows, and GSP firmware must be running before you build the stick. Windows needs PowerShell 5+, the Linux version needs glibc 2.34+, and building from source needs a Rust toolchain.What can go wrong?The unlock is lost after power loss or sleep, so it has to be replayed on each cold boot. If a run hits a STOP, an error or a black screen, do not retry in the same session. Fully power off, unplug the stick, and boot the original system. Gains also depend on power limits and precision path, so results vary.
The unlock is lost after power loss or sleep, so it has to be replayed on each cold boot. If a run hits a STOP, an error or a black screen, do not retry in the same session. Fully power off, unplug the stick, and boot the original system. Gains also depend on power limits and precision path, so results vary.Do I need Windows or Linux to run it?Not to unlock: the stick runs before any OS loads. The USB-creation script runs on Windows PowerShell or on Linux, WSL or Git Bash, and the card then boots into Windows, Linux or any other EFI-bootable system.
Not to unlock: the stick runs before any OS loads. The USB-creation script runs on Windows PowerShell or on Linux, WSL or Git Bash, and the card then boots into Windows, Linux or any other EFI-bootable system.Does it need internet access?Only when you generate the USB. The script downloads and verifies the NVIDIA firmware for your GPU generation, and if that fails you should fix the error rather than swap firmware versions. The unlock itself runs from the stick.
Only when you generate the USB. The script downloads and verifies the NVIDIA firmware for your GPU generation, and if that fails you should fix the error rather than swap firmware versions. The unlock itself runs from the stick.Which GPUs are supported?RTX 20, 30 and 40 series are supported, with laptops and desktops listed for 30 and 40. Some RTX 20 models have known issues, so check the full compatibility matrix. GTX 16 is listed as theoretically compatible and still needs hardware reports. Pascal and older, GA100 and RTX 50 are not supported.
RTX 20, 30 and 40 series are supported, with laptops and desktops listed for 30 and 40. Some RTX 20 models have known issues, so check the full compatibility matrix. GTX 16 is listed as theoretically compatible and still needs hardware reports. Pascal and older, GA100 and RTX 50 are not supported.Does it work on laptops too?Yes, RTX 30 and 40 series are listed as fully compatible for both laptops and desktops. There are also laptop reports for RTX 20, such as an RTX 2070 Laptop 8GB that passed.
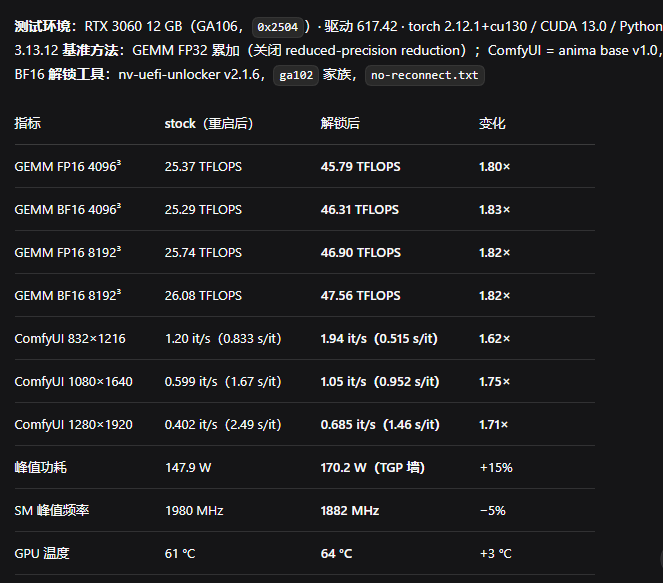
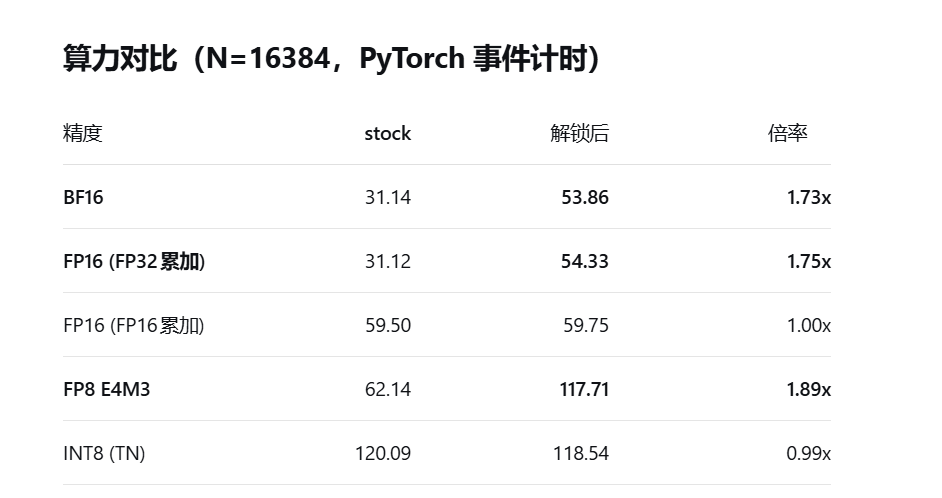
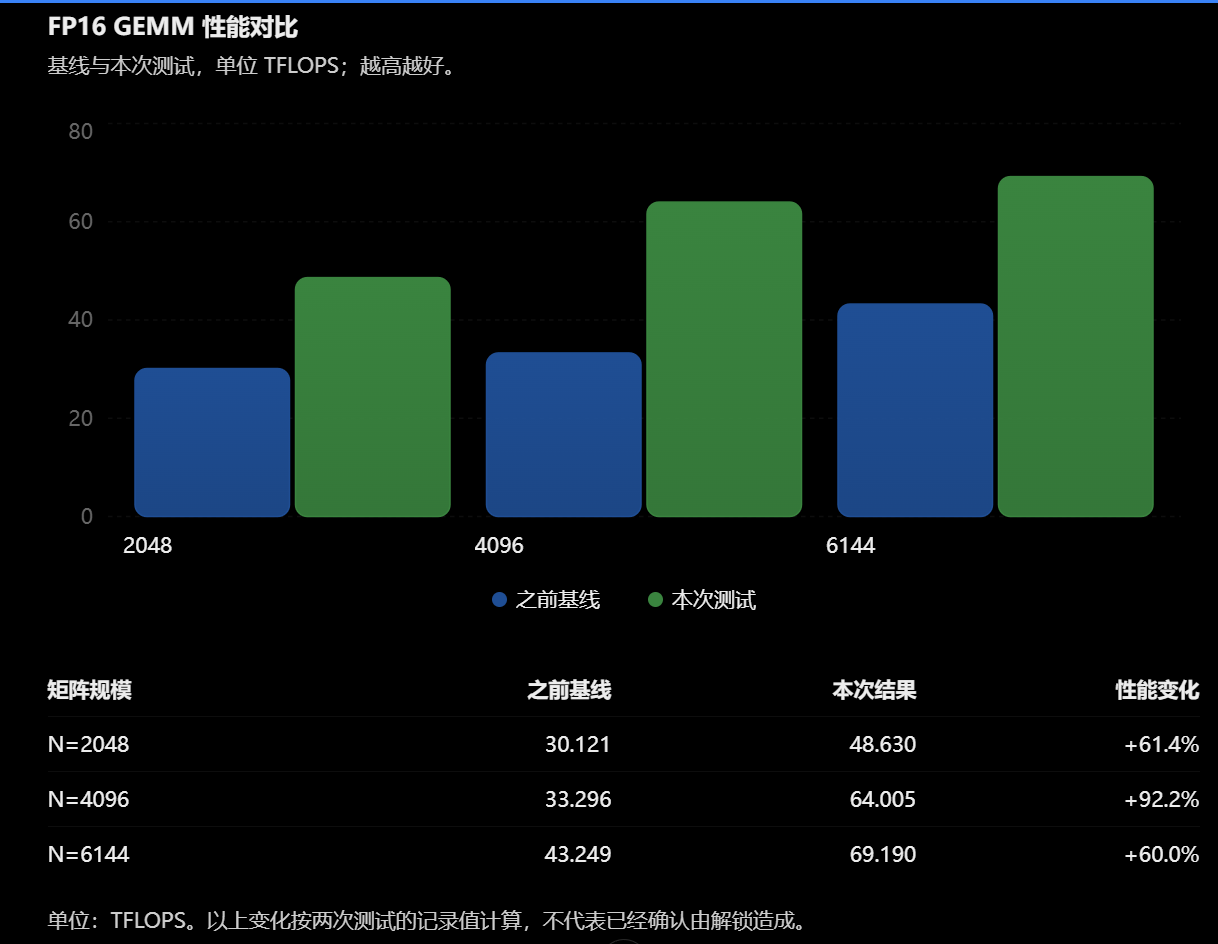
Yes, RTX 30 and 40 series are listed as fully compatible for both laptops and desktops. There are also laptop reports for RTX 20, such as an RTX 2070 Laptop 8GB that passed.How much faster does it get?Measured FP16, BF16 and TF32 tensor throughput rises up to about 2.6x and FP8 up to about 1.9x. Image or video generation improves by 14 to 75 percent, and LLM prefill by up to 19 percent (decode about 5 percent). Gains depend on power limits and precision path.
Measured FP16, BF16 and TF32 tensor throughput rises up to about 2.6x and FP8 up to about 1.9x. Image or video generation improves by 14 to 75 percent, and LLM prefill by up to 19 percent (decode about 5 percent). Gains depend on power limits and precision path.Why did the author build this?It is a student interest research project by an overclocking and GPU modding enthusiast. It was built with AI coding assistance, and every write step is checked by reading the value back and archiving the evidence.
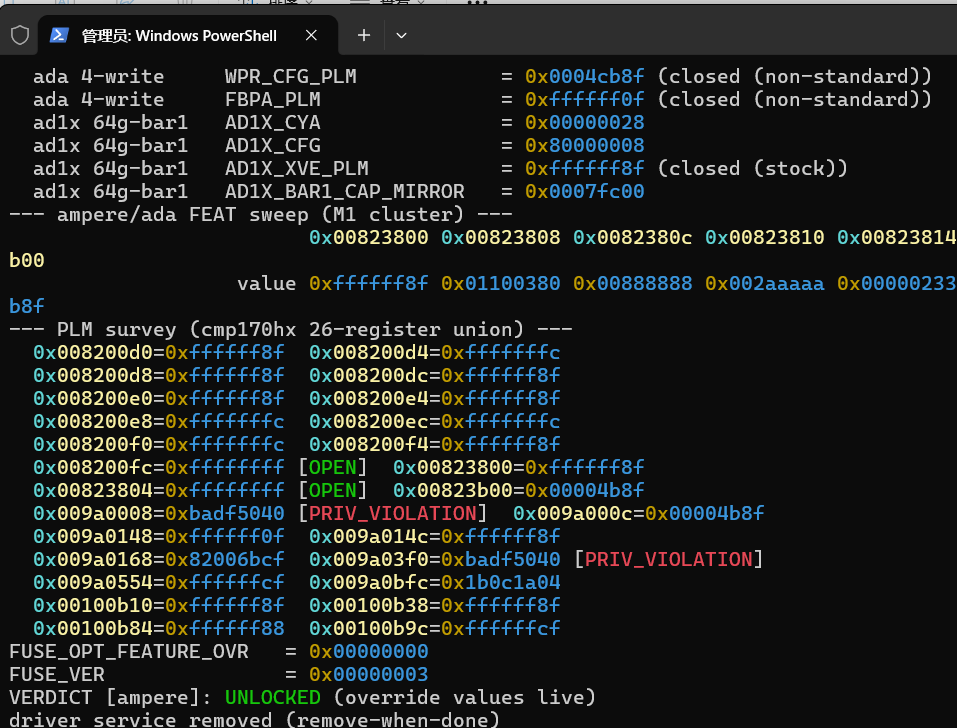
It is a student interest research project by an overclocking and GPU modding enthusiast. It was built with AI coding assistance, and every write step is checked by reading the value back and archiving the evidence.Can I undo it?Yes. Nothing is flashed to the VBIOS, so cutting power restores the stock state. Sleep or other power events can drop the unlock, so you replay it on the next cold boot.
Yes. Nothing is flashed to the VBIOS, so cutting power restores the stock state. Sleep or other power events can drop the unlock, so you replay it on the next cold boot.What are similar projects?gpu-unlock, Windows-GPU-UNLOCK, ReBarUEFI, gpu-unlock-ada, UniXNU, open-gpu-kernel-modules, virtio-nvgpu, ZLUDA
gpu-unlock, Windows-GPU-UNLOCK, ReBarUEFI, gpu-unlock-ada, UniXNU, open-gpu-kernel-modules, virtio-nvgpu, ZLUDAWhich topics is it in?bios, bootloader, boot, driver, low-level, gplv2, installer, systems-programming, firmware, gpu-acceleration, hardware, reverse-engineering
bios, bootloader, boot, driver, low-level, gplv2, installer, systems-programming, firmware, gpu-acceleration, hardware, reverse-engineering