What the f*ck Python! 🐍
一些有趣且鲜为人知的 Python 特性.
原始版本: | English
翻译版本: | Vietnamese Tiếng Việt | Spanish Español | Korean 한국어 | Russian Русский | German Deutsch | Add translation
其他模式: | Interactive
[![WTFPL 2.0][license-image]][license-url] [![Commit id][commit-image]][commit-url] [![996.icu][996.icu-image]][996.icu-url]
Python, 是一个设计优美的解释型高级语言, 它提供了很多能让程序员感到舒适的功能特性. 但有的时候, Python 的一些输出结果对于初学者来说似乎并不是那么一目了然.
这个有趣的项目意在收集 Python 中那些难以理解和反人类直觉的例子以及鲜为人知的功能特性, 并尝试讨论这些现象背后真正的原理!
虽然下面的有些例子并不一定会让你觉得 WTFs, 但它们依然有可能会告诉你一些你所不知道的 Python 有趣特性. 我觉得这是一种学习编程语言内部原理的好办法, 而且我相信你也会从中获得乐趣!
如果您是一位经验比较丰富的 Python 程序员, 你可以尝试挑战看是否能一次就找到例子的正确答案. 你可能对其中的一些例子已经比较熟悉了, 那这也许能唤起你当年踩这些坑时的甜蜜回忆 :sweat_smile:
PS: 如果你不是第一次读了, 你可以在这里获取变动内容.
那么, 让我们开始吧...
Table of Contents/目录
Structure of the Examples/示例结构
所有示例的结构都如下所示:
> 一个精选的标题 *
标题末尾的星号表示该示例在第一版中不存在,是最近添加的.
# 准备代码.
# 释放魔法...
Output (Python version):
>>> 触发语句
出乎意料的输出结果
(可选): 对意外输出结果的简短描述.
💡 说明:
注意: 所有的示例都在 Python 3.5.2 版本的交互解释器上测试过, 如果不特别说明应该适用于所有 Python 版本.
Usage/用法
我个人建议, 最好依次阅读下面的示例, 并对每个示例:
- 仔细阅读设置例子最开始的代码. 如果您是一位经验丰富的 Python 程序员, 那么大多数时候您都能成功预期到后面的结果.
- 阅读输出结果,
- 确认结果是否如你所料.
- 确认你是否知道这背后的原理.
- 如果不知道, 深呼吸然后阅读说明 (如果你还是看不明白, 别沉默! 可以在这提个 issue).
- 如果知道, 给自己点奖励, 然后去看下一个例子.
PS: 你也可以在命令行阅读 WTFpython. 我们有 pypi 包 和 npm 包(支持代码高亮).(译: 这两个都是英文版的)
安装 npm 包 wtfpython
$ npm install -g wtfpython
或者, 安装 pypi 包 wtfpython
$ pip install wtfpython -U
现在, 在命令行中运行 wtfpython, 你就可以开始浏览了.
👀 Examples/示例
Section: Strain your brain!/大脑运动!
> First things first!/要事优先 *
众所周知,Python 3.8 推出"海象"运算符 (:=) 方便易用,让我们一起看看。
1.
# Python 版本 3.8+

>>> a = "wtf_walrus"
>>> a
'wtf_walrus'

>>> a := "wtf_walrus"
File "<stdin>", line 1
    a := "wtf_walrus"
      ^
SyntaxError: invalid syntax

>>> (a := "wtf_walrus") # 该语句有效
'wtf_walrus'
>>> a
'wtf_walrus'
2 .
# Python 版本 3.8+

>>> a = 6, 9
>>> a
(6, 9)

>>> (a := 6, 9)
(6, 9)
>>> a
6

>>> a, b = 6, 9 # 典型拆包操作
>>> a, b
(6, 9)
>>> (a, b = 16, 19) # 出错啦
  File "<stdin>", line 1
    (a, b = 16, 19)
          ^
SyntaxError: invalid syntax

>>> (a, b := 16, 19) # 这里的结果是一个奇怪的三元组
(6, 16, 19)

>>> a # a值仍然没变?
6

>>> b
16
💡 说明
“海象”运算符简介
海象运算符 (:=) 在Python 3.8中被引入,用来在表达式中为变量赋值。
def some_func():
        # 假设这儿有一些耗时的计算
        # time.sleep(1000)
        return 5

# 引入“海象”运算符前的例子
if some_func():
        print(some_func()) # 糟糕的案例——函数运算了两次

# 或者,加以改进:
a = some_func()
if a:
    print(a)

# 有了“海象”运算符,你可以写的更简洁:
if a := some_func():
        print(a)
输出 (> Python 3.8):
5
5
5
这样既减少了一行代码,又避免了两次调用 some_func 函数。
在顶层的无括号赋值操作(使用“海象”运算符)被限制,因此例1中的 a := "wtf_walrus" 出现了 SyntaxError 。用括号括起来。它就能正常工作了。
一般的,包含 = 操作的表达式是不能用括号括起来的,因此 (a, b = 6, 9) 中出现了语法错误。
“海象”运算符的语法形式为:NAME:= expr,NAME 是一个有效的标识符,而 expr 是一个有效的表达式。 因此,这意味着它不支持可迭代的打包和拆包。
(a := 6, 9) 等价于 ((a := 6), 9) ,最终得到 (a, 9) (其中 a 的值为6)
>>> (a := 6, 9) == ((a := 6), 9)
True
>>> x = (a := 696, 9)
>>> x
(696, 9)
>>> x[0] is a # 两个变量指向同一内存空间
True
类似的, (a, b := 16, 19) 等价于 (a, (b := 16), 19) ,只是一个三元组。
> Strings can be tricky sometimes/微妙的字符串 *
1.
>>> a = "some_string"
>>> id(a)
140420665652016
>>> id("some" + "_" + "string") # 注意两个的id值是相同的.
140420665652016
2.
>>> a = "wtf"
>>> b = "wtf"
>>> a is b
True

>>> a = "wtf!"
>>> b = "wtf!"
>>> a is b
False

>>> a, b = "wtf!", "wtf!"
>>> a is b
True # 3.7 版本返回结果为 False.
3.
>>> 'a' * 20 is 'aaaaaaaaaaaaaaaaaaaa'
True
>>> 'a' * 21 is 'aaaaaaaaaaaaaaaaaaaaa'
False # 3.7 版本返回结果为 True
很好理解, 对吧?
💡 说明:
这些行为是由于 Cpython 在编译优化时, 某些情况下会尝试使用已经存在的不可变对象而不是每次都创建一个新对象. (这种行为被称作字符串的驻留[string interning])
发生驻留之后, 许多变量可能指向内存中的相同字符串对象. (从而节省内存)
在上面的代码中, 字符串是隐式驻留的. 何时发生隐式驻留则取决于具体的实现. 这里有一些方法可以用来猜测字符串是否会被驻留:
所有长度为 0 和长度为 1 的字符串都被驻留.
字符串在编译时被实现 ('wtf' 将被驻留, 但是 ''.join(['w', 't', 'f']) 将不会被驻留)
字符串中只包含字母,数字或下划线时将会驻留. 所以 'wtf!' 由于包含 ! 而未被驻留. 可以在这里找到 CPython 对此规则的实现.
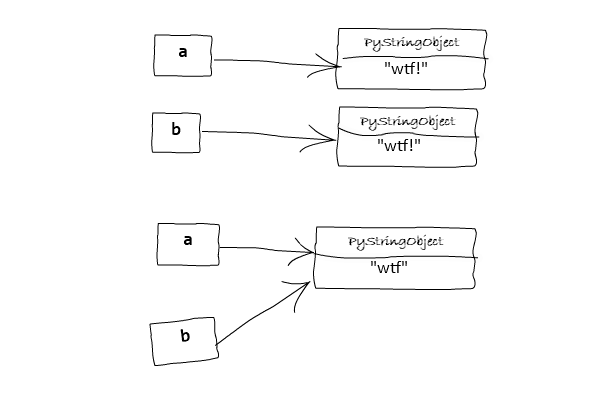
当在同一行将 a 和 b 的值设置为 "wtf!" 的时候, Python 解释器会创建一个新对象, 然后同时引用第二个变量(译: 仅适用于3.7以下, 详细情况请看这里). 如果你在不同的行上进行赋值操作, 它就不会“知道”已经有一个 wtf! 对象 (因为 "wtf!" 不是按照上面提到的方式被隐式驻留的). 它是一种编译器优化, 特别适用于交互式环境.
常量折叠(constant folding) 是 Python 中的一种 窥孔优化(peephole optimization) 技术. 这意味着在编译时表达式 'a'*20 会被替换为 'aaaaaaaaaaaaaaaaaaaa' 以减少运行时的时钟周期. 只有长度小于 20 的字符串才会发生常量折叠. (为啥? 想象一下由于表达式 'a'*10**10 而生成的 .pyc 文件的大小). 相关的源码实现在这里.
如果你是使用 3.7 版本中运行上述示例代码, 会发现部分代码的运行结果与注释说明相同. 这是因为在 3.7 版本中, 常量折叠已经从窥孔优化器迁移至新的 AST 优化器, 后者可以以更高的一致性来执行优化. (由 Eugene Toder 和 INADA Naoki 在 bpo-29469 和 bpo-11549 中贡献.)
(译: 但是在最新的 3.8 版本中, 结果又变回去了. 虽然 3.8 版本和 3.7 版本一样, 都是使用 AST 优化器. 目前不确定官方对 3.8 版本的 AST 做了什么调整.)
> Be careful with chained operations/小心链式操作
>>> (False == False) in [False] # 可以理解
False
>>> False == (False in [False]) # 可以理解
False
>>> False == False in [False] # 为毛?
True

>>> True is False == False
False
>>> False is False is False
True

>>> 1 > 0 < 1
True
>>> (1 > 0) < 1
False
>>> 1 > (0 < 1)
False
💡 说明:
根据 https://docs.python.org/3/reference/expressions.html#comparisons
形式上, 如果 a, b, c, ..., y, z 是表达式, 而 op1, op2, ..., opN 是比较运算符, 那么除了每个表达式最多只出现一次以外 a op1 b op2 c ... y opN z 就等于 a op1 b and b op2 c and ... y opN z.
虽然上面的例子似乎很愚蠢, 但是像 a == b == c 或 0 <= x <= 100 就很棒了.
> How not to use is operator/为什么不使用 is 操作符
下面是一个在互联网上非常有名的例子.
1.
>>> a = 256
>>> b = 256
>>> a is b
True

>>> a = 257
>>> b = 257
>>> a is b
False
2.
>>> a = []
>>> b = []
>>> a is b
False

>>> a = tuple()
>>> b = tuple()
>>> a is b
True
3.
Output
>>> a, b = 257, 257
>>> a is b
True
Output (Python 3.7.x specifically)
>>> a, b = 257, 257
>>> a is b
False
💡 说明:
is 和 == 的区别
256 是一个已经存在的对象, 而 257 不是
当你启动Python 的时候, 数值为 -5 到 256 的对象就已经被分配好了. 这些数字因为经常被使用, 所以会被提前准备好.
Python 通过这种创建小整数池的方式来避免小整数频繁的申请和销毁内存空间.
引用自 https://docs.python.org/3/c-api/long.html
当前的实现为-5到256之间的所有整数保留一个整数对象数组, 当你创建了一个该范围内的整数时, 你只需要返回现有对象的引用. 所以改变1的值是有可能的. 我怀疑这种行为在Python中是未定义行为. :-)
>>> id(256)
10922528
>>> a = 256
>>> b = 256
>>> id(a)
10922528
>>> id(b)
10922528
>>> id(257)
140084850247312
>>> x = 257
>>> y = 257
>>> id(x)
140084850247440
>>> id(y)
140084850247344
这里解释器并没有智能到能在执行 y = 257 时意识到我们已经创建了一个整数 257, 所以它在内存中又新建了另一个对象.
类似的优化也适用于其他不可变对象,例如空元组。由于列表是可变的,这就是为什么 [] is [] 将返回 False 而 () is () 将返回 True。 这解释了我们的第二个代码段。而第三个呢:
当 a 和 b 在同一行中使用相同的值初始化时,会指向同一个对象.
>>> a, b = 257, 257
>>> id(a)
140640774013296
>>> id(b)
140640774013296
>>> a = 257
>>> b = 257
>>> id(a)
140640774013392
>>> id(b)
140640774013488
当 a 和 b 在同一行中被设置为 257 时, Python 解释器会创建一个新对象, 然后同时引用第二个变量. 如果你在不同的行上进行, 它就不会 "知道" 已经存在一个 257 对象了.
这是一种特别为交互式环境做的编译器优化. 当你在实时解释器中输入两行的时候, 他们会单独编译, 因此也会单独进行优化. 如果你在 .py 文件中尝试这个例子, 则不会看到相同的行为, 因为文件是一次性编译的。这种优化不仅限于整数,它也适用于其他不可变数据类型,例如字符串(查看示例“微妙的字符串”)和浮点数,
>>> a, b = 257.0, 257.0
>>> a is b
True
为什么这不适用于 Python 3.7? 大概是因为此类编译器优化是特定于实现的(即可能随版本、操作系统等而变化)。我仍在试图弄清楚导致问题的具体实现更改,您可以查看此 问题 以获取更新。
> Hash brownies/是时候来点蛋糕了!
- hash brownie指一种含有大麻成分的蛋糕, 所以这里是句双关
- 这里保留原作者对于标题的翻译
1.
some_dict = {}
some_dict[5.5] = "JavaScript"
some_dict[5.0] = "Ruby"
some_dict[5] = "Python"
Output:
>>> some_dict[5.5]
"JavaScript"
>>> some_dict[5.0] # "Python" 消除了 "Ruby" 的存在?
"Python"
>>> some_dict[5]
"Python"

>>> complex_five = 5 + 0j
>>> type(complex_five)
complex
>>> some_dict[complex_five]
"Python"
为什么到处都是Python?
💡 说明
这个 StackOverflow的 回答 漂亮地解释了这背后的基本原理.
Python 字典中键的唯一性是根据 等价性,而不是同一性。 因此,即使 5、5.0 和 5 + 0j 是不同类型的不同对象,由于它们是相等的,它们不能都在同一个 dict(或 set)中。 只要您插入其中任何一个,尝试查找任何不同但等价的键都将使用原始映射值成功(而不是因“KeyError”而失败):
>>> 5 == 5.0 == 5 + 0j
True
>>> 5 is not 5.0 is not 5 + 0j
True
>>> some_dict = {}
>>> some_dict[5.0] = "Ruby"
>>> 5.0 in some_dict
True
>>> (5 in some_dict) and (5 + 0j in some_dict)
True
这在赋值的时候也会生效。因此,当您执行 some_dict[5] = "Python" 时,Python 会找到具有等价键值 5.0 -> "Ruby" 的现有项,覆盖其值,并保留原始键值。
>>> some_dict
{5.0: 'Ruby'}
>>> some_dict[5] = "Python"
>>> some_dict
{5.0: 'Python'}
那么我们如何将键值更新为5(而不是5.0)? 我们实际上不能原地更新,但是我们可以先删除键(del some_dict[5.0]),然后重新赋值(some_dict[5])得到整数5 作为键而不是浮点数 5.0,尽管这属于极少数情况。
Python 是如何在包含 5.0 的字典中找到 5 的? Python 只需要花费常数时间,而无需使用哈希函数遍历每一项。当 Python 在 dict 中查找键 foo 时,它首先计算 hash(foo)(以常数时间运行)。因为在 Python 中,要求相等的对象具有相同的哈希值(此处为文档),5 、5.0 和 5 + 0j 具有相同的哈希值。
>>> 5 == 5.0 == 5 + 0j
True
>>> hash(5) == hash(5.0) == hash(5 + 0j)
True
注意: 反之不一定正确:具有相等哈希值的对象本身可能不相等。(这是哈希冲突)造成的,这也会降低哈希运算的性能。)
> Deep down, we're all the same./本质上,我们都一样. *
class WTF:
  pass
Output:
>>> WTF() == WTF() # 两个不同的对象应该不相等
False
>>> WTF() is WTF() # 也不相同
False
>>> hash(WTF()) == hash(WTF()) # 哈希值也应该不同
True
>>> id(WTF()) == id(WTF())
True
💡 说明:
当调用 id 函数时, Python 创建了一个 WTF 类的对象并传给 id 函数. 然后 id 函数获取其id值 (也就是内存地址), 然后丢弃该对象. 该对象就被销毁了.
当我们连续两次进行这个操作时, Python会将相同的内存地址分配给第二个对象. 因为 (在CPython中) id 函数使用对象的内存地址作为对象的id值, 所以两个对象的id值是相同的.
综上, 对象的id值仅仅在对象的生命周期内唯一. 在对象被销毁之后, 或被创建之前, 其他对象可以具有相同的id值.
那为什么 is 操作的结果为 False 呢? 让我们看看这段代码.
class WTF(object):
  def __init__(self): print("I")
  def __del__(self): print("D")
Output:
>>> WTF() is WTF()
I
I
D
D
False
>>> id(WTF()) == id(WTF())
I
D
I
D
True
正如你所看到的, 对象销毁的顺序是造成所有不同之处的原因.
> Disorder within order/有序中潜藏着无序 *
from collections import OrderedDict

dictionary = dict()
dictionary[1] = 'a'; dictionary[2] = 'b';

ordered_dict = OrderedDict()
ordered_dict[1] = 'a'; ordered_dict[2] = 'b';

another_ordered_dict = OrderedDict()
another_ordered_dict[2] = 'b'; another_ordered_dict[1] = 'a';

class DictWithHash(dict):
    """
    实现了 __hash__ 魔法方法的dict类
    """
    __hash__ = lambda self: 0

class OrderedDictWithHash(OrderedDict):
    """
    实现了 __hash__ 魔法方法的OrderedDict类
    """
    __hash__ = lambda self: 0
Output
>>> dictionary == ordered_dict # 如果 a == b
True
>>> dictionary == another_ordered_dict # 且 b == c
True
>>> ordered_dict == another_ordered_dict # 那么为什么 c == a 不成立??
False

# 众所周知,set数据结构储存不重复元素,
# 让我们生成以上字典的 set 数据类型,看看会发生什么……

>>> len({dictionary, ordered_dict, another_ordered_dict})
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: unhashable type: 'dict'

# dict类没有实现 __hash__ ,出错可以理解,接下来使用我们派生的类。

>>> dictionary = DictWithHash()
>>> dictionary[1] = 'a'; dictionary[2] = 'b';
>>> ordered_dict = OrderedDictWithHash()
>>> ordered_dict[1] = 'a'; ordered_dict[2] = 'b';
>>> another_ordered_dict = OrderedDictWithHash()
>>> another_ordered_dict[2] = 'b'; another_ordered_dict[1] = 'a';
>>> len({dictionary, ordered_dict, another_ordered_dict})
1
>>> len({ordered_dict, another_ordered_dict, dictionary}) # 交换顺序
2
到底发生了什么?
💡 说明:

 《What the f*ck Python!》(wtfpython) 的中文翻译版——精选了一系列让人意外、反直觉的 Python 代码片段,每一段都配有讲解:代码会输出什么,以及背后的真实原因。