







Что это такое?
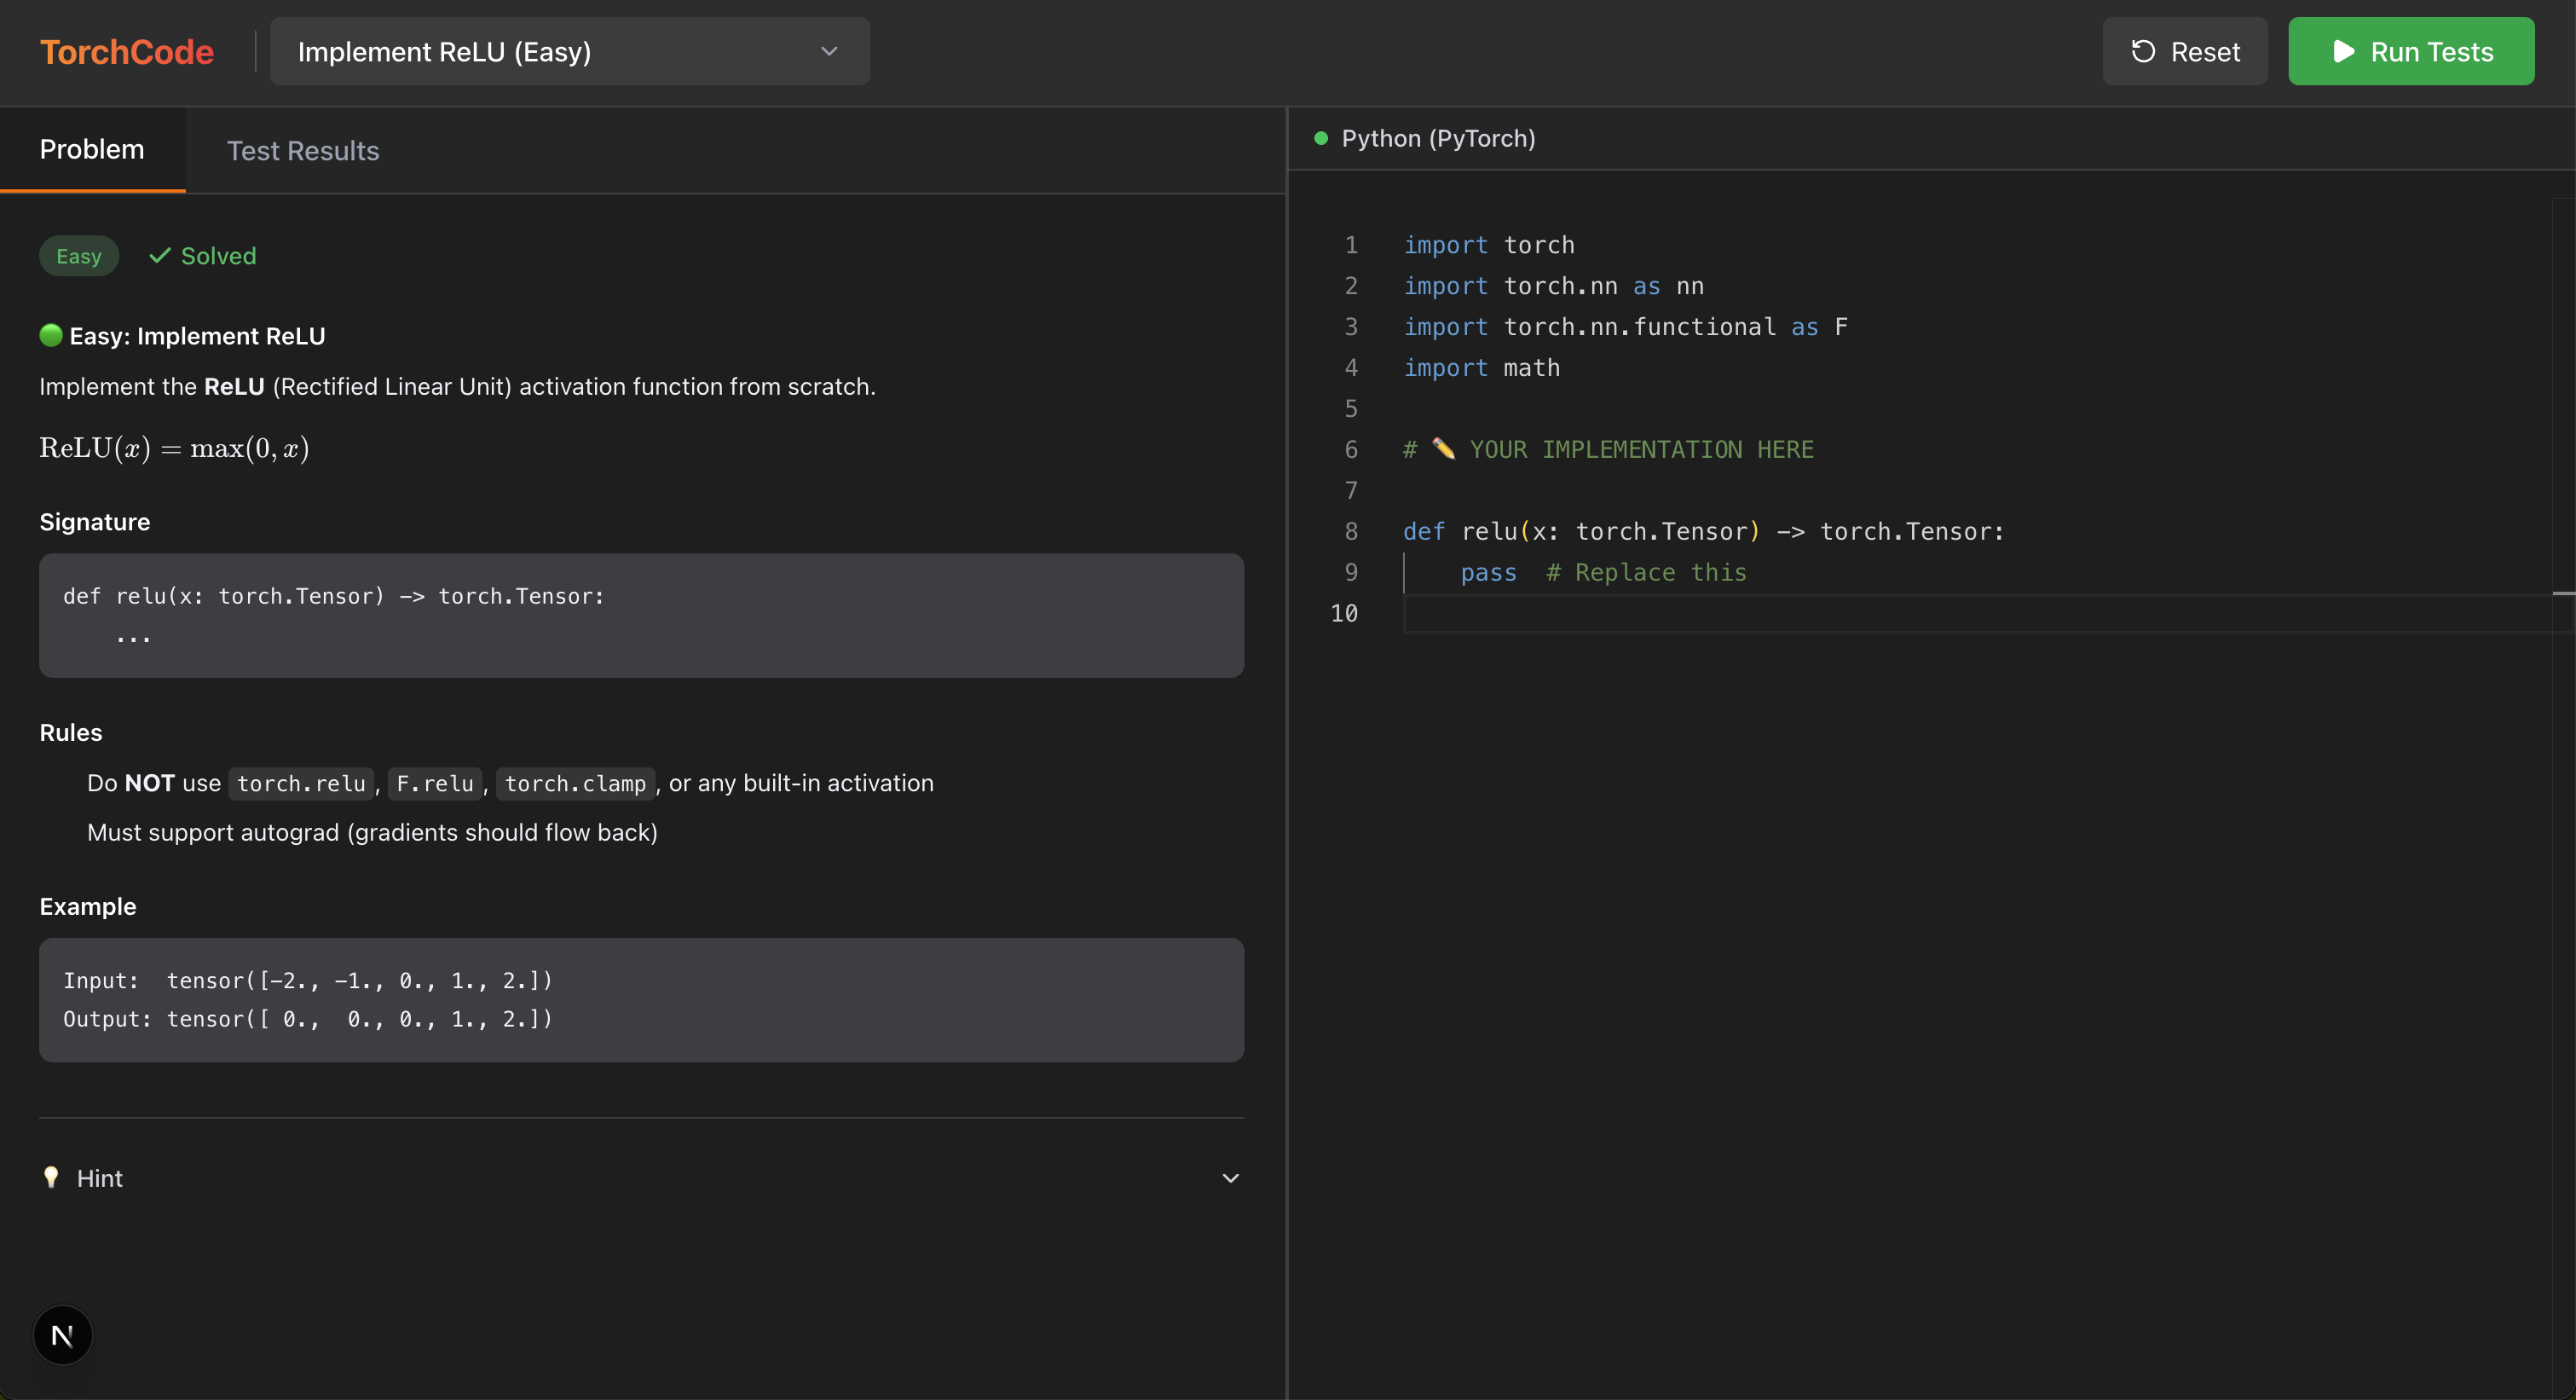
 TorchCode — платформа практики в стиле LeetCode для PyTorch: 41 отобранная задача, в которых вы с нуля реализуете ML-операторы и архитектуры (softmax, attention, блоки GPT-2 и т.д.) внутри Jupyter-ноутбуков, с автоматическим судьёй, мгновенно проверяющим корректность, градиенты и время выполнения.
Это библиотека для импорта или отдельная платформа, которую я запускаю?Это отдельное self-hosted приложение для практики кодинга на базе Jupyter-ноутбуков, а не библиотека, добавляемая в ваш проект, — вы либо запускаете его локально через Docker, либо пользуетесь через хостинговую среду JupyterLab.
Это отдельное self-hosted приложение для практики кодинга на базе Jupyter-ноутбуков, а не библиотека, добавляемая в ваш проект, — вы либо запускаете его локально через Docker, либо пользуетесь через хостинговую среду JupyterLab.Как его запустить?Проще всего запустить инстанс Hugging Face Spaces и получить полноценный JupyterLab в браузере вообще без установки, либо открыть ноутбук любой задачи прямо в Google Colab. Для самостоятельного хостинга выполните make run: он подтянет готовый Docker-образ, а при необходимости откатится к локальной сборке.
Проще всего запустить инстанс Hugging Face Spaces и получить полноценный JupyterLab в браузере вообще без установки, либо открыть ноутбук любой задачи прямо в Google Colab. Для самостоятельного хостинга выполните make run: он подтянет готовый Docker-образ, а при необходимости откатится к локальной сборке.Есть ли подводные камни установки, о которых стоит знать?Готовый Docker-образ может быть недоступен для некоторых платформ, что обычное дело на Apple Silicon / arm64, — в этом случае придётся откатиться к локальной сборке образа вместо его скачивания.
Готовый Docker-образ может быть недоступен для некоторых платформ, что обычное дело на Apple Silicon / arm64, — в этом случае придётся откатиться к локальной сборке образа вместо его скачивания.На кого он на самом деле рассчитан?Он для ML-инженеров, готовящихся к собеседованиям в топовые ИИ-лаборатории, где от них ожидают, что они по памяти реализуют базовые операции PyTorch вроде attention и слоёв нормализации.
Он для ML-инженеров, готовящихся к собеседованиям в топовые ИИ-лаборатории, где от них ожидают, что они по памяти реализуют базовые операции PyTorch вроде attention и слоёв нормализации.Сколько там задач и что они покрывают?41 отобранная задача в трёх группах: Fundamentals (ReLU, Softmax, LayerNorm, Conv2d, Linear Regression), Attention Mechanisms (Multi-Head, Causal, GQA, RoPE, Flash Attention) и Architecture & Adaptation (LoRA, ViT Patch Embedding и другие).
41 отобранная задача в трёх группах: Fundamentals (ReLU, Softmax, LayerNorm, Conv2d, Linear Regression), Attention Mechanisms (Multi-Head, Causal, GQA, RoPE, Flash Attention) и Architecture & Adaptation (LoRA, ViT Patch Embedding и другие).Он даёт подсказки, если я застрял?Да, он предлагает подсказки, которые направляют, не раскрывая полного решения, а эталонные решения становятся доступны для изучения после вашей собственной попытки.
Да, он предлагает подсказки, которые направляют, не раскрывая полного решения, а эталонные решения становятся доступны для изучения после вашей собственной попытки.Что именно проверяет автопроверка?Автоматический судья выполняет проверки корректности, верифицирует градиенты и замеряет время, выдавая цветной отклик pass/fail по каждому тесту — как судья в соревновательном программировании.
Автоматический судья выполняет проверки корректности, верифицирует градиенты и замеряет время, выдавая цветной отклик pass/fail по каждому тесту — как судья в соревновательном программировании.Можно ли перезапустить задачу, если я всё испортил?Да, в каждом ноутбуке на панели инструментов есть кнопка сброса в один клик, возвращающая задачу к чистому шаблону, чтобы практиковаться столько раз, сколько хотите.
Да, в каждом ноутбуке на панели инструментов есть кнопка сброса в один клик, возвращающая задачу к чистому шаблону, чтобы практиковаться столько раз, сколько хотите.What are similar projects?LLMs-from-scratch, DeepLearning, llama3-from-scratch, autumn-recruitment, nn-zero-to-hero, manga-image-translator, happy-llm, apachecn-algo-zh
LLMs-from-scratch, DeepLearning, llama3-from-scratch, autumn-recruitment, nn-zero-to-hero, manga-image-translator, happy-llm, apachecn-algo-zhWhich topics is it in?coding-interview, leetcode, attention-mechanism, lora, interview, interview-preparation, neural-network, jupyter notebook, transformer, docker-compose, pytorch, learning
coding-interview, leetcode, attention-mechanism, lora, interview, interview-preparation, neural-network, jupyter notebook, transformer, docker-compose, pytorch, learning