

Что это?
 NativePDF Structurer конвертирует большие цифровые PDF — руководства по оборудованию, инструкции по ремонту, технические каталоги — в структурированный Markdown, изображения и CSV таблиц без OCR и каких-либо ML-моделей, чтобы длинные документы вендоров можно было надёжно подавать в RAG-пайплайны.
Это инструмент командной строки или Python-библиотека?И то, и другое — он предоставляет точку входа CLI и Python API, поэтому может использоваться автономно или как слой структуризации, питающий последующий RAG- или мультимодальный пайплайн.
И то, и другое — он предоставляет точку входа CLI и Python API, поэтому может использоваться автономно или как слой структуризации, питающий последующий RAG- или мультимодальный пайплайн.От чего он зависит под капотом?Он опирается на PyMuPDF для нативного доступа к тексту/изображениям/векторам/таблицам, NumPy для геометрии и массивов масок, OpenCV headless для морфологии и Pillow для вывода изображений — и прямо предупреждает не устанавливать вместе с ним обычный (не headless) пакет OpenCV.
Он опирается на PyMuPDF для нативного доступа к тексту/изображениям/векторам/таблицам, NumPy для геометрии и массивов масок, OpenCV headless для морфологии и Pillow для вывода изображений — и прямо предупреждает не устанавливать вместе с ним обычный (не headless) пакет OpenCV.Работает ли он со сканированными PDF или восстанавливает сложные математические формулы?Нет — он нацелен только на цифровые PDF с читаемым текстовым слоем; сканированные PDF, текст, зависящий от OCR, и задачи, требующие семантического понимания изображений/устройств, явно вне области применения, а сложные формулы сохраняются как отрендеренные PNG, а не гарантированный LaTeX.
Нет — он нацелен только на цифровые PDF с читаемым текстовым слоем; сканированные PDF, текст, зависящий от OCR, и задачи, требующие семантического понимания изображений/устройств, явно вне области применения, а сложные формулы сохраняются как отрендеренные PNG, а не гарантированный LaTeX.Для каких PDF он создан?Техническая документация вендоров — руководства по эксплуатации оборудования, инструкции по ремонту, инструкции по монтажу, каталоги подбора продукции, электротехнические руководства и технические каталоги — а не научные статьи, которые считаются вторичным, неоптимизированным случаем.
Техническая документация вендоров — руководства по эксплуатации оборудования, инструкции по ремонту, инструкции по монтажу, каталоги подбора продукции, электротехнические руководства и технические каталоги — а не научные статьи, которые считаются вторичным, неоптимизированным случаем.Почему не использовать OCR или vision-language модель, как это делает MinerU?Он остаётся детерминированным и проверяемым, опираясь только на имеющийся в PDF текстовый слой, шрифты, координаты и векторные пути, а не угадывая семантику страницы; для коротких статей, которым действительно нужны OCR, восстановление формул или понимание изображений, он рекомендует инструменты вроде MinerU.
Он остаётся детерминированным и проверяемым, опираясь только на имеющийся в PDF текстовый слой, шрифты, координаты и векторные пути, а не угадывая семантику страницы; для коротких статей, которым действительно нужны OCR, восстановление формул или понимание изображений, он рекомендует инструменты вроде MinerU.Что именно содержит вывод?Минимальный режим выдаёт файл Markdown плюс изображения и CSV таблиц, на которые он ссылается; отладочный режим дополнительно отдаёт documentir.json, Claim JSON для каждой страницы/таблицы/изображения/визуального региона, отчёты по колонтитулам и заголовкам, а также диагностические изображения порядка чтения.
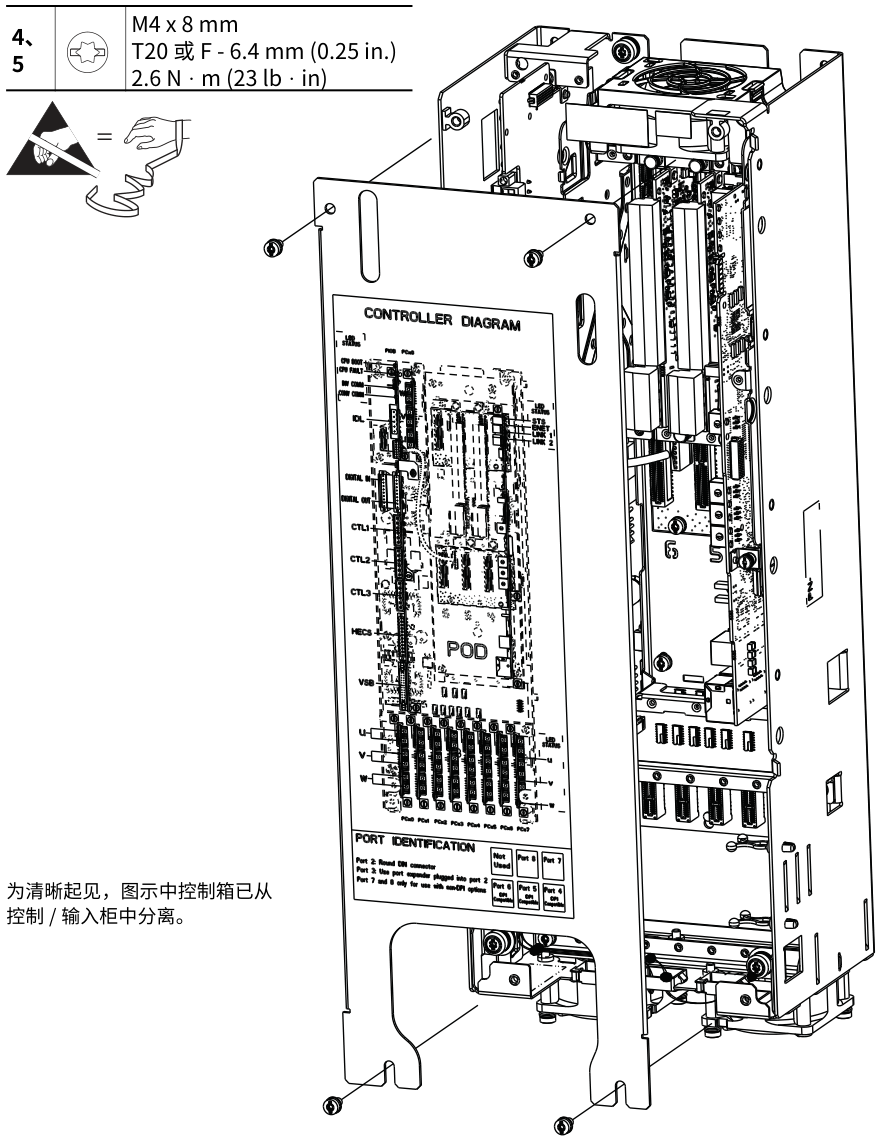
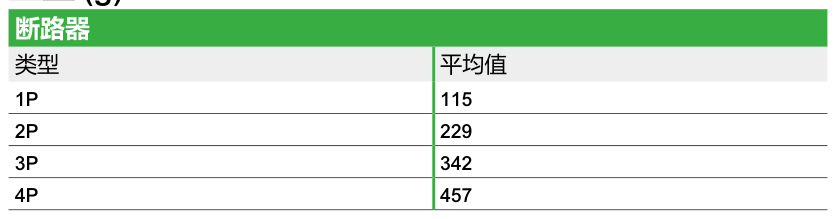
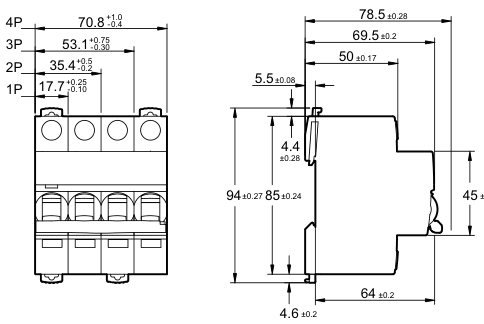
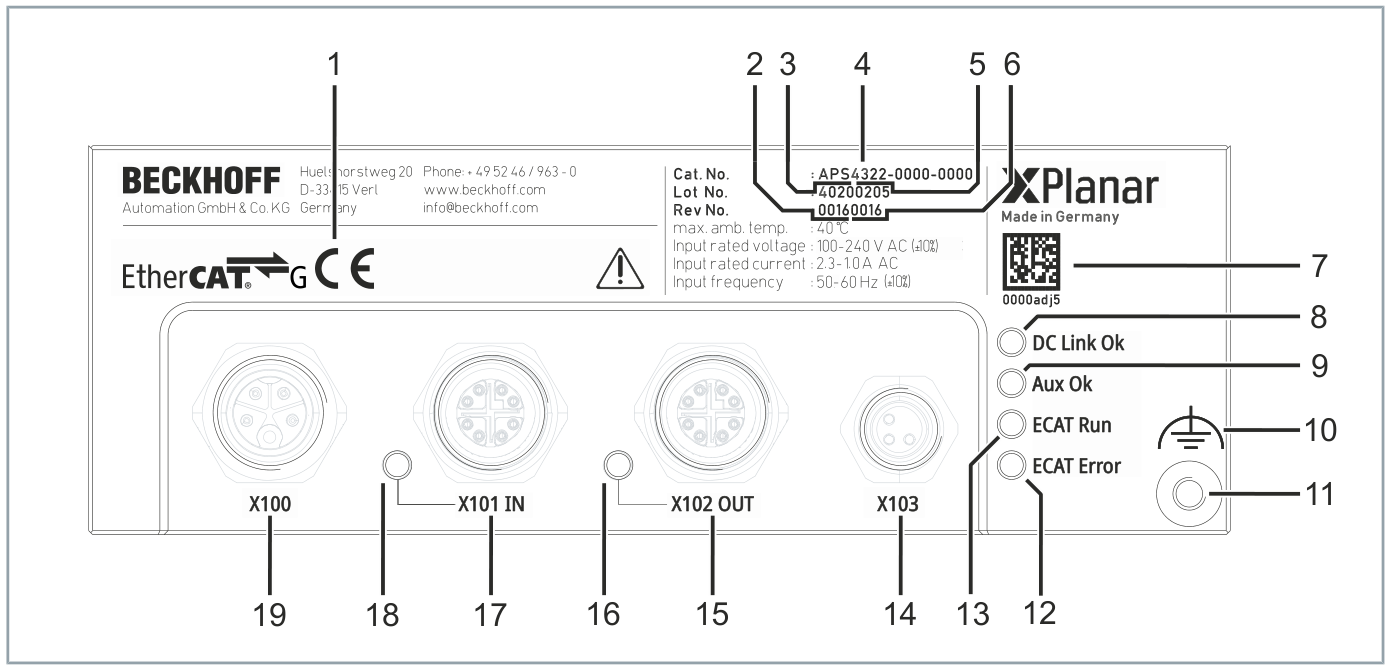
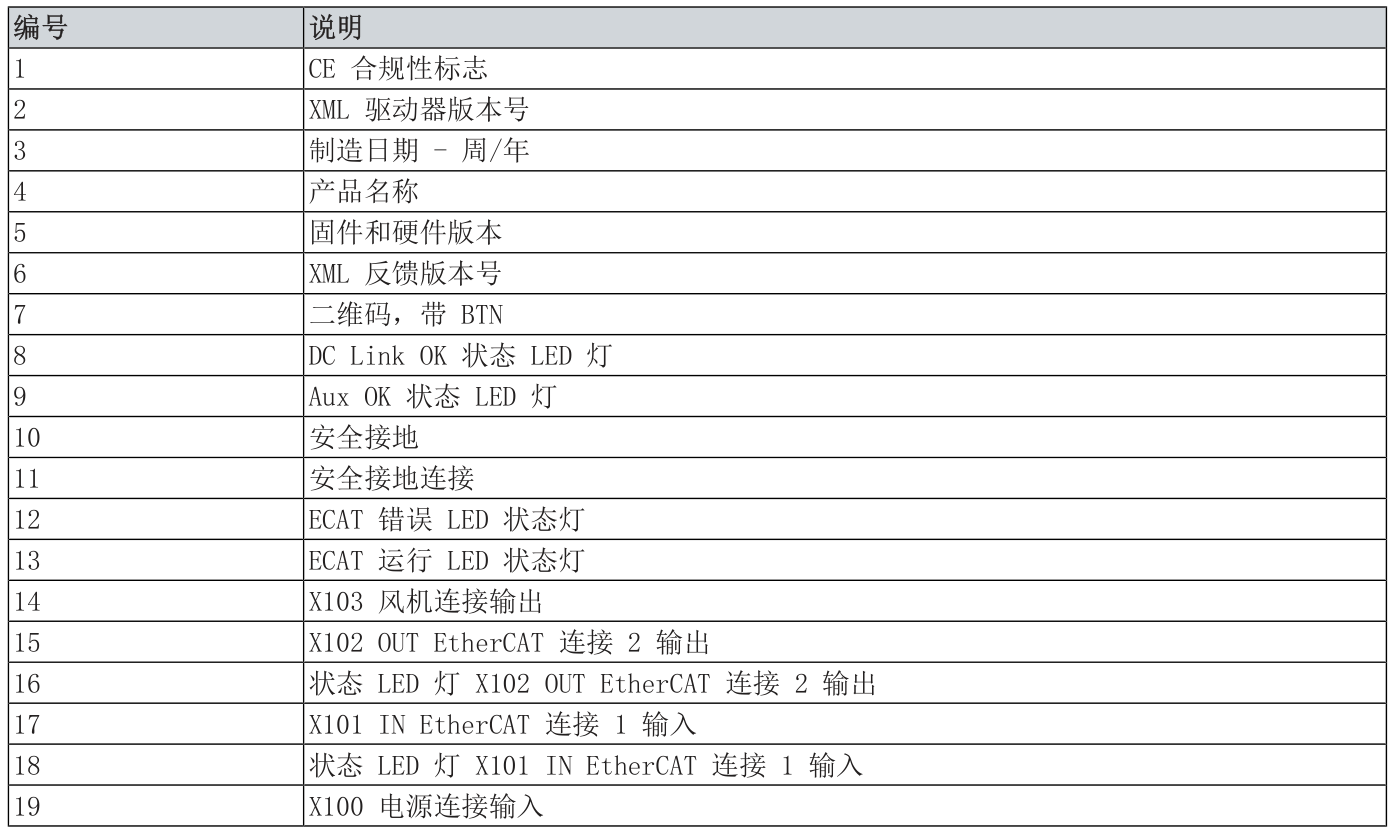
Минимальный режим выдаёт файл Markdown плюс изображения и CSV таблиц, на которые он ссылается; отладочный режим дополнительно отдаёт documentir.json, Claim JSON для каждой страницы/таблицы/изображения/визуального региона, отчёты по колонтитулам и заголовкам, а также диагностические изображения порядка чтения.Как он удерживает пронумерованные схемы вместе с их пояснительными таблицами?Стабильные ID примитивов отслеживают таблицы, изображения и векторные регионы для прослеживаемости происхождения, а реконструкция порядка чтения удерживает схему с нумерованными выносками связанной с пояснительной таблицей, следующей за ней, вместо того чтобы раскидывать их вразнобой.
Стабильные ID примитивов отслеживают таблицы, изображения и векторные регионы для прослеживаемости происхождения, а реконструкция порядка чтения удерживает схему с нумерованными выносками связанной с пояснительной таблицей, следующей за ней, вместо того чтобы раскидывать их вразнобой.Справляется ли он с повёрнутым текстом или многоколоночными макетами руководств?Да, его реконструкция порядка чтения явно поддерживает повёрнутый текст, многоколоночные страницы и узкие колонки нумерации, обычные для руководств вендоров.
Да, его реконструкция порядка чтения явно поддерживает повёрнутый текст, многоколоночные страницы и узкие колонки нумерации, обычные для руководств вендоров.What are similar projects?pdfplumber, pdfcraft, pypdf, liteparse, ParseBench, docling, PyMuPDF, chandra
pdfplumber, pdfcraft, pypdf, liteparse, ParseBench, docling, PyMuPDF, chandraWhich topics is it in?pdf-processing, table-extraction, pdf-tools, parser, python3, document-processing, pdf, rag, markdown, tool, apache-2.0, library
pdf-processing, table-extraction, pdf-tools, parser, python3, document-processing, pdf, rag, markdown, tool, apache-2.0, library