


Что это такое?
 DeepEval — это open-source фреймворк для оценки LLM: простой способ проверять системы на основе больших языковых моделей по метрикам, обоснованным исследованиями, — например G-Eval, релевантность ответа и проверка на галлюцинации.
Чем это отличается от обычного pytest?Он повторяет стиль юнит-тестирования pytest, но создан специально для LLM-приложений: тест-кейсы — это Python-объекты, объединяющие входные данные, выходные данные и метрики оценки, а не обычные generic-проверки через assert, и запускаются они через собственный CLI DeepEval.
Он повторяет стиль юнит-тестирования pytest, но создан специально для LLM-приложений: тест-кейсы — это Python-объекты, объединяющие входные данные, выходные данные и метрики оценки, а не обычные generic-проверки через assert, и запускаются они через собственный CLI DeepEval.Как начать тестировать своё приложение?Установите пакет через pip (нужен Python 3.9+), напишите тестовый файл с входными данными, actual_output вашего приложения и метрикой вроде GEval с пороговым значением, затем выполните в CLI команду 'deepeval test run'. Оценки варьируются от 0 до 1, и именно порог решает, прошёл тест или нет.
Установите пакет через pip (нужен Python 3.9+), напишите тестовый файл с входными данными, actual_output вашего приложения и метрикой вроде GEval с пороговым значением, затем выполните в CLI команду 'deepeval test run'. Оценки варьируются от 0 до 1, и именно порог решает, прошёл тест или нет.Нужен ли мне API-ключ OpenAI, чтобы запускать оценки?В quickstart задаётся переменная окружения OPENAI_API_KEY, но вы не привязаны к OpenAI: метрики может поддерживать любая выбранная вами LLM или NLP-модели, работающие локально, а оценивать можно и собственной кастомной моделью.
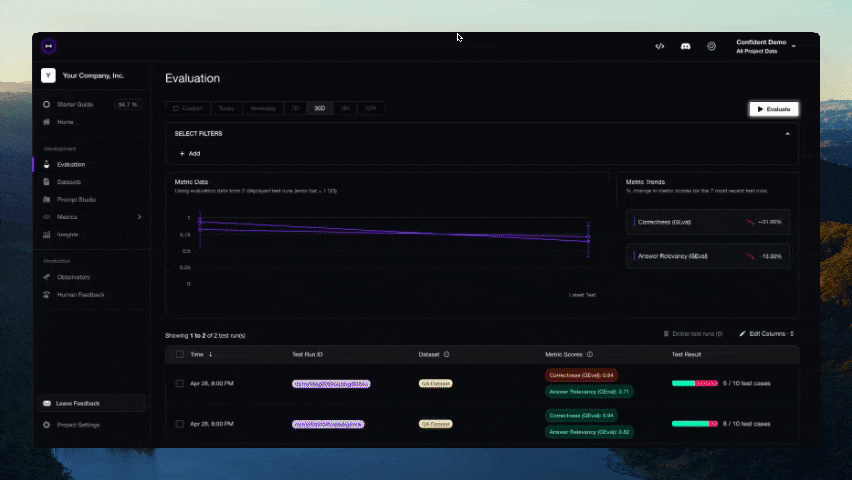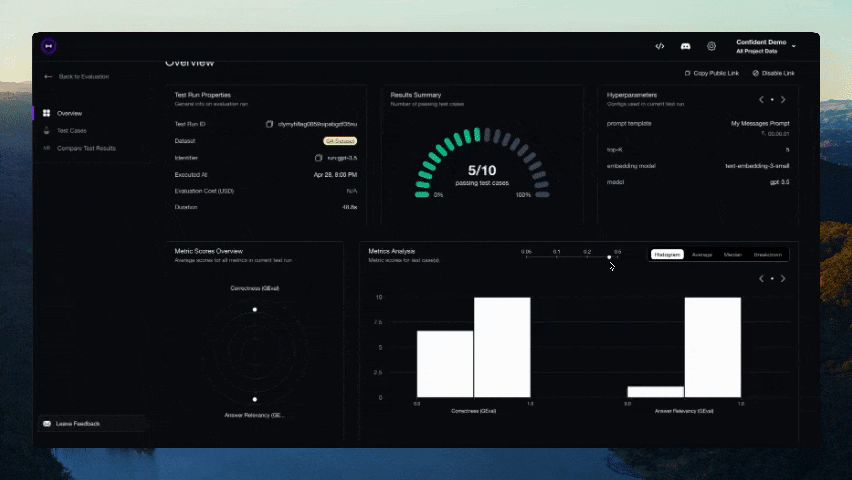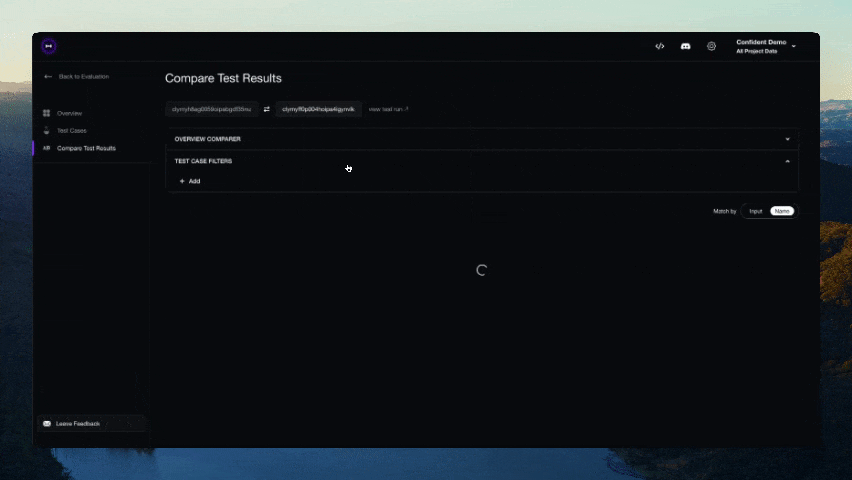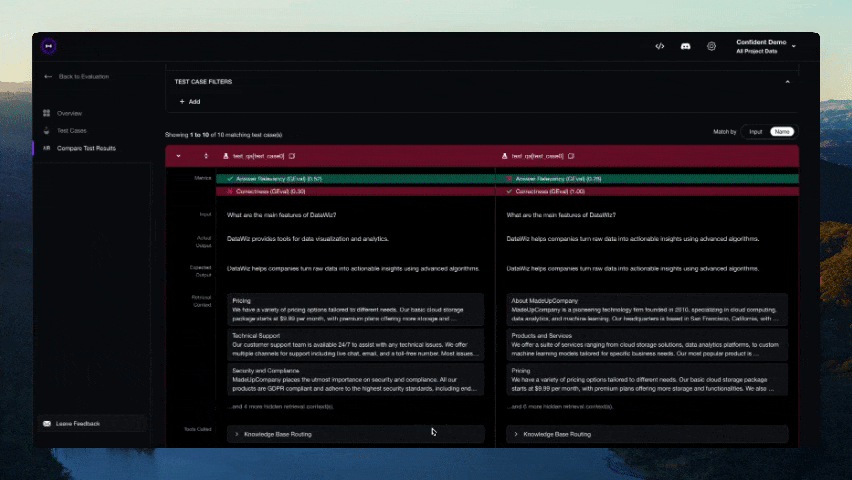
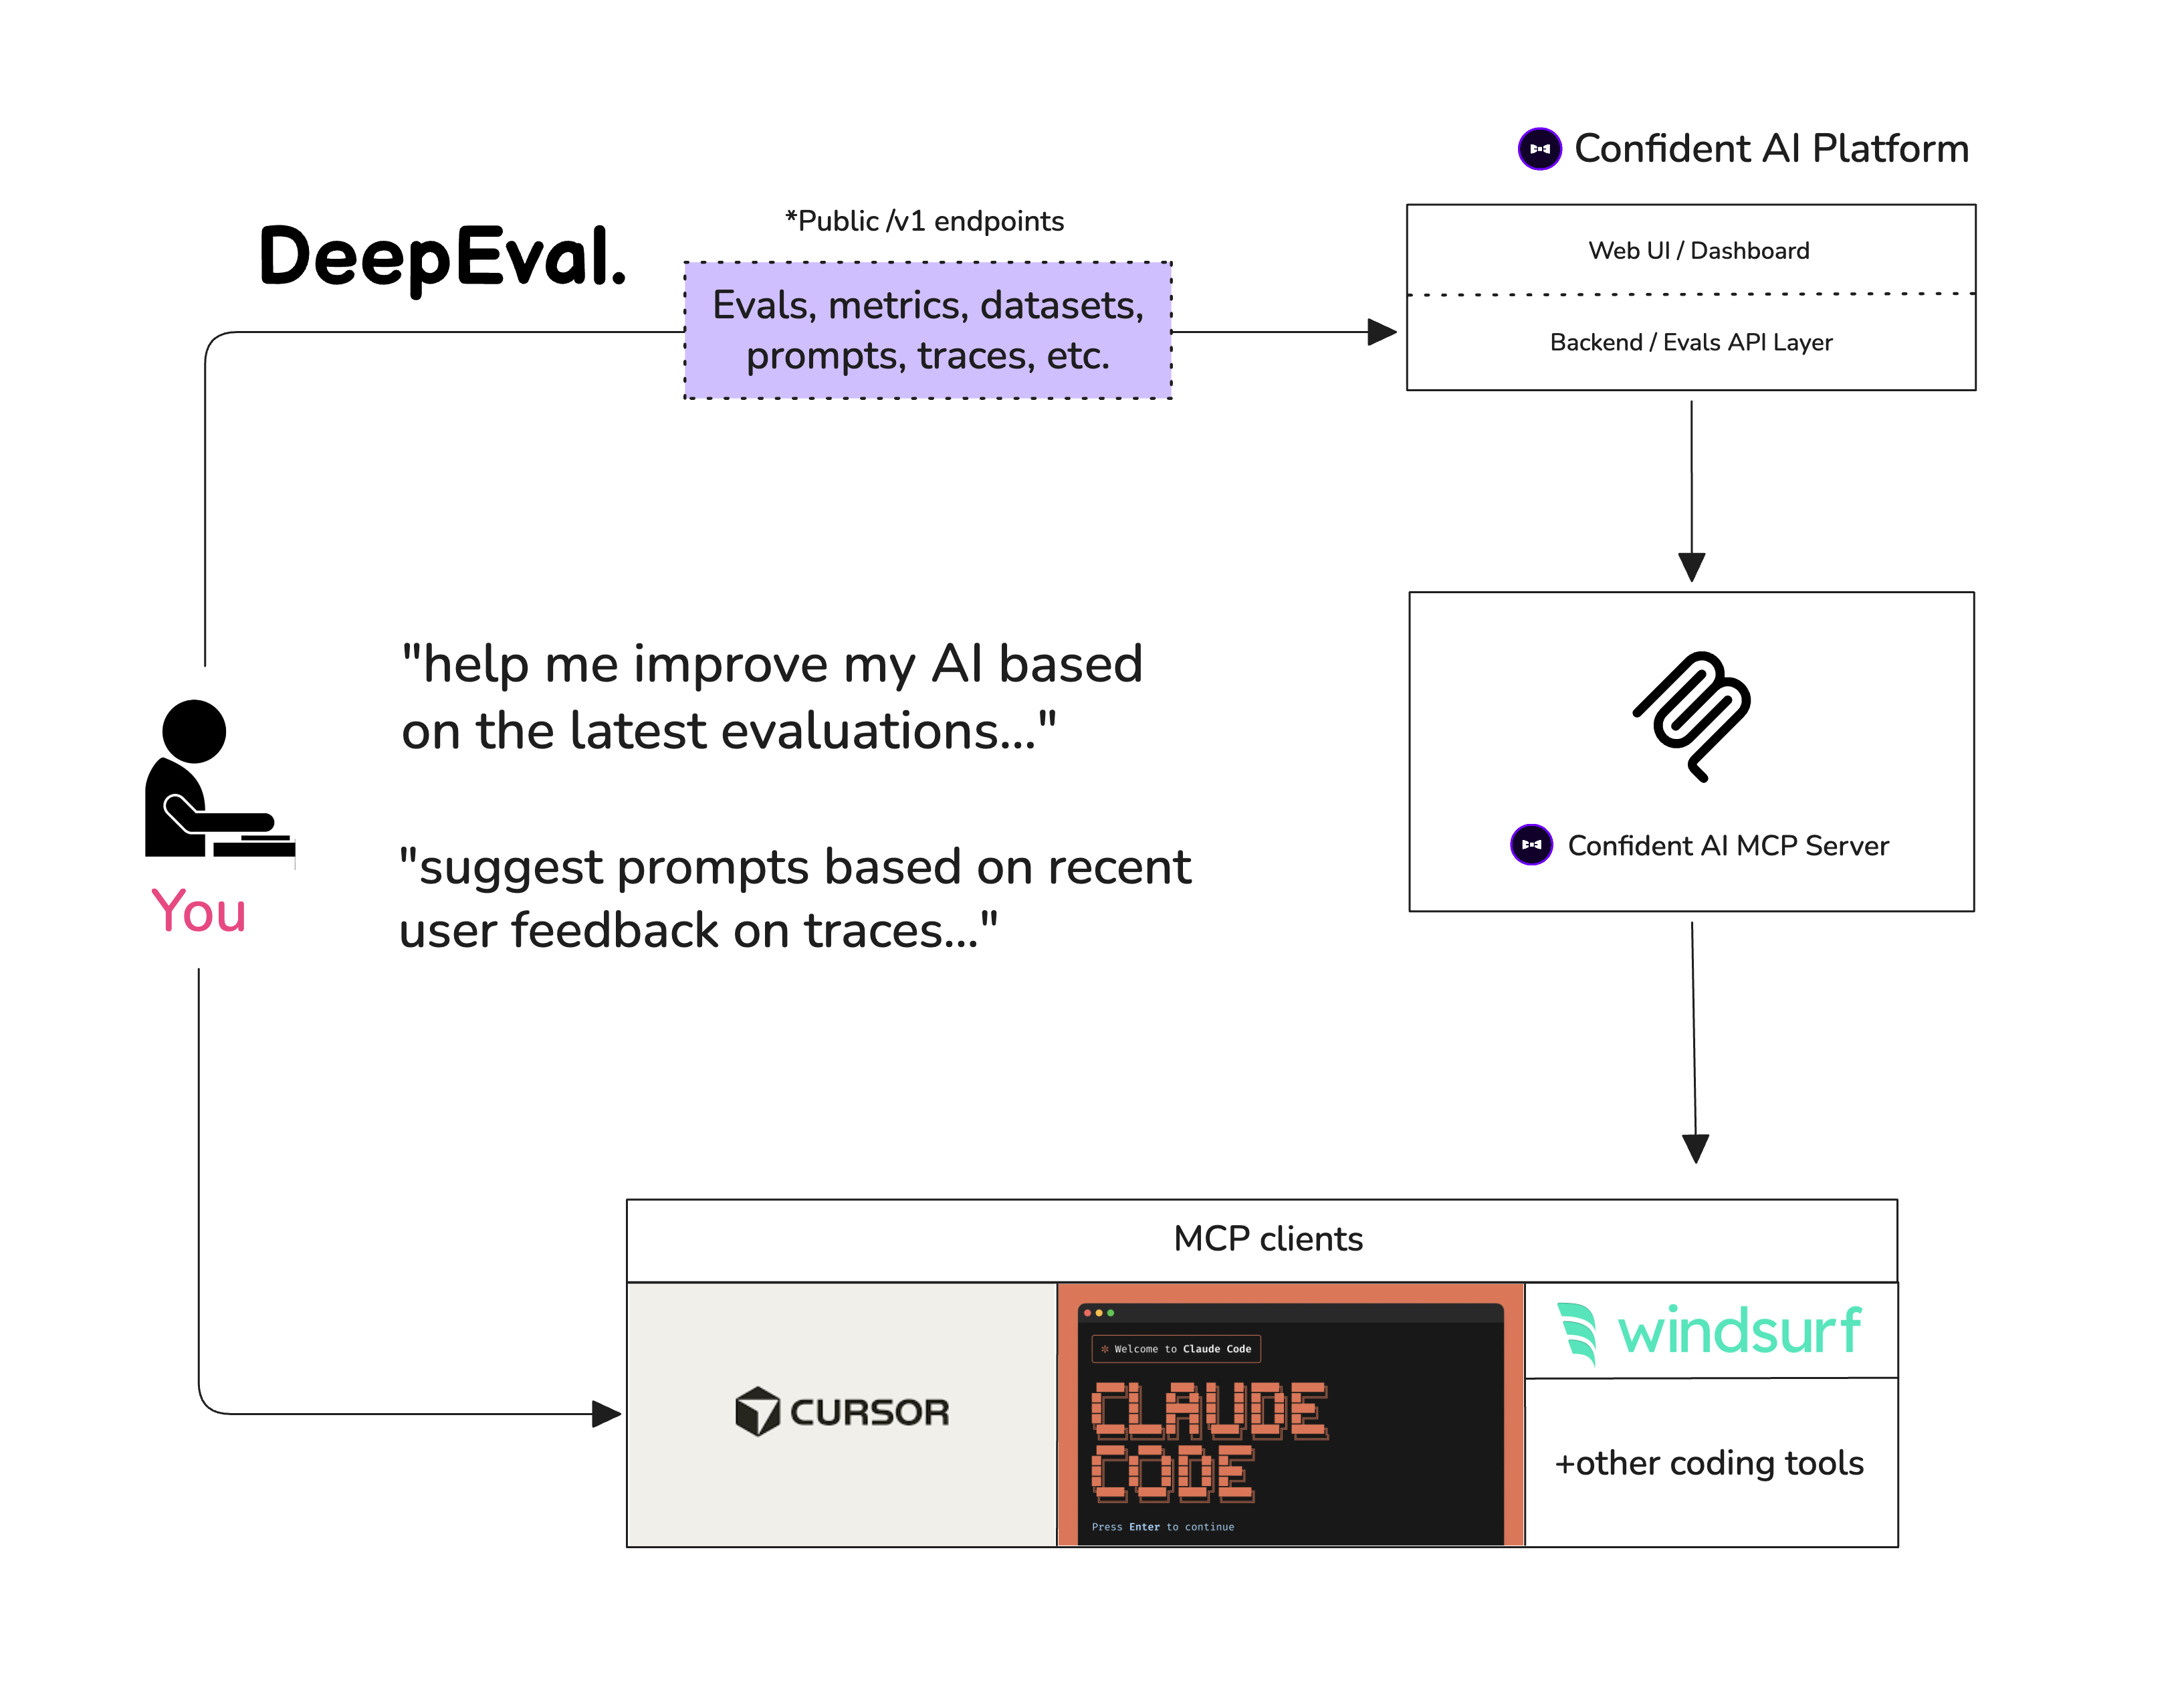
В quickstart задаётся переменная окружения OPENAI_API_KEY, но вы не привязаны к OpenAI: метрики может поддерживать любая выбранная вами LLM или NLP-модели, работающие локально, а оценивать можно и собственной кастомной моделью.Обязательно ли регистрироваться в облаке Confident AI?Нет — фреймворк open-source и полностью работает локально сам по себе. Платформа Confident AI — это необязательная бесплатная регистрация, которая добавляет к вашим запускам доступные для шаринга облачные отчёты о тестировании.
Нет — фреймворк open-source и полностью работает локально сам по себе. Платформа Confident AI — это необязательная бесплатная регистрация, которая добавляет к вашим запускам доступные для шаринга облачные отчёты о тестировании.Для кого это сделано — агенты, RAG-приложения, чат-боты?Для разработчиков AI-агентов, RAG-пайплайнов и чат-ботов — приложение можно оценивать целиком как чёрный ящик или на уровне отдельных компонентов, вплоть до шагов агента вроде вызовов инструментов, поиска (retrieval) и передачи задач суб-агентам.
Для разработчиков AI-агентов, RAG-пайплайнов и чат-ботов — приложение можно оценивать целиком как чёрный ящик или на уровне отдельных компонентов, вплоть до шагов агента вроде вызовов инструментов, поиска (retrieval) и передачи задач суб-агентам.Работает ли это на Windows, или только на Mac и Linux?Это Python-пакет с CLI, устанавливаемый через pip, поэтому он работает везде, где есть Python 3.9+, — на Windows, macOS и Linux.
Это Python-пакет с CLI, устанавливаемый через pip, поэтому он работает везде, где есть Python 3.9+, — на Windows, macOS и Linux.Он отправляет мои тестовые данные куда-то?Только если вы сами это включите: после входа в платформу Confident AI все ваши тест-кейсы автоматически логируются в облако, а защита данных описана в отдельной документации.
Только если вы сами это включите: после входа в платформу Confident AI все ваши тест-кейсы автоматически логируются в облако, а защита данных описана в отдельной документации.Может ли он сам генерировать датасеты для оценки?Да — он умеет генерировать синтетические датасеты как с однораундовыми, так и с многораундовыми диалогами, так что каждый тестовый ввод не придётся писать вручную.
Да — он умеет генерировать синтетические датасеты как с однораундовыми, так и с многораундовыми диалогами, так что каждый тестовый ввод не придётся писать вручную.Что такое G-Eval?Это метрика в подходе LLM-as-a-judge, подтверждённая исследованиями: она оценивает выходные данные по любым заданным вами критериям с точностью, близкой к человеческой, — в quickstart её используют для проверки ответа на соответствие ожидаемому.
Это метрика в подходе LLM-as-a-judge, подтверждённая исследованиями: она оценивает выходные данные по любым заданным вами критериям с точностью, близкой к человеческой, — в quickstart её используют для проверки ответа на соответствие ожидаемому.Может ли он бенчмаркить «сырые» LLM, а не только моё приложение?Да — он может прогонять любую LLM по популярным бенчмаркам вроде MMLU, HellaSwag, DROP, BIG-Bench Hard, TruthfulQA, HumanEval и GSM8K менее чем в 10 строках кода.
Да — он может прогонять любую LLM по популярным бенчмаркам вроде MMLU, HellaSwag, DROP, BIG-Bench Hard, TruthfulQA, HumanEval и GSM8K менее чем в 10 строках кода.Он помогает улучшать моё приложение или только оценивает?Он автоматически оптимизирует промпты на основе результатов оценки, так что помимо вердиктов «прошёл/не прошёл» он помогает вам итерациями добиваться более качественных ответов.
Он автоматически оптимизирует промпты на основе результатов оценки, так что помимо вердиктов «прошёл/не прошёл» он помогает вам итерациями добиваться более качественных ответов.What are similar projects?promptfoo, jevals, mlflow, ragas, opik, phoenix, ParseBench, nautilus-compass
promptfoo, jevals, mlflow, ragas, opik, phoenix, ParseBench, nautilus-compassWhich topics is it in?evaluation-framework, llmops, llm-evaluation, unit-testing, ci-cd, langchain, multimodal, chatbot, rag, testing, anthropic, agents
evaluation-framework, llmops, llm-evaluation, unit-testing, ci-cd, langchain, multimodal, chatbot, rag, testing, anthropic, agents