huashu-chrome
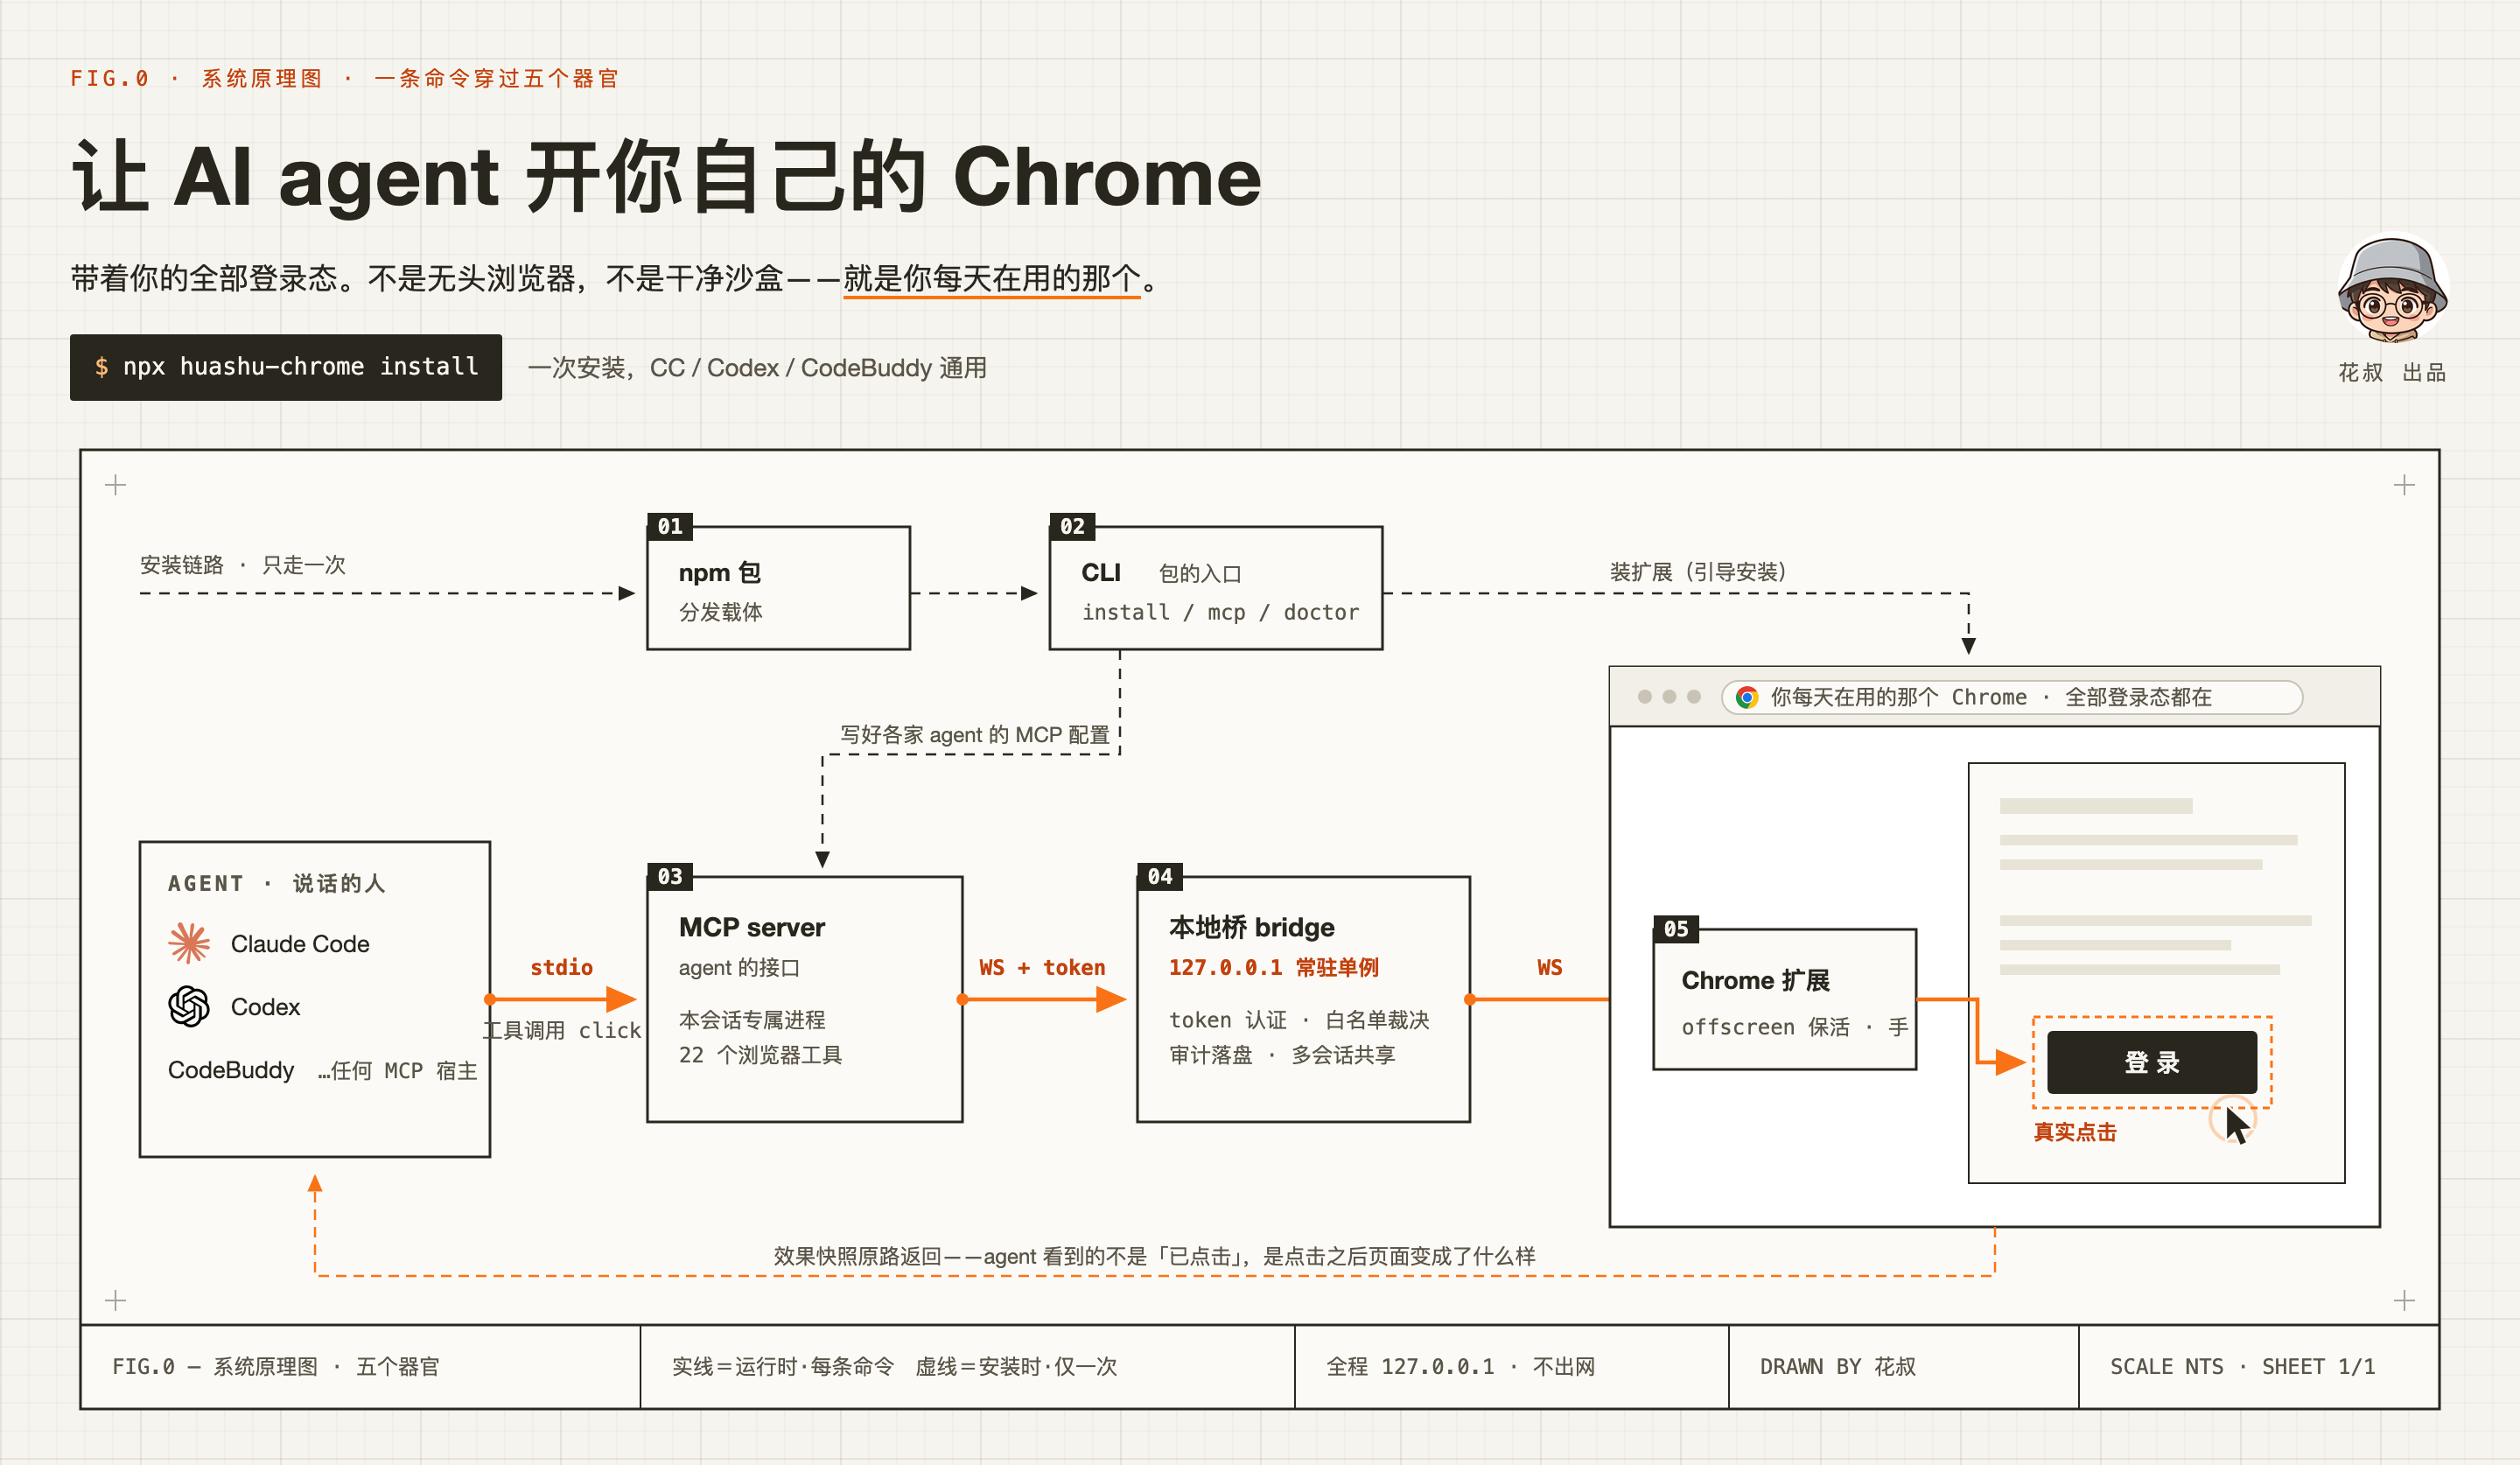
「工具返回『已点击』不算数,页面真的动了才算。」


让任何 AI agent 操控你自己的 Chrome——带着你全部的登录态。
一个 MCP server + 一个 Chrome 扩展,22 个浏览器工具。Claude Code、Codex CLI、Cursor、Gemini CLI、Cline、Windsurf 通用。
看效果 · 安装 · 22 个工具 · 经验回流 · 安全 · 排错
你:帮我把这份 CSV 里的 30 条客户信息录进 CRM
agent:(打开你已登录的 CRM,逐条填表提交)
不用 API key,不用重新登录,不用处理验证码——用的就是你此刻这个浏览器里的身份。
「npm 包?插件?CLI?还是 MCP?」——都是。它们是同一个产品的五个器官:npm 包是分发载体,
CLI 是入口(install / mcp / doctor),MCP server 是 agent 的接口,本地桥是 127.0.0.1 上的
常驻路由器,Chrome 扩展是手。上图就是一条命令穿过它们的全程。
图解版完整说明书 → huasheng.ai/huashu-chrome
看效果
装上之后,你在 agent 里说的是这种话:
「查一下这本书在京东有几家在卖,评价怎么样」
「把这篇稿子发到小红书,配这 9 张图,明早 7:30 定时发」
「这个 B 站 UP 主最近 30 条视频的播放和字幕全拉下来」
「明天武汉到上海的高铁还有没有二等座,顺便告诉我票价」
「把这份表格里的记录加进飞书多维表格」
下面每一行都是真跑通过的,右边那列点进去就是它的实测笔记——包括踩过的坑和被推翻的结论:
| 干什么 |
难点在哪 |
笔记 |
| 拉一批 B 站视频的 AI 字幕 |
官方那个看起来最对的端点会静默返回别的视频的字幕(返回码 200、bvid 回显都对)。换端点 + 一道 cid 校验闸之后,一轮 140 条过 137 组,零误配 |
bilibili.com |
| 发一条小红书图文,带话题和定时 |
发布按钮在封闭 shadow DOM 里,DOM 搜不到「发布」两个字,点坐标也没用 |
xiaohongshu.com |
| 查 12306 余票和票价 |
不用登录,但必须在浏览器里发(要 cookie)。票价是另一个接口,余票接口里没有 |
12306.cn |
| 查京东某个商品的销量口径 |
京东全站没有「累计销量」字段,只有评价数——别把评价数当销量报 |
jd.com |
| 往飞书多维表格加记录 |
网格是 canvas,DOM 里根本没有行。第一次从零摸索花了 281 次调用 / 54 分钟,照笔记走 10 轮以内 |
feishu.cn |
| 采集 X 的搜索结果 |
请求签名造不出来(一律 403),只能驱动页面自己发;而且后台标签页里 React 完全不渲染 |
x.com |
| 读一篇 ResearchGate 上 403 的论文 |
走 Google 学术自己的 HTML 缓存 |
scholar.google.com |
| 完成已授权的App Store提审 |
上传成功、可供审核、等待审核是不同阶段;内购要与版本同批,提交超时先查回执再决定是否重试 |
appstoreconnect.apple.com |
| 补齐新iCloud功能的生产数据结构 |
开发环境只有Users且零差异,可能是模型根本没初始化;生成schema、部署并读回Production字段 |
icloud.developer.apple.com |
| 在 Chrome 应用商店后台改文案 |
❌ 做不到:商店页是浏览器保护页,任何扩展都注入不了。笔记里写清了这堵墙长什么样、报错认哪一句 |
chrome.google.com |
最后一行是故意留的。能干什么和干不了什么同样重要——出厂经验里有好几条是负面结论,
省下的是 agent 在墙上撞十几个回合的时间。
为什么需要它
浏览器控制这件事,现在的格局是:能拿到你真实登录态的,多半只给自家客户端用;
对任何 agent 开放的,多半开的是一个干净的、没登录的浏览器。huashu-chrome 两头都要。
|
huashu-chrome |
Claude in Chrome |
ChatGPT 扩展(Codex) |
Playwright MCP |
chrome-devtools-mcp |
Browser Use |
| 用你日常的 Chrome,带真实登录态 |
✅ 就是眼前这个 |
✅ |
✅ |
⚠️ 要走扩展模式 |
⚠️ Chrome 144+ 逐次授权 |
⚠️ Harness 接管才行 |
| 任何支持 MCP 的 agent 都能接 |
✅ 20+ 家通用 |
❌ 只限 Anthropic 客户端 |
❌ Codex CLI 用不了 |
✅ |
✅ |
✅ |
| 不改启动参数、不开调试端口 |
✅ 装个扩展就行 |
✅ |
✅ |
⚠️ 扩展模式才免 |
❌ 要开远程调试 |
❌ 装 Chromium 或开远程调试 |
| 多个 agent 同时干活互不抢页 |
✅ 每会话一槽,撞车当场拦 |
⚠️ 每会话一标签组 |
?官方未说明 |
✅ 每客户端一标签组 |
⚠️ 靠实验开关 |
⚠️ 共用一条道会抢 |
| 出厂带站点经验,越用越快 |
✅ 二十多站实测笔记+本机回流 |
❌ |
⚠️ 只有通用记忆 |
❌ |
❌ |
⚠️ 有,默认关闭 |
| 验证码、扫码、付款交还给人 |
✅ ask 工具,付款闸在扩展里 |
✅ 遇到就暂停 |
⚠️ 只确认敏感动作 |
❌ |
❌ |
⚠️ 云端版才有 |
| 看得见谁在控哪一页 |
✅ 标签组+描边+驾驶舱 |
✅ 彩色标签组 |
?官方未说明 |
⚠️ 按客户端命名标签组 |
❌ |
⚠️ 标题加个标记 |
核查日期 2026-09-09,每一格都对着官方文档或官方仓库填的,完整八方案矩阵和每格来源见
docs/对比.md。两句公道话:Playwright MCP 的扩展模式也能拿到登录态、
也有按客户端隔离,它缺的是站点经验和人工交接;Claude in Chrome 遇到验证码也会停下等你,
它的问题是只给 Anthropic 自家客户端用。
安装
npx huashu-chrome install
一条命令:自动检测这台机器上装了哪些 agent、写好各自的 MCP 配置(动手前先备份,
已配过的自动跳过;只想看不想写加 --dry-run),然后弹出引导页带你装扩展——
装扩展这一下必须你自己点,浏览器不允许脚本代劳。
它认得出哪些 agent,分三层:
- 已知表 ——
src/agents.json 列了 20 个:Claude Code、Codex CLI、Cursor、
Gemini CLI、Windsurf、Cline、Roo Code、Claude Desktop,以及 WorkBuddy、CodeBuddy、
Kimi Code、通义灵码、MiniMax Mavis、Trae、豆包、千问 / Qwen Code、Qoder、
DeepSeek、iFlow、OpenClaw。加一个只要往数组里加一行,不用改代码 —— 欢迎 PR。
不只是编程 agent:WorkBuddy、千问办公、豆包工作这类办公 agent,只要能配本地 MCP,
同样接得上——它们最常干的「查后台数据、填表、跨站搬运」正是登录态最要紧的活。
- 自动发现 —— 没列出来的也能认出来。
install 会扫 home 下的点目录,
凡是内容里有 mcpServers 的配置文件都算数。实测所有主流产品都守这个惯例
(Codex 的 TOML 是唯一异类),所以下个月新冒出来的 agent 不用等更新也能配上。
- 都不匹配 —— 打印该填的 JSON,你自己贴。
Windows / macOS / Linux 的配置路径都已适配。装完验证:
npx huashu-chrome doctor
看到「握手正常 · Chrome 扩展在线」就成了。桥进程由 agent 首次调用时自动拉起
(doctor 发现桥没跑也会先拉一个再探),你不用手动开任何东西。
手动配置(不想让 install 碰你的配置文件)
Claude Code
claude mcp add huashu-chrome -- npx -y huashu-chrome mcp --client claude-code
Codex CLI — ~/.codex/config.toml
[mcp_servers.huashu-chrome]
command = "npx"
args = ["-y", "huashu-chrome", "mcp", "--client", "codex"]
Cursor / Gemini CLI / Windsurf / Claude Desktop — 各自的 JSON 配置里加:
{ "mcpServers": { "huashu-chrome": { "command": "npx", "args": ["-y", "huashu-chrome", "mcp"] } } }
--client 可以不写、写错也没关系:页面右下角和审计日志里显示的是宿主在 MCP 握手里
自报的身份(Claude Code / Codex CLI / Gemini CLI / OpenClaw …),这个参数只在宿主没报时兜底。
扩展:npx huashu-chrome extension 打印目录,然后 chrome://extensions
→ 开发者模式 → 加载已解压的扩展程序。
工具:按「网页只有三种信息载体」来分
22 个工具不是一堆平铺的功能,是三层。这个分层决定了 agent 面对陌生网站时按什么顺序出牌,
完整推演见 docs/能力模型.md——里面每条规则都跟着撞出它的那堵墙。
数据层(要数字、列表、表格,从这里开始)
| 工具 |
干什么 |
network |
看页面调了哪些接口、返回什么。字段名是站方写的,不用猜哪个数字是哪个指标 |
fetch |
带着你的 cookie 调接口。pages 一次调用翻完所有页(页码或游标),落盘成每行一页的 JSONL;binary 取图片 |
download |
大文件走浏览器原生下载,不占内存、不弹系统保存框 |
操作层(要做事,以及读文章)
| 工具 |
干什么 |
snapshot |
把当前页拍成带 ref 编号的可交互元素清单(含 value / checked / selected / expanded / disabled 和靠 class 表达的状态),弹窗和页面提示单列,一页通常 1–2k token。格式详解见 docs/快照格式.md |
fill |
一次填完整张表并提交。10 个字段一个来回,不是十个 |
click type select |
按 ref 操作,返回操作后的新快照。带 expect({checked, value, text, gone, appears})时回答的不再是「变没变」而是「变成我要的样子没有」,落空明说。画布、地图、游戏这类快照里什么都没有的页面,click {x, y} 按截图坐标发真实点击,dragTo 拖拽 |
key |
Esc / Tab / Enter / 方向键 / ctrl+a,可传数组一次按一串 |
navigate tabs wait scroll |
导航、标签页、等待、滚动加载 |
read_text |
正文提取成 markdown,去掉导航页脚广告和头像图 |
query |
按 CSS selector 结构化提取,用于没有可用接口的站点;contains 按文本找元素——「页面上有没有这句话」「这个状态字现在是什么」不必再写 eval |
upload |
把本地文件塞进网页的上传框——系统文件对话框是扩展够不着的,这是唯一的路 |
eval |
跑一段 JS。在页面自己的世界里求值,所以受页面 CSP 管,大站会拦 |
批处理
| 工具 |
干什么 |
act |
一次调用跑完多步。登录、多步表单、向导流程——agent 只要知道接下来要做什么,就一次说完。每步执行后自动验效果,出问题立刻停,最后只回一份快照。中途想看一眼用 read 步,观察结果随回执一起回来 |
人
| 工具 |
干什么 |
ask |
验证码、扫码登录、短信验证码、要你拍板的确认——把这一步交还给你。页面右下角浮一个小面板(不挡内容),高亮该点的元素,同时发桌面通知,然后等你。你点「取消」是明确的「别做这件事」,agent 会停下而不是换个姿势再来 |
兜底层
| 工具 |
干什么 |
screenshot |
只在版式本身就是问题时用。开了高保真模式可以直接截后台标签页,不打断你。默认 60% 缩放的 JPEG(视觉 token 省四分之三),full:true 拿 1:1 PNG;savePath 落盘不进上下文 |
这套顺序不用你教给 agent——MCP server 在握手时就把它作为 instructions 下发了。
每个操作都要交待「到底动没动」
浏览器 agent 最大的问题不是点不准,是静默失败:工具返回成功,页面其实没动。
一个三十步的任务,第八步悄悄失效,后面二十二步全是垃圾——而没有任何人知道。
所以这里每个写操作都不允许只回一句「已点击」,必须交待页面的反应:
[e7] 已点击
效果:expanded false → true

⚠️ 操作已发出,但页面完全没有反应(DOM、正文、焦点、目标状态、页面提示都没变)。
   可能是:① 这个元素只是容器,真正的按钮在它内部或旁边;② 只有异步副作用;③ 站点忽略了这次输入。

⚠️ 没有可归因于这次操作的变化。这个页面本身在持续变化(正文 -4 字),
   但目标元素的状态没动、也没有新的页面提示——那些变化多半不是这次操作造成的。
判定只回答一个确定性问题——页面动没动,不猜「成功还是失败」(那需要理解意图)。
而且只认「变化发生在目标附近」的证据:全局正文长度是页面里最脏的信号,
直播弹幕和懒加载列表每时每刻都在改它。
顺带的好处是更快:有反应就早停,不再固定等 400ms。
一次说完,别来回八趟
浏览器 agent 的另一个大成本是回合数。一个「点开始 → 填手机号 → 勾同意 →
下一步」的流程,逐个调用是 4 次模型推理加 4 份快照,而中间那 3 份快照
没有任何人读——agent 在发出第一个点击之前就知道后面三步要干什么了。
act 让它一次说完:
act 停在第 4 步 3/4:
  ✅ click button 「开始填写」   效果:目标区块文本 +29 字
  ✅ type  textbox 「手机号」←11字  效果:value 空 → 13800138000
  ✅ click button 「下一步」     效果:页面顶层移除 1 个元素(整块内容被换掉了)
  ⏸ click button 「提交订单」
     这是提交/支付/删除一类的动作,批处理不代做。单独调用一次 click 把它做掉。
它不是个盲目的宏:每一步都验过效果才走下一步,任何一步没反应就当场停下,
把「做到哪、为什么停、还剩什么」讲清楚。而且提交、支付、删除、发布这类动作
永远不代做——一串动作里夹一个它,跑完了中间没有任何人看得见。
越用越快:经验回流
浏览器 agent 最大的时间成本是在陌生网站上试错。同一个飞书多维表格任务,
从零摸索用了 281 次调用、54 分钟;把摸清的规律记下来之后,第二次只需要不到 10 次。
learnings 工具就是干这个的,经验分两层:
- 出厂经验:随 npm 包分发(
docs/经验/),装上就有。当前 23 个站——
上面那张表里的 10 个,加上淘宝、微信公众号、搜狗微信搜索、微博、知乎、豆瓣、脉脉、
大麦、即刻、腾讯文档、Ollama,以及两个 canvas 游戏(sudoku.com / flappybird.io,
它们是「棋盘不在 DOM 里」这类页面的样板)。已验证的接口名、墙、坑,
每条都标了实测日期。升级版本就拿到新经验。
- 本机经验:
~/.huashu-chrome/learnings/,agent 每次干活学到的新规律
自己存进去(新站摸清了门路、老站发现记录过时了),永远不会被升级覆盖。
全在你自己的磁盘上,不上传。
agent 开工前查一次(learnings {domain}),收工时把非显而易见的发现存回去
(learnings {domain, save})。经验是提示不是规则——站点会改版、每个人的
环境不一样,所以工具返回的每一份经验都带着同一句话:与页面实际不符时,
以实际为准,然后把记录改对。查不到经验也不阻塞,按通用策略干就是了。
摸清了一个新站?欢迎把 ~/.huashu-chrome/learnings/ 里的文件提 PR 到
docs/经验/,让所有用户受益。提之前记得先看一遍有没有把你自己的
账号、行程、订单号写进去——那个目录是 agent 自动写的,它不知道哪些字不该出门。
点不动的时候,自动换真实事件
content script 派发的事件 isTrusted 永远是 false。四类场景因此结构性失效:
检查 isTrusted 的风控站点、自管输入的编辑器(Monaco / CodeMirror / 飞书富文本)、
需要用户手势才解锁的 API、以及原生文件对话框。
所以当一次操作没有留下任何证据时,会自动换成浏览器级的真实输入事件再试一次:
[#trustedOnly] 已点击(真实事件) ← 普通事件无效,已自动改用真实事件
效果:目标区块文本 +6 字
两条边界:
- 提交 / 支付 / 下单 / 删除 / 发布这类目标,永不自动重试。 普通事件可能其实已经
生效、只是没留下痕迹,重试就是下第二笔单。这道闸是正则加 DOM 特征的确定性判断,
不问模型。需要时由 agent 显式传
real:true。
- 原生
<select> 强制不走这条路。 实测它的下拉是浏览器进程渲染的,
调试器的输入事件打不到,点了反而卡住。
这条路要用调试器权限,随扩展安装一次性授予,装完就能用,不需要额外点任何东西。
(本来想做成「用时再授权」,但 Chrome 不允许 debugger 作为可选权限。)
不想要的话,扩展弹窗里有开关可以关掉。开着的时候也只在真正需要的那几秒接入,
用完自动断开——黄条不常驻。
实测结论:后台标签页里,九个鼠标事件完整送达且 isTrusted 全为 true。
agent 用真实事件干活的同时,你的浏览器还是你的——不用像别的方案那样
另开一个你看得见的窗口。
你看得见它在干活
agent 全在后台标签页里干活,用户面前本来是一片安静的浏览器——他随手点开一页,
不知道那页已经被某个会话认领了。所以每个会话都有一张工牌,同一套身份三处露出:
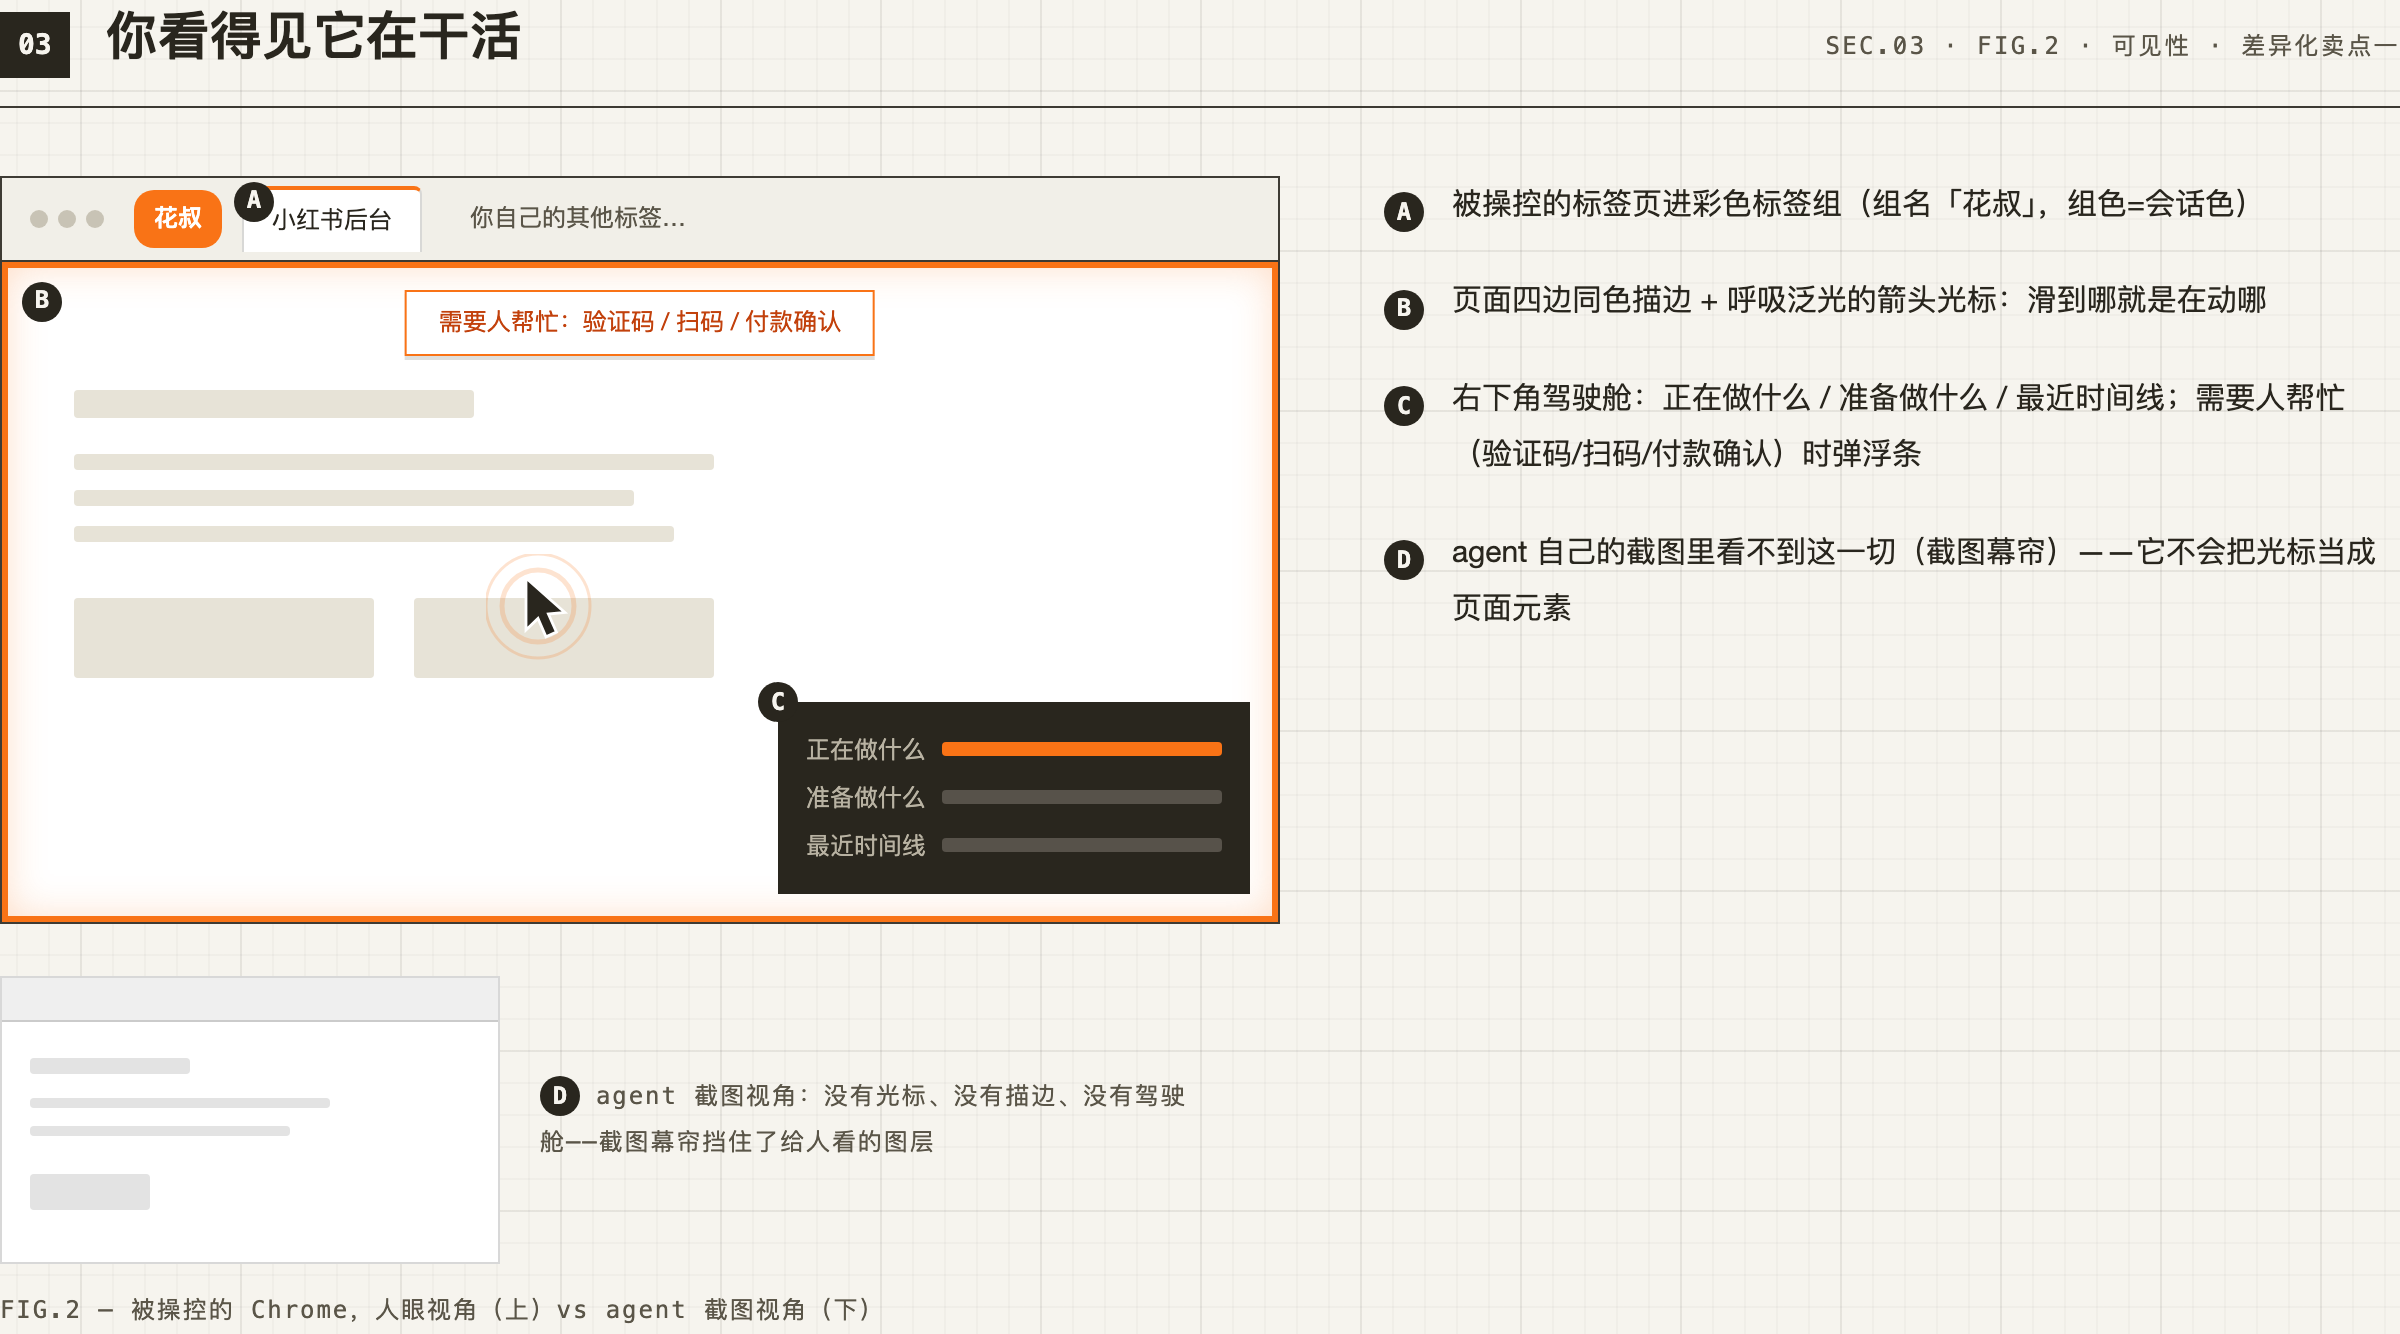
| 露出位置 |
长什么样 |
解决什么 |
| 标签栏 |
受控页进彩色标签组(组色 = 会话色) |
agent 默认后台干活,用户根本不会切进去。标签组的彩色胶囊在标签挤到最窄时仍可见,这是后台唯一看得见的信号。网站自己的 favicon 和标题一个字不动 |
| 页内 |
同色细边框 + 呼吸泛光的箭头光标 + 右下角驾驶舱(正在做 / 准备做 / 时间线) |
他切进去那一眼就知道这页有主、是谁、在干什么、接下来要� |

 一个 MCP 服务器加 Chrome 扩展(22 个浏览器工具),让 Claude Code、Codex CLI、Cursor、Gemini CLI 这类 AI 智能体用你已有的登录状态驱动你自己的 Chrome —— 不需要 API 密钥,也不用重新登录。