

345 ·GitHub
What is this?
 An MCP server + Chrome extension (22 browser tools) that lets AI agents like Claude Code, Codex CLI, Cursor and Gemini CLI drive your own Chrome with your existing logins — no API key, no re-login.
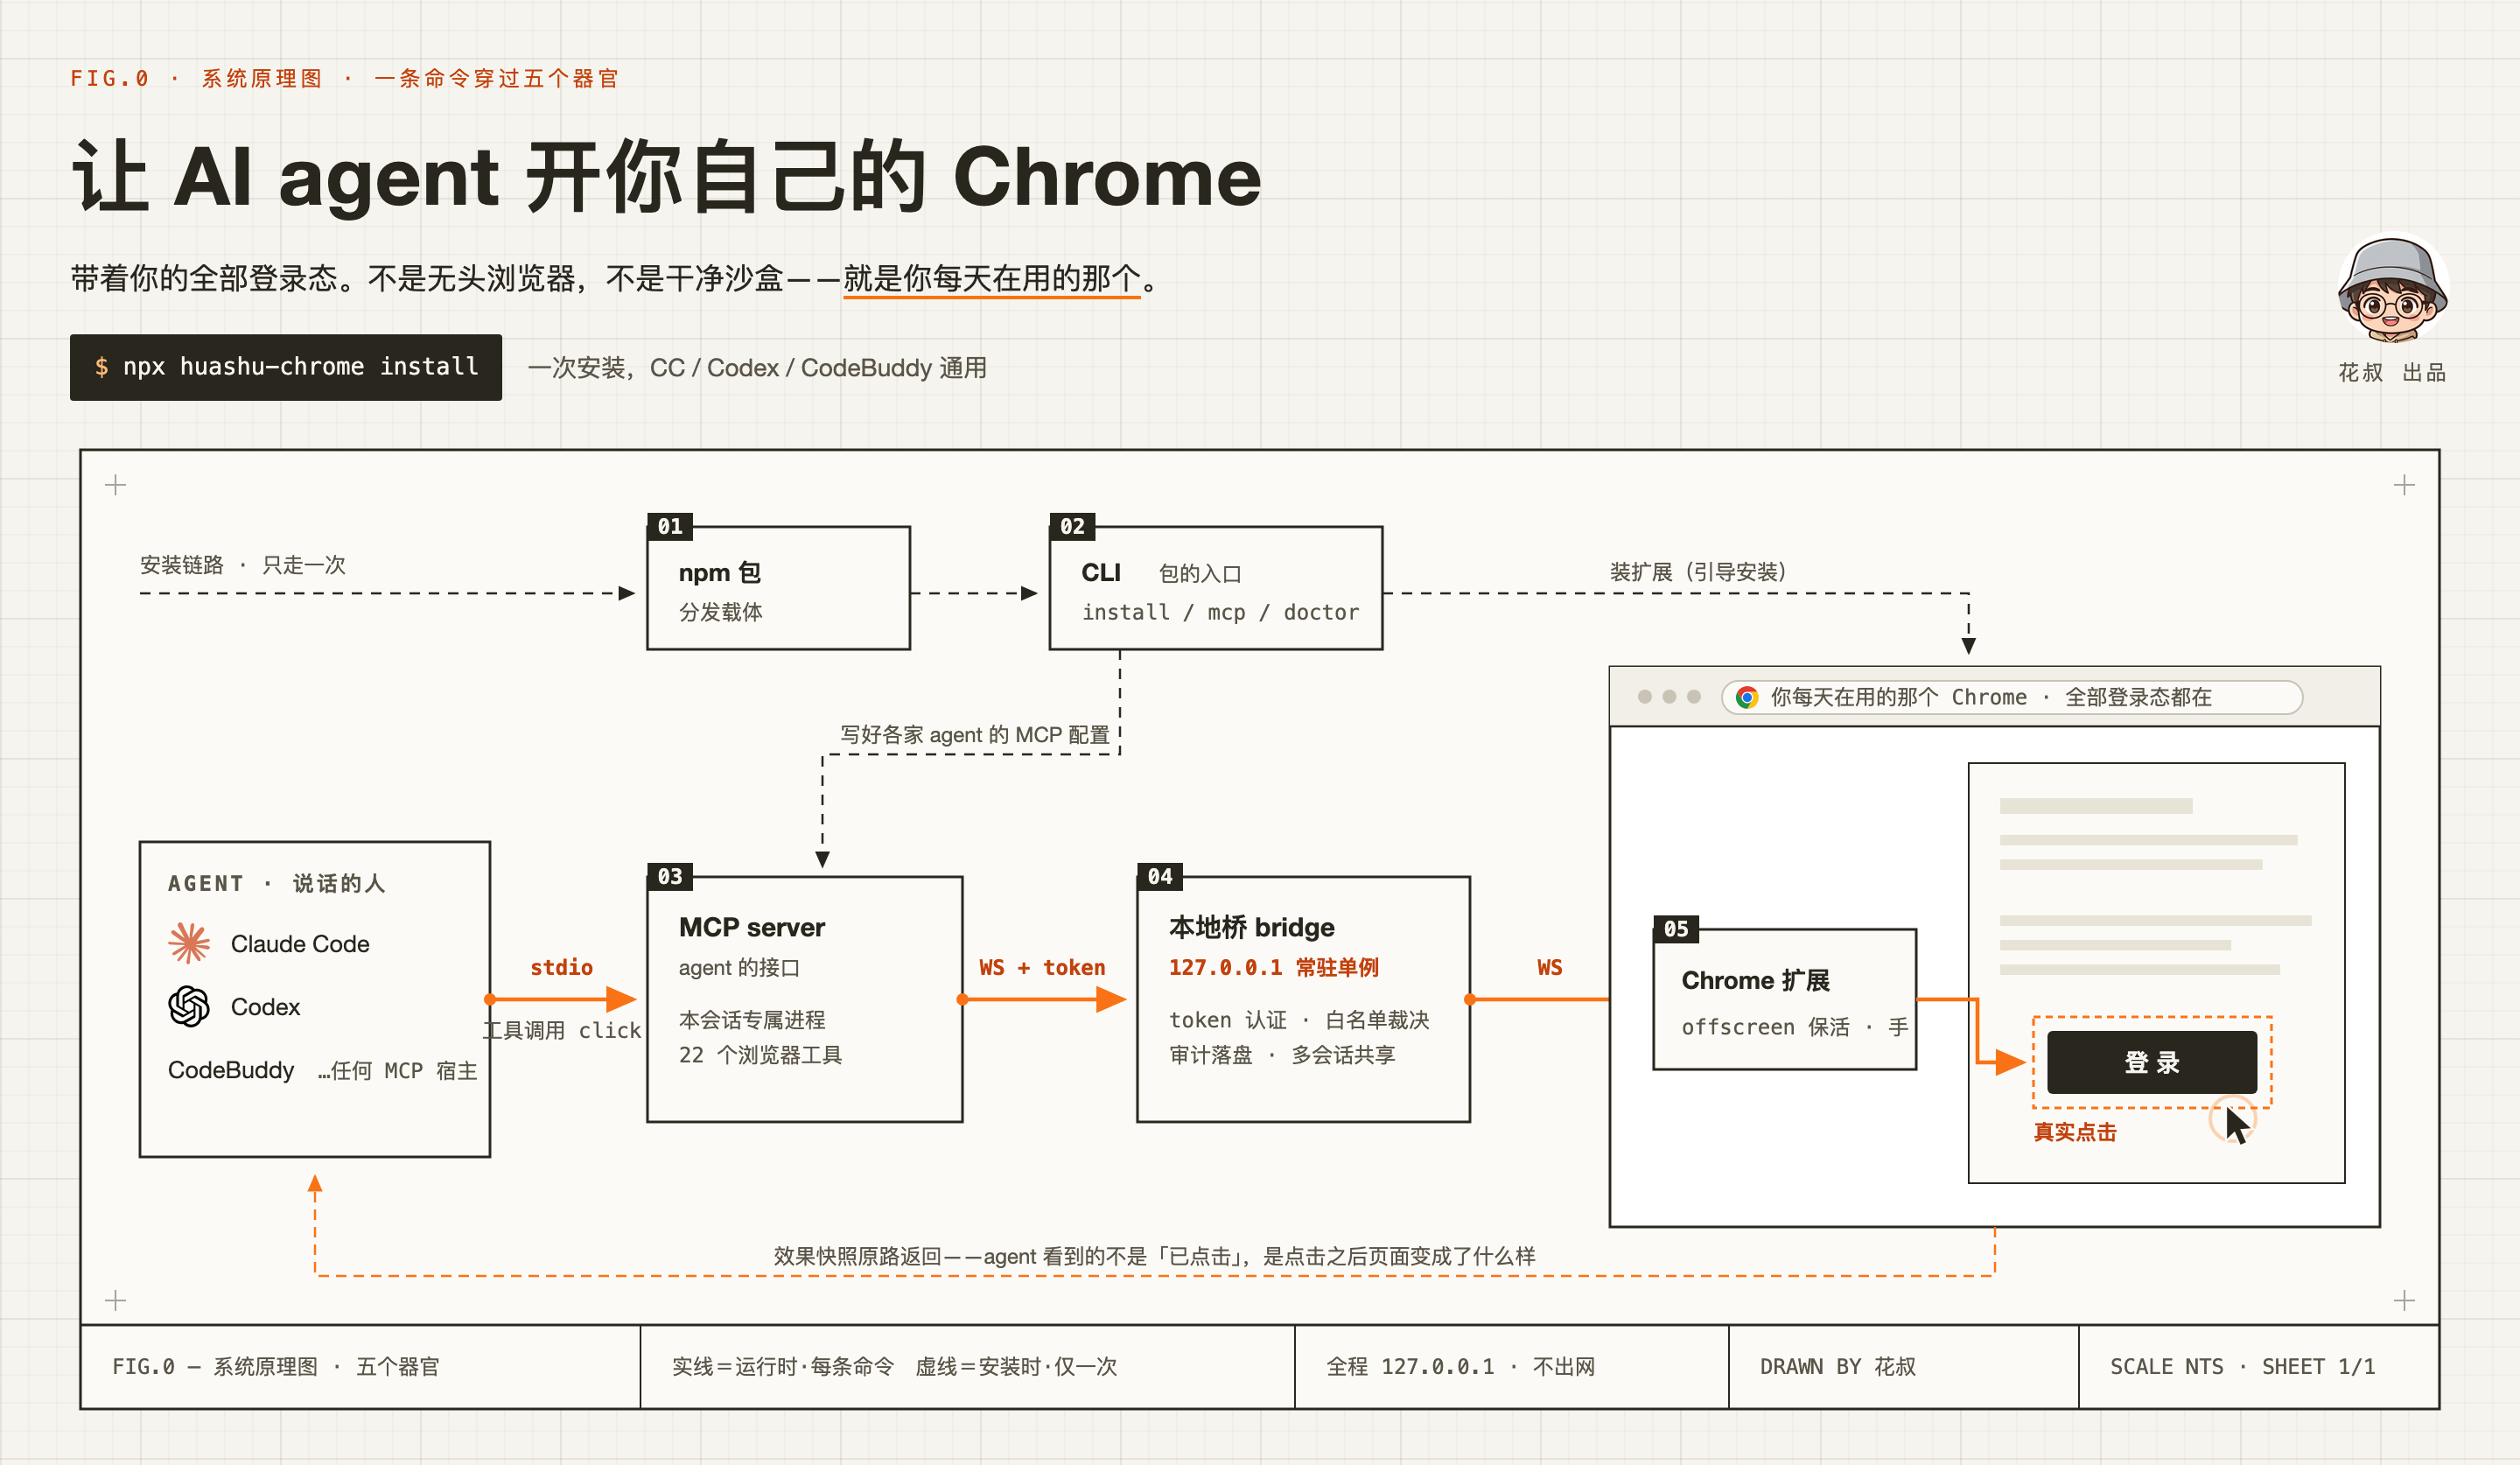
Is it an npm package, a CLI, or a browser extension?All three, one product: the npm package distributes it, the CLI is the entry point (install / mcp / doctor), the MCP server is the agent-facing interface, a bridge runs locally on 127.0.0.1, and the Chrome extension is the hands.
All three, one product: the npm package distributes it, the CLI is the entry point (install / mcp / doctor), the MCP server is the agent-facing interface, a bridge runs locally on 127.0.0.1, and the Chrome extension is the hands.How do I set it up?One command detects your installed agents and writes their MCP configs (backs up first, skips configured ones, --dry-run to preview), then guides you through loading the unpacked extension in chrome://extensions — that click must be yours. Run doctor to verify the handshake.
One command detects your installed agents and writes their MCP configs (backs up first, skips configured ones, --dry-run to preview), then guides you through loading the unpacked extension in chrome://extensions — that click must be yours. Run doctor to verify the handshake.Which AI agents can drive it — and do I need an API key?Any MCP-compatible agent: 20 are pre-listed in src/agents.json (Claude Code, Codex CLI, Cursor, Gemini CLI, Windsurf, Cline, Roo Code, Claude Desktop and more), and unlisted ones are auto-discovered by scanning dot-dirs for mcpServers configs. No API key needed.
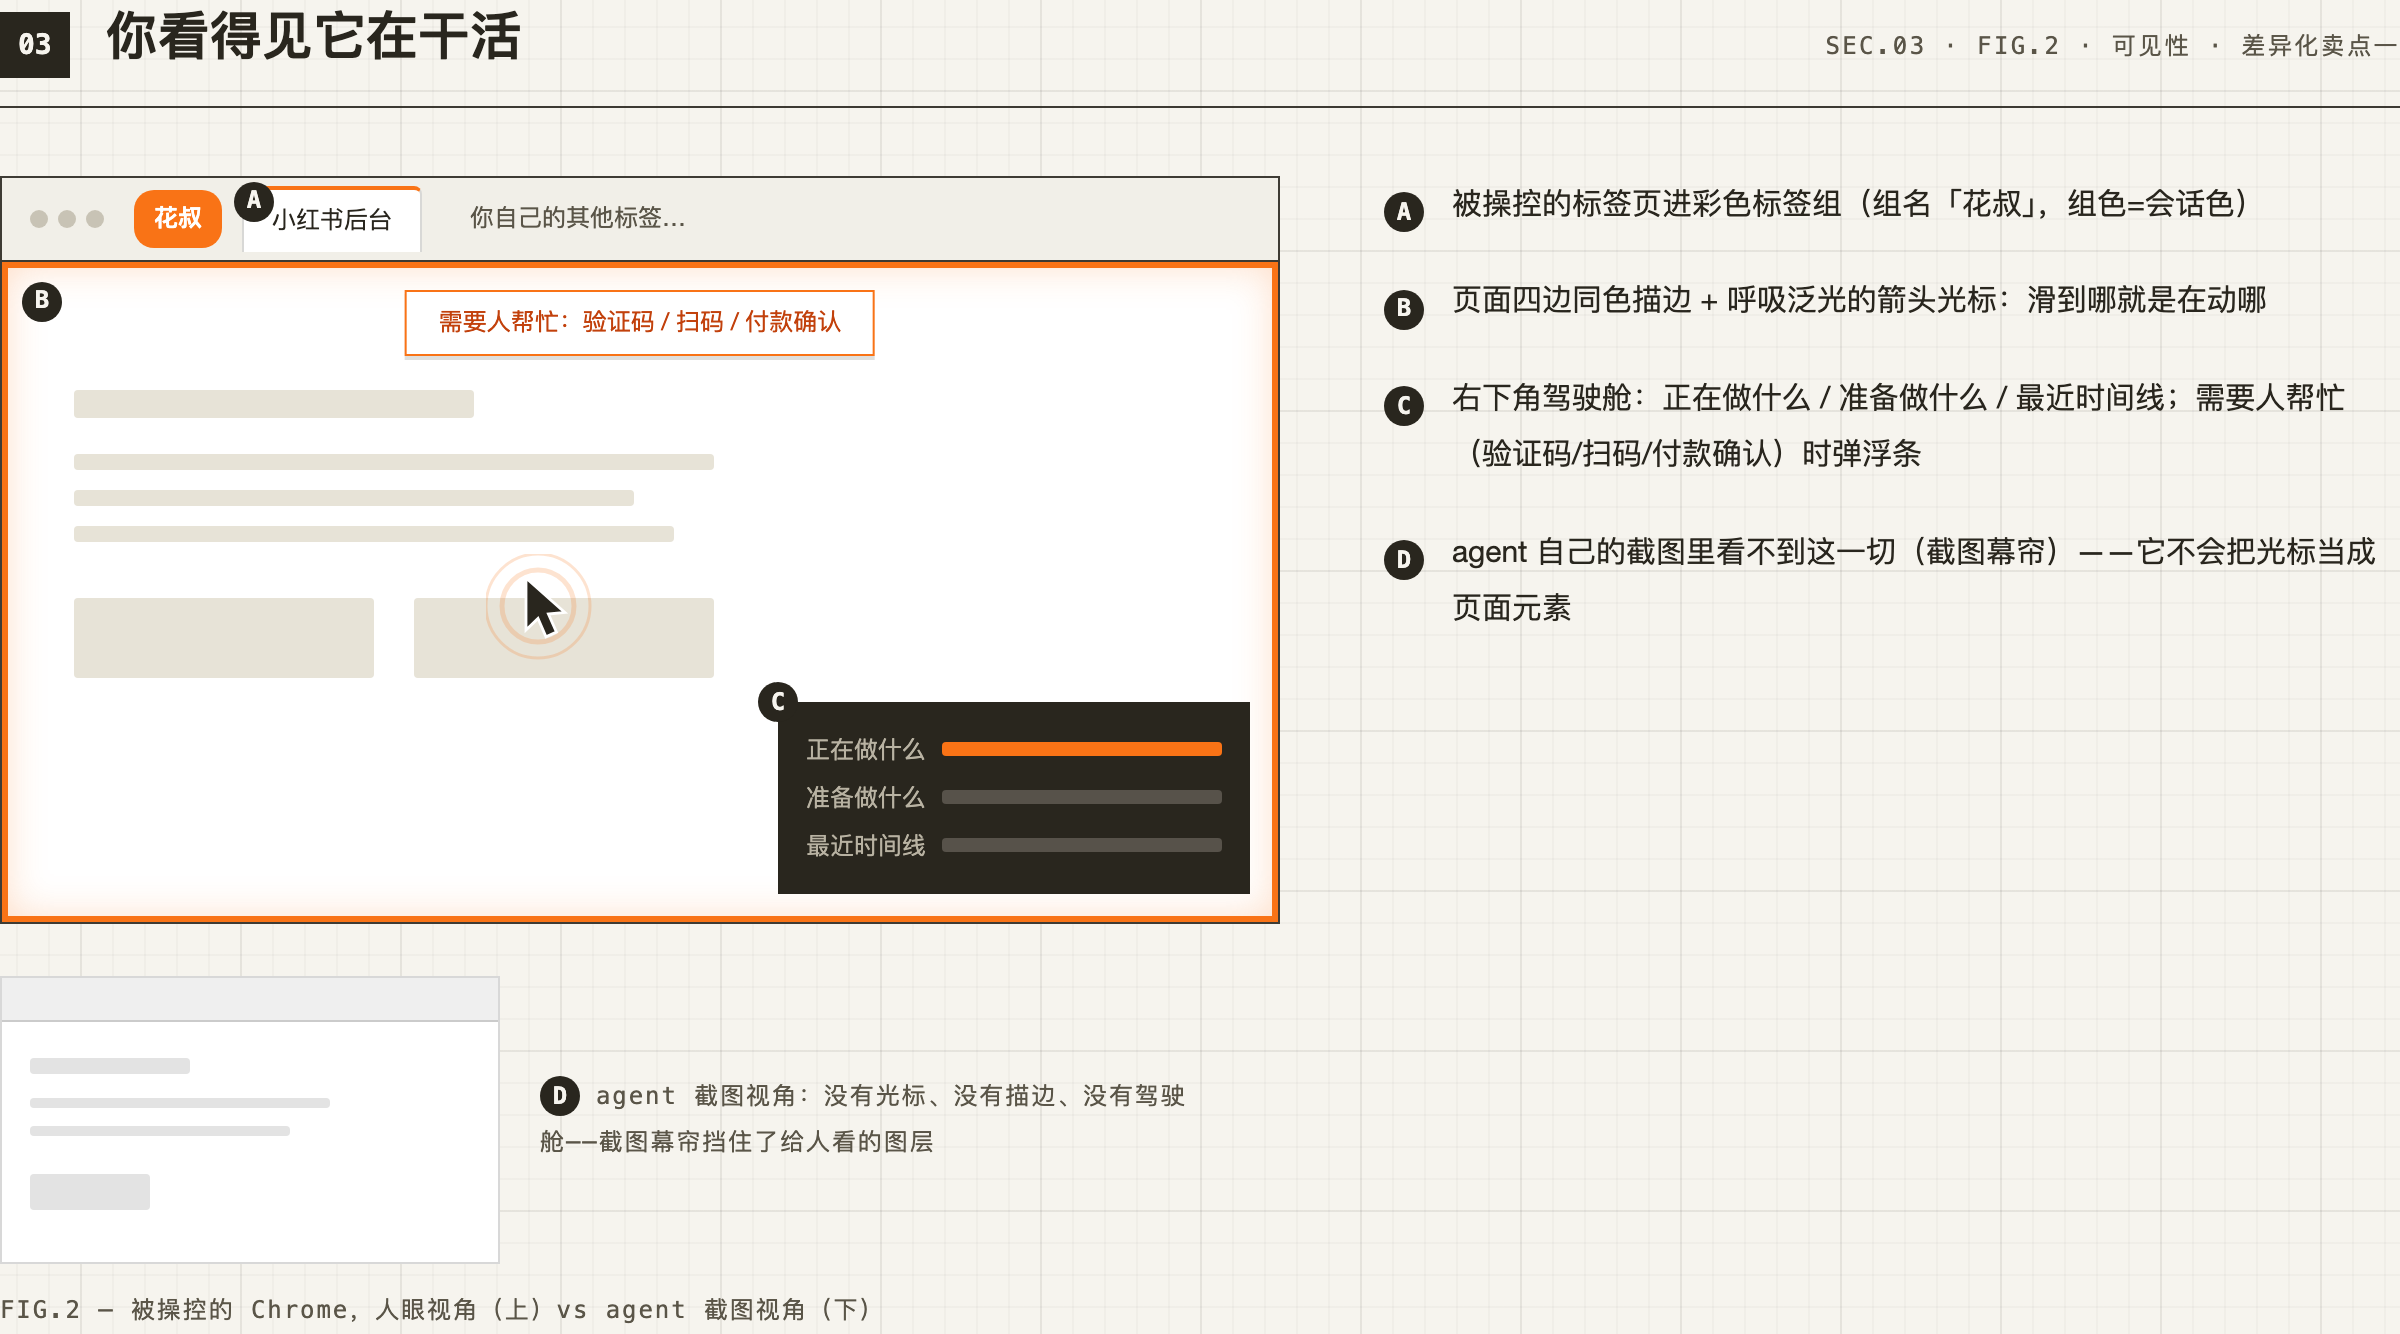
Any MCP-compatible agent: 20 are pre-listed in src/agents.json (Claude Code, Codex CLI, Cursor, Gemini CLI, Windsurf, Cline, Roo Code, Claude Desktop and more), and unlisted ones are auto-discovered by scanning dot-dirs for mcpServers configs. No API key needed.Are there sites it just can't work on?Chrome Web Store pages are off-limits — no extension can inject into them. eval runs under each page's CSP, so big sites can block it. Submits, payments, deletes and publishes are never auto-done, and CAPTCHAs or QR logins are handed back to you.
Chrome Web Store pages are off-limits — no extension can inject into them. eval runs under each page's CSP, so big sites can block it. Submits, payments, deletes and publishes are never auto-done, and CAPTCHAs or QR logins are handed back to you.What are the 22 tools, in a nutshell?Layered by how a page carries information: data tools first (network to see a site's own APIs, fetch with your cookies, download for big files), action tools (snapshot, fill, click, key, readtext, query, upload, eval), act to run whole multi-step flows in one call, ask to hand a step to you, screenshot as last resort.
Layered by how a page carries information: data tools first (network to see a site's own APIs, fetch with your cookies, download for big files), action tools (snapshot, fill, click, key, readtext, query, upload, eval), act to run whole multi-step flows in one call, ask to hand a step to you, screenshot as last resort.How does it keep the agent from failing silently?Every write operation must report the page's actual reaction — returning 'clicked' alone is not allowed; the verdict answers only whether the page changed near the target. act validates each step and stops at the first one with no effect, and the expect flag checks the outcome was what you asked for.
Every write operation must report the page's actual reaction — returning 'clicked' alone is not allowed; the verdict answers only whether the page changed near the target. act validates each step and stops at the first one with no effect, and the expect flag checks the outcome was what you asked for.Why this instead of Playwright MCP or Claude in Chrome?Per the author's comparison: tools that use your real login state are mostly locked to their own clients (Claude in Chrome only works with Anthropic apps), while agent-agnostic ones drive a clean, logged-out browser. huashu-chrome wants both, and ships tested notes for 20+ sites plus human handoff for CAPTCHAs and payments.
Per the author's comparison: tools that use your real login state are mostly locked to their own clients (Claude in Chrome only works with Anthropic apps), while agent-agnostic ones drive a clean, logged-out browser. huashu-chrome wants both, and ships tested notes for 20+ sites plus human handoff for CAPTCHAs and payments.Does it get faster the more you use it?Yes, via two layers of learnings: factory notes for 23 sites ship inside the npm package, and the agent saves new per-site patterns to your local learnings folder, which upgrades never overwrite. One Feishu task took 281 calls / 54 minutes from scratch; following the notes, under 10 rounds.
Yes, via two layers of learnings: factory notes for 23 sites ship inside the npm package, and the agent saves new per-site patterns to your local learnings folder, which upgrades never overwrite. One Feishu task took 281 calls / 54 minutes from scratch; following the notes, under 10 rounds.What are similar projects?bb-browser, rea, XActions, Endoplexity, agentmemory, superpowers-zh, mcp-chrome, xiaohongshu-mcp
bb-browser, rea, XActions, Endoplexity, agentmemory, superpowers-zh, mcp-chrome, xiaohongshu-mcpWhich topics is it in?agent-tools, gemini-cli, chrome-extension, browser-extension, openclaw, browser-automation, cursor, mcp-server, codex, claude-code, mcp, npm
agent-tools, gemini-cli, chrome-extension, browser-extension, openclaw, browser-automation, cursor, mcp-server, codex, claude-code, mcp, npm