

这是什么?
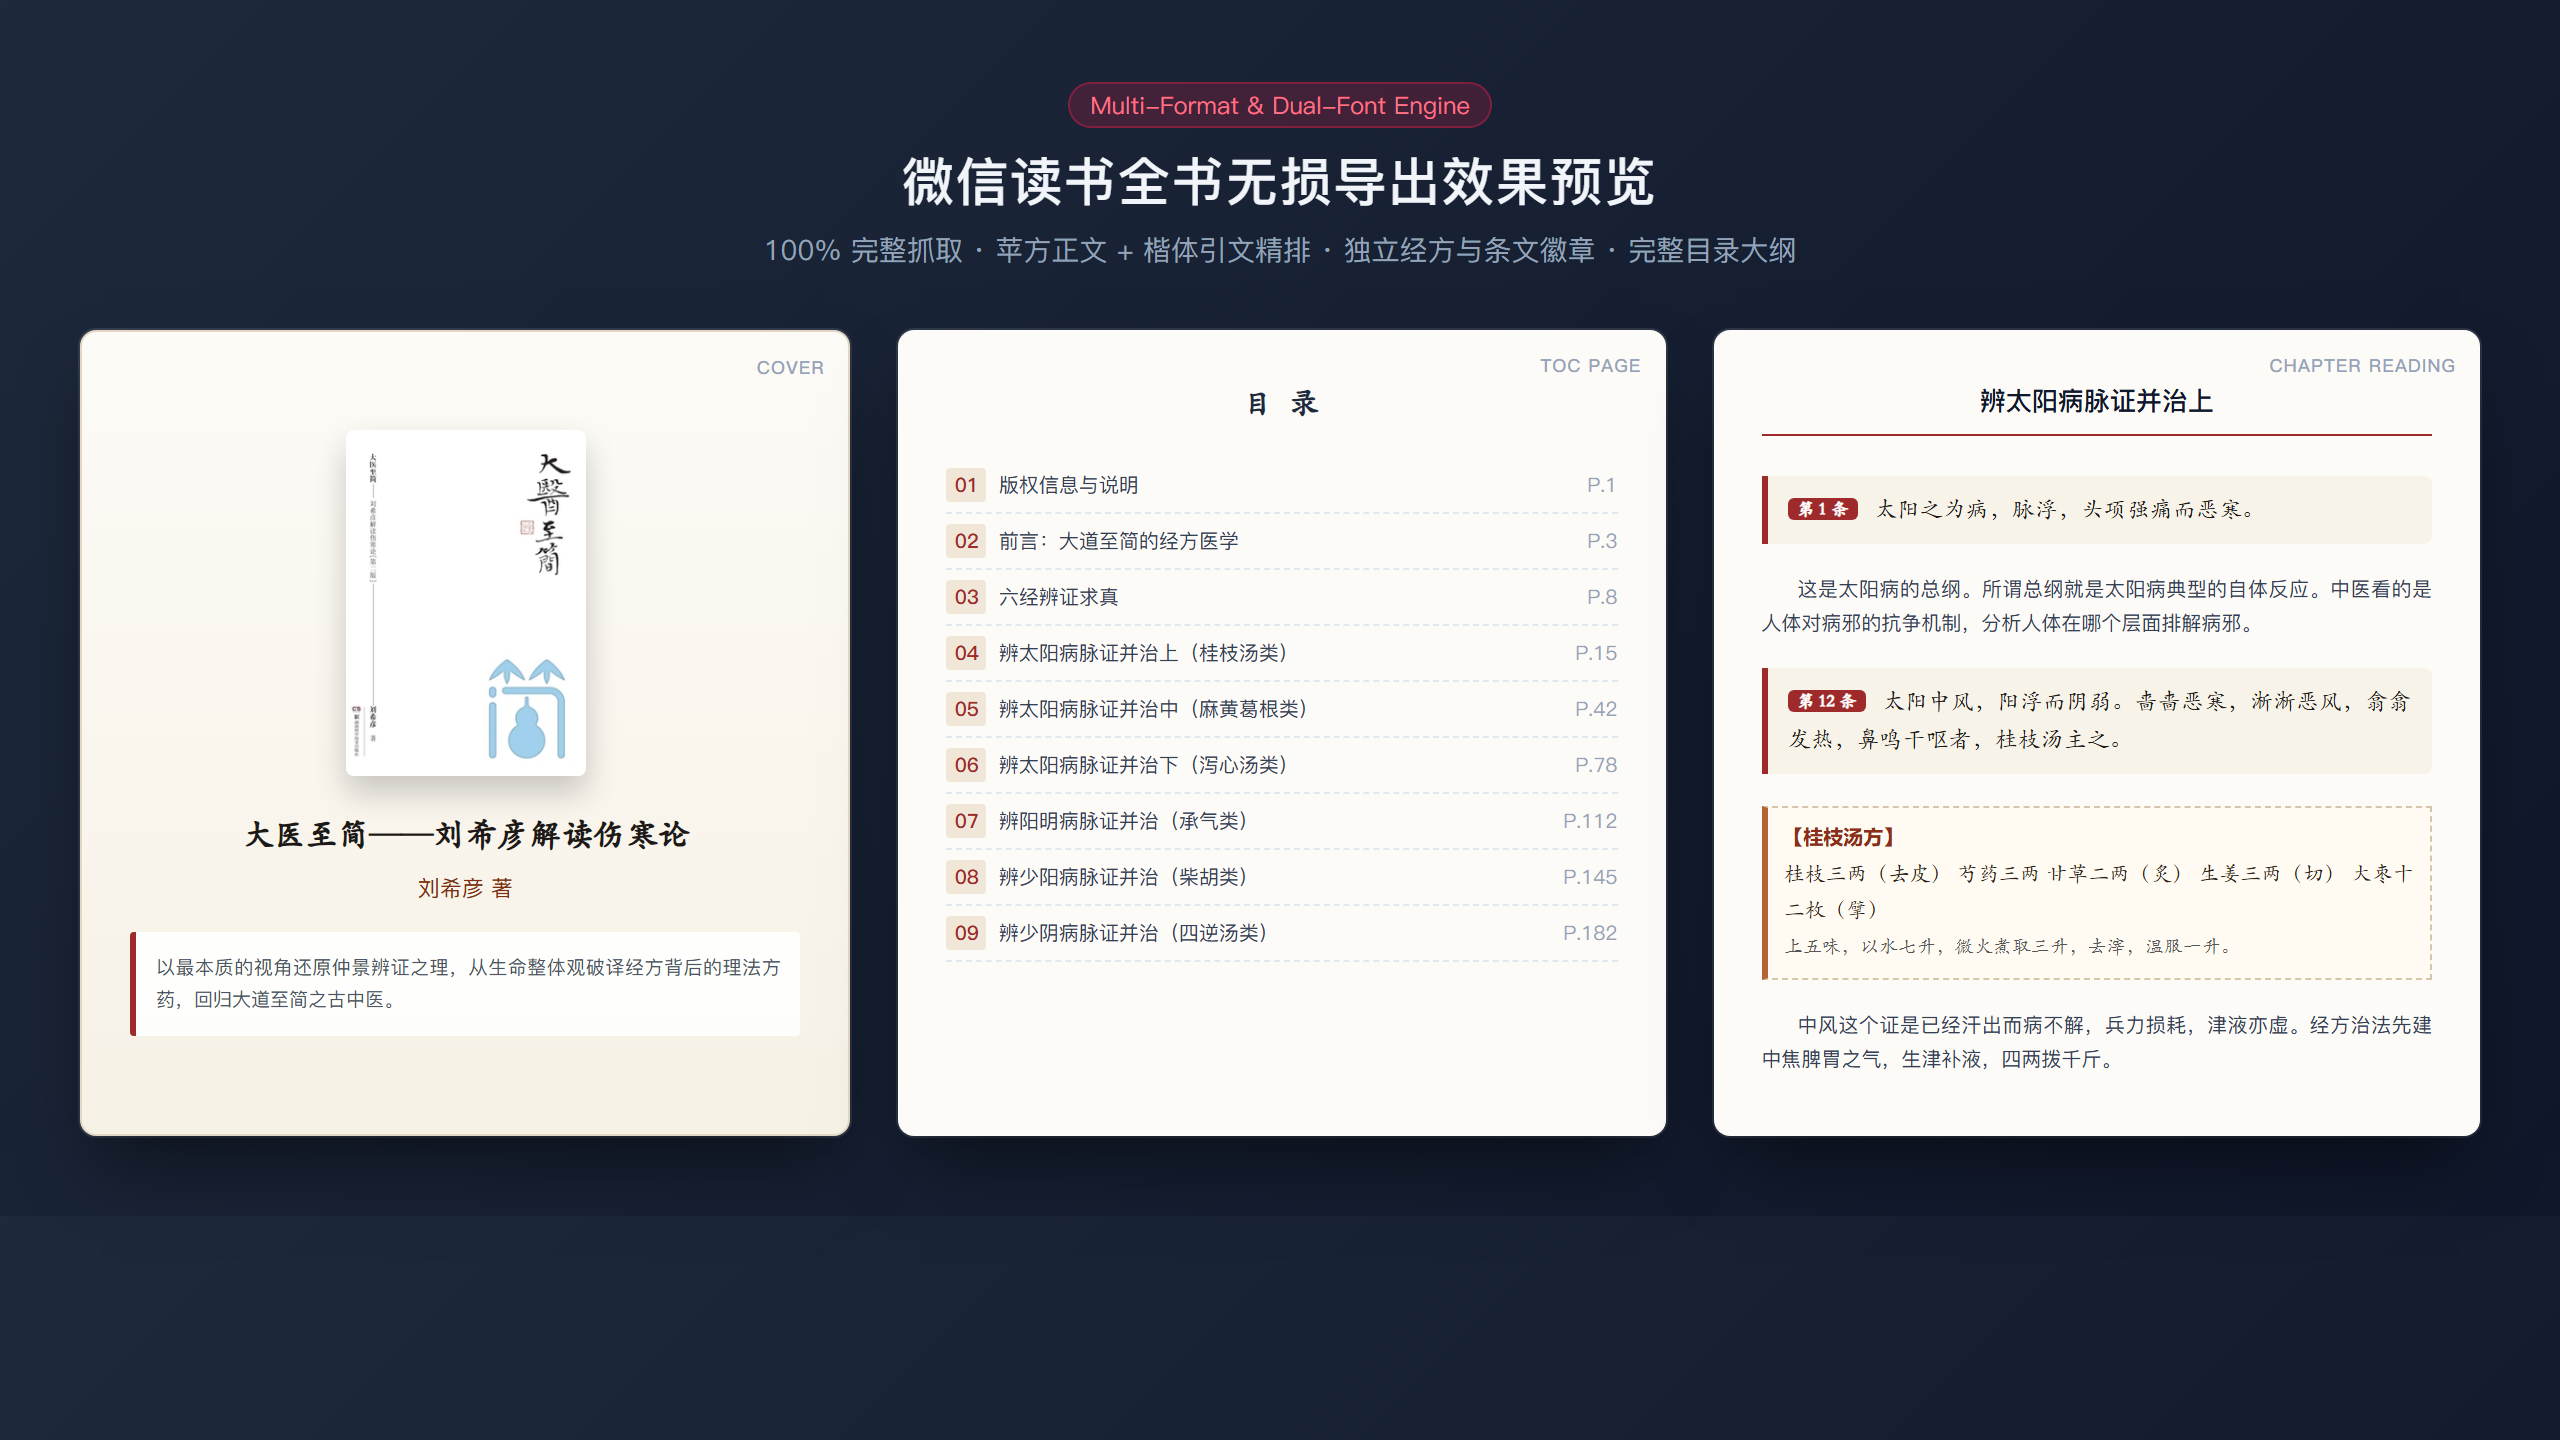
 一个 Python 工具,可以保存你在微信读书网页版上已购买书籍的全文,并导出为排版好的 PDF、EPUB 或 Markdown 笔记,插图保持原位。
我能得到哪些格式?分别用在哪里?排版好的 PDF,适合在 iPad 上批注、在电脑上阅读和打印;EPUB,适合苹果图书或 Kindle;普通或带样式的 Markdown,适合 Obsidian 和 Notion。
排版好的 PDF,适合在 iPad 上批注、在电脑上阅读和打印;EPUB,适合苹果图书或 Kindle;普通或带样式的 Markdown,适合 Obsidian 和 Notion。我怎么运行它?安装依赖,把书籍的完整微信读书网页版链接粘贴到脚本中,然后让它运行。第一次运行时会打开一个浏览器窗口,你只需用微信扫码一次。结果会保存在 output/ 文件夹中。
安装依赖,把书籍的完整微信读书网页版链接粘贴到脚本中,然后让它运行。第一次运行时会打开一个浏览器窗口,你只需用微信扫码一次。结果会保存在 output/ 文件夹中。我需要安装浏览器吗?通常不需要:脚本会使用你电脑上已有的 Microsoft Edge 或 Google Chrome。如果两者都没有安装,运行 'playwright install chromium' 下载一个即可。需要安装 Python。
通常不需要:脚本会使用你电脑上已有的 Microsoft Edge 或 Google Chrome。如果两者都没有安装,运行 'playwright install chromium' 下载一个即可。需要安装 Python。导出大部头的书会不会特别慢?大概会很慢,这是设计使然。翻页时会随机等待 8 到 20 秒,每翻 10 到 20 页,脚本还会暂停 1 到 2 分钟,以免给服务器造成过大压力。
大概会很慢,这是设计使然。翻页时会随机等待 8 到 20 秒,每翻 10 到 20 页,脚本还会暂停 1 到 2 分钟,以免给服务器造成过大压力。会保留章节、引文和图片吗?会。脚本能识别章节标题、引文和重点段落,以及加粗的小标题,并按阅读顺序嵌入所有原始高清插图。
会。脚本能识别章节标题、引文和重点段落,以及加粗的小标题,并按阅读顺序嵌入所有原始高清插图。翻页时怎么避免丢失文字?它会把阅读器切换为双栏横向翻页,捕获 Canvas 绘图指令和分栏坐标,再按顺序重建每一页的文字流,因此文字不会在页与页之间被跳过或重复。
它会把阅读器切换为双栏横向翻页,捕获 Canvas 绘图指令和分栏坐标,再按顺序重建每一页的文字流,因此文字不会在页与页之间被跳过或重复。Markdown 输出是什么样的?有一个普通版本,其中引文会变成 > 引用块;还有一个带标签的样式版本。两者都适合在 Obsidian 或 Notion 中搜索和做笔记。
有一个普通版本,其中引文会变成 > 引用块;还有一个带标签的样式版本。两者都适合在 Obsidian 或 Notion 中搜索和做笔记。有哪些类似的项目?qiaomu-anything-to-notebooklm, solo-skills, ljg-skills, chubbyskills, qiaomu-book-reader-legacy, qiaomu-clipper, EverRoom, claude-obsidian
qiaomu-anything-to-notebooklm, solo-skills, ljg-skills, chubbyskills, qiaomu-book-reader-legacy, qiaomu-clipper, EverRoom, claude-obsidian它属于哪些主题?notion, epub, scraping, obsidian, ebook, knowledge-management, wechat, note-taking, playwright, web-scraping, browser-automation, pdf
notion, epub, scraping, obsidian, ebook, knowledge-management, wechat, note-taking, playwright, web-scraping, browser-automation, pdf