

Что это такое?
 Инструмент на Python, который сохраняет полный текст книг, купленных в веб-читалке WeRead, и экспортирует их в вёрстанный PDF, EPUB или заметки в Markdown с иллюстрациями на своих местах.
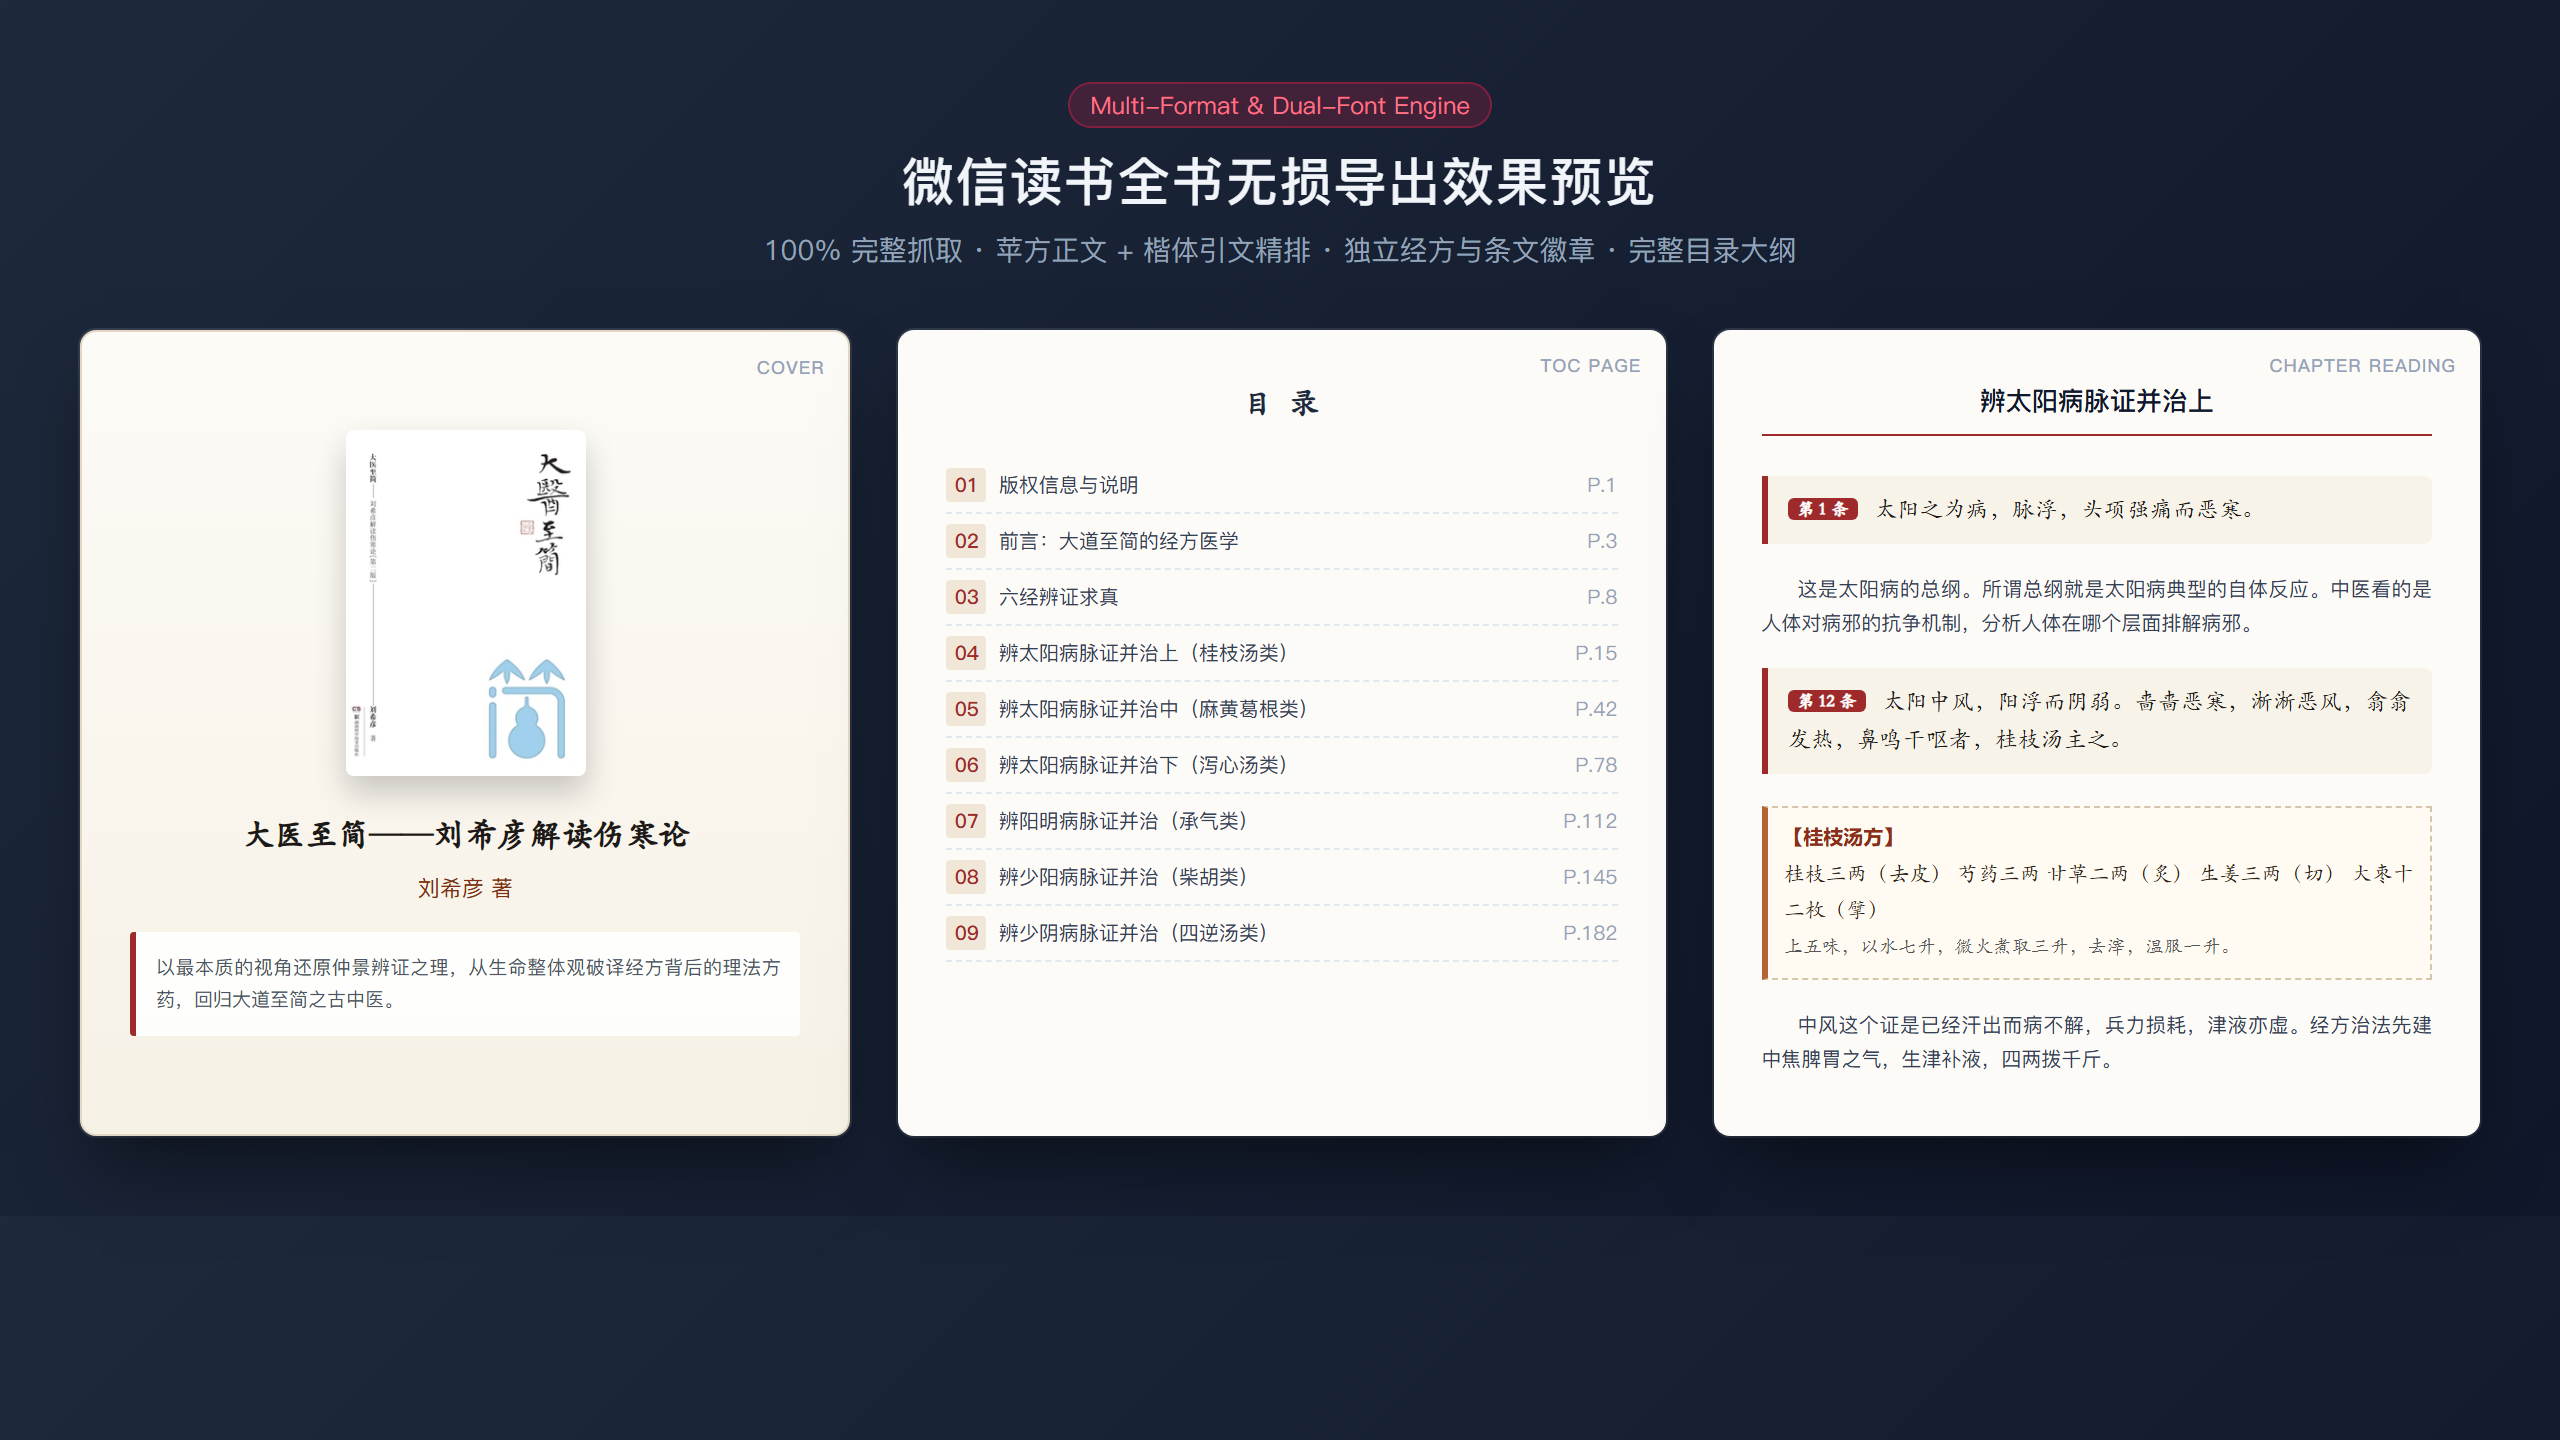
Какие форматы я получу и где их можно использовать?Вёрстанный PDF для аннотирования на iPad, чтения на компьютере и печати, EPUB для Apple Books или Kindle и простой или оформленный Markdown для Obsidian и Notion.
Вёрстанный PDF для аннотирования на iPad, чтения на компьютере и печати, EPUB для Apple Books или Kindle и простой или оформленный Markdown для Obsidian и Notion.Как это запустить?Установите зависимости, вставьте в скрипт полную веб-ссылку на книгу в WeRead и дождитесь окончания работы. При первом запуске откроется окно браузера, в котором нужно один раз отсканировать QR-код WeChat. Результаты сохраняются в папку output/.
Установите зависимости, вставьте в скрипт полную веб-ссылку на книгу в WeRead и дождитесь окончания работы. При первом запуске откроется окно браузера, в котором нужно один раз отсканировать QR-код WeChat. Результаты сохраняются в папку output/.Нужно ли устанавливать браузер?Обычно нет: скрипт использует Microsoft Edge или Google Chrome, которые уже есть на вашем компьютере. Если ни один из них не установлен, выполните 'playwright install chromium', чтобы скачать браузер. Нужен Python.
Обычно нет: скрипт использует Microsoft Edge или Google Chrome, которые уже есть на вашем компьютере. Если ни один из них не установлен, выполните 'playwright install chromium', чтобы скачать браузер. Нужен Python.Большая книга будет экспортироваться целую вечность?Скорее всего, да, это задумано так. Переход между страницами занимает случайные 8–20 секунд, а каждые 10–20 страниц скрипт делает паузу на 1–2 минуты, чтобы не перегружать сервер.
Скорее всего, да, это задумано так. Переход между страницами занимает случайные 8–20 секунд, а каждые 10–20 страниц скрипт делает паузу на 1–2 минуты, чтобы не перегружать сервер.Сохранятся ли главы, цитаты и картинки?Да. Скрипт распознаёт названия глав, цитаты, ключевые абзацы и жирные подзаголовки, а затем встраивает все оригинальные иллюстрации в высоком разрешении в порядке чтения.
Да. Скрипт распознаёт названия глав, цитаты, ключевые абзацы и жирные подзаголовки, а затем встраивает все оригинальные иллюстрации в высоком разрешении в порядке чтения.Как не теряется текст на границах страниц?Читалка переключается на горизонтальную постраничную навигацию в две колонки. Скрипт собирает команды рисования Canvas и координаты колонок и восстанавливает текстовый поток каждой страницы по порядку, поэтому текст не пропускается и не повторяется между страницами.
Читалка переключается на горизонтальную постраничную навигацию в две колонки. Скрипт собирает команды рисования Canvas и координаты колонок и восстанавливает текстовый поток каждой страницы по порядку, поэтому текст не пропускается и не повторяется между страницами.Как выглядит результат в Markdown?Есть простая версия, где цитаты превращаются в блоки > (blockquote), и оформленная версия с тегами. Обе предназначены для поиска и ведения заметок в Obsidian или Notion.
Есть простая версия, где цитаты превращаются в блоки > (blockquote), и оформленная версия с тегами. Обе предназначены для поиска и ведения заметок в Obsidian или Notion.Какие есть похожие проекты?qiaomu-anything-to-notebooklm, solo-skills, ljg-skills, chubbyskills, qiaomu-book-reader-legacy, qiaomu-clipper, EverRoom, claude-obsidian
qiaomu-anything-to-notebooklm, solo-skills, ljg-skills, chubbyskills, qiaomu-book-reader-legacy, qiaomu-clipper, EverRoom, claude-obsidianВ каких он темах?notion, epub, scraping, obsidian, ebook, knowledge-management, wechat, note-taking, playwright, web-scraping, browser-automation, pdf
notion, epub, scraping, obsidian, ebook, knowledge-management, wechat, note-taking, playwright, web-scraping, browser-automation, pdf