Awesome Chinese LLM
An Awesome Collection for LLM in Chinese
收集和梳理中文LLM相关
自ChatGPT为代表的大语言模型(Large Language Model, LLM)出现以后,由于其惊人的类通用人工智能(AGI)的能力,掀起了新一轮自然语言处理领域的研究和应用的浪潮。尤其是以ChatGLM、LLaMA等平民玩家都能跑起来的较小规模的LLM开源之后,业界涌现了非常多基于LLM的二次微调或应用的案例。本项目旨在收集和梳理中文LLM相关的开源模型、应用、数据集及教程等资料,目前收录的资源已达100+个!
如果本项目能给您带来一点点帮助,麻烦点个⭐️吧~
同时也欢迎大家贡献本项目未收录的开源模型、应用、数据集等。提供新的仓库信息请发起PR,并按照本项目的格式提供仓库链接、star数,简介等相关信息,感谢~
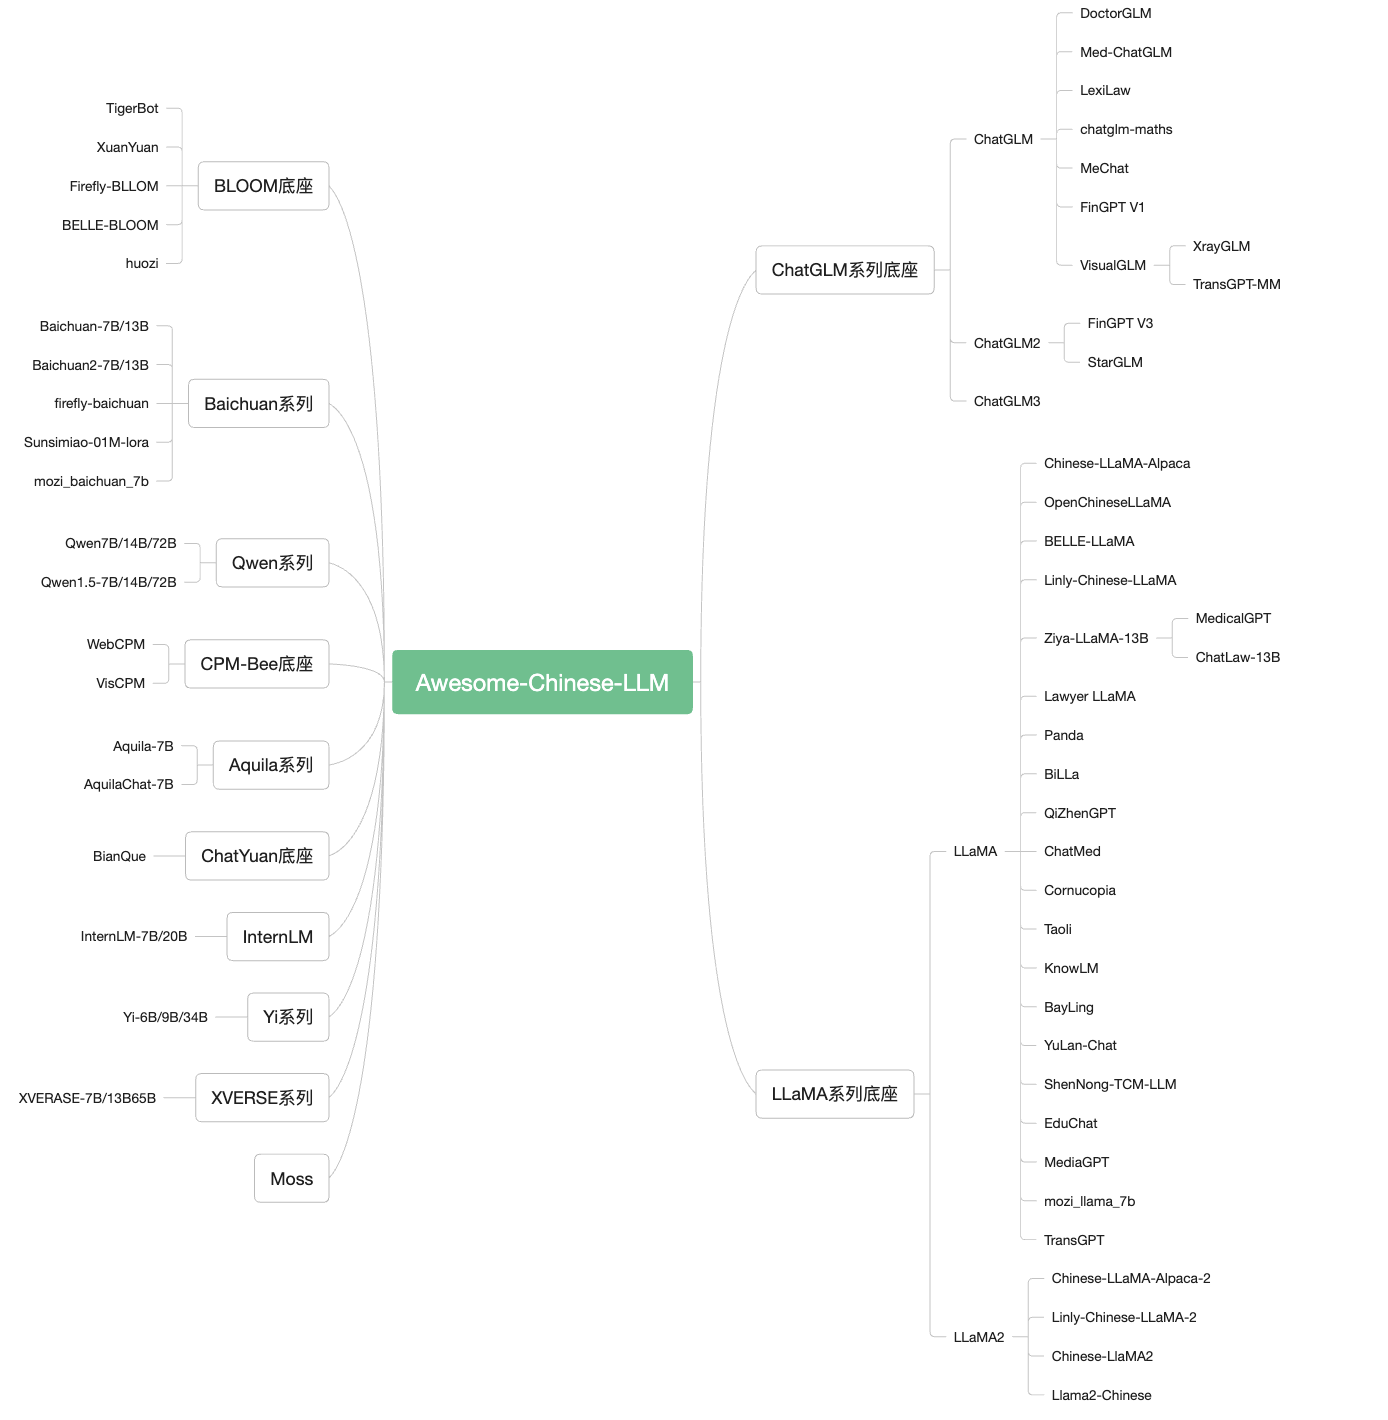
常见底座模型细节概览:
底座
包含模型
模型参数大小
训练token数
训练最大长度
是否可商用
ChatGLM
ChatGLM/2/3/4 Base&Chat
6B
1T/1.4
2K/32K
可商用
LLaMA
LLaMA/2/3 Base&Chat
7B/8B/13B/33B/70B
1T/2T
2k/4k
部分可商用
Baichuan
Baichuan/2 Base&Chat
7B/13B
1.2T/1.4T
4k
可商用
Qwen
Qwen/1.5/2/2.5 Base&Chat&VL
7B/14B/32B/72B/110B
2.2T/3T/18T
8k/32k
可商用
BLOOM
BLOOM
1B/7B/176B-MT
1.5T
2k
可商用
Aquila
Aquila/2 Base/Chat
7B/34B
-
2k
可商用
InternLM
InternLM/2/2.5 Base/Chat/VL
7B/20B
-
200k
可商用
Mixtral
Base&Chat
8x7B
-
32k
可商用
Yi
Base&Chat
6B/9B/34B
3T
200k
可商用
DeepSeek
Base&Chat
1.3B/7B/33B/67B
-
4k
可商用
XVERSE
Base&Chat
7B/13B/65B/A4.2B
2.6T/3.2T
8k/16k/256k
可商用
MiniMax
MiniMax-Text-01/VL-01
456B(45.9B activated)
-
1M/4M
可商用
目录
1.
1.1 文本LLM模型
ChatGLM:
ChatGLM2-6B
地址:https://github.com/THUDM/ChatGLM2-6B
简介:基于开源中英双语对话模型 ChatGLM-6B 的第二代版本,在保留了初代模型对话流畅、部署门槛较低等众多优秀特性的基础之上,引入了GLM 的混合目标函数,经过了 1.4T 中英标识符的预训练与人类偏好对齐训练;基座模型的上下文长度扩展到了 32K,并在对话阶段使用 8K 的上下文长度训练;基于 Multi-Query Attention 技术实现更高效的推理速度和更低的显存占用;允许商业使用。
ChatGLM3-6B
地址:https://github.com/THUDM/ChatGLM3
简介:ChatGLM3-6B 是 ChatGLM3 系列中的开源模型,在保留了前两代模型对话流畅、部署门槛低等众多优秀特性的基础上,ChatGLM3-6B 引入了如下特性:更强大的基础模型: ChatGLM3-6B 的基础模型 ChatGLM3-6B-Base 采用了更多样的训练数据、更充分的训练步数和更合理的训练策略;更完整的功能支持: ChatGLM3-6B 采用了全新设计的 Prompt 格式,除正常的多轮对话外。同时原生支持工具调用(Function Call)、代码执行(Code Interpreter)和 Agent 任务等复杂场景;更全面的开源序列: 除了对话模型 ChatGLM3-6B 外,还开源了基础模型 ChatGLM3-6B-Base、长文本对话模型 ChatGLM3-6B-32K。以上所有权重对学术研究完全开放,在填写问卷进行登记后亦允许免费商业使用。
GLM-4
地址:https://github.com/THUDM/GLM-4
简介:GLM-4-9B 是智谱 AI 推出的最新一代预训练模型 GLM-4 系列中的开源版本。 在语义、数学、推理、代码和知识等多方面的数据集测评中, GLM-4-9B 及其人类偏好对齐的版本 GLM-4-9B-Chat 均表现出超越 Llama-3-8B 的卓越性能。除了能进行多轮对话,GLM-4-9B-Chat 还具备网页浏览、代码执行、自定义工具调用(Function Call)和长文本推理(支持最大 128K 上下文)等高级功能。本代模型增加了多语言支持,支持包括日语,韩语,德语在内的 26 种语言。我们还推出了支持 1M 上下文长度(约 200 万中文字符)的 GLM-4-9B-Chat-1M 模型和基于 GLM-4-9B 的多模态模型 GLM-4V-9B。GLM-4V-9B 具备 1120 * 1120 高分辨率下的中英双语多轮对话能力,在中英文综合能力、感知推理、文字识别、图表理解等多方面多模态评测中,GLM-4V-9B 表现出超越 GPT-4-turbo-2024-04-09、Gemini 1.0 Pro、Qwen-VL-Max 和 Claude 3 Opus 的卓越性能。
Qwen/Qwen1.5/Qwen2/Qwen2.5/Qwen-3
地址:https://github.com/QwenLM
简介:通义千问是阿里云研发的通义千问大模型系列。其中,Qwen-3是阿里云通义实验室推出的Qwen系列最新一代通用大模型的开源版本,涵盖了多种不同参数规模的模型,包括17亿(1.7B)、40亿(4B)、80亿(8B)、140亿(14B)、320亿(32B)、300亿(30B)和2350亿(235B)等版本。这些模型均包含基础模型Qwen和对话模型,适用于多种应用场景。其数据集包含文本、代码等多种类型,覆盖通用领域和专业领域,支持32K的上下文长度,并针对插件调用相关对齐数据进行了特定优化。当前模型能够有效调用插件并升级为Agent,支持MCP调用。
InternLM
InternLM2
地址:https://github.com/InternLM/InternLM
简介:商汤科技、上海AI实验室联合香港中文大学、复旦大学和上海交通大学发布千亿级参数大语言模型“书生·浦语”(InternLM2)。InternLM2 在数理、代码、对话、创作等各方面能力都获得了长足进步,综合性能达到开源模型的领先水平。InternLM2 包含两种模型规格:7B 和 20B。7B 为轻量级的研究和应用提供了一个轻便但性能不俗的模型,20B 模型的综合性能更为强劲,可以有效支持更加复杂的实用场景。
DeepSeek-V2
Baichuan-7B
Baichuan-13B
Baichuan2
XVERSE-7B
地址:https://github.com/xverse-ai/XVERSE-7B
简介:由深圳元象科技自主研发的支持多语言的大语言模型,支持 8K 的上下文长度(Context Length),使用 2.6 万亿 token 的高质量、多样化的数据对模型进行充分训练,支持中、英、俄、西等 40 多种语言。并包含GGUF、GPTQ量化版本的模型,支持在llama.cpp、vLLM在MacOS/Linux/Windows系统上推理。
XVERSE-13B
地址:https://github.com/xverse-ai/XVERSE-13B
简介:由深圳元象科技自主研发的支持多语言的大语言模型,支持 8K 的上下文长度(Context Length),使用 3.2 万亿 token 的高质量、多样化的数据对模型进行充分训练,支持中、英、俄、西等 40 多种语言。包含长序列对话模型 XVERSE-13B-256K ,该版本模型最大支持 256K 的上下文窗口长度,约 25w 字的输入内容,可以协助进行文献总结、报告分析等任务。并包含GGUF、GPTQ量化版本的模型,支持在llama.cpp、vLLM在MacOS/Linux/Windows系统上推理。
XVERSE-65B
地址:https://github.com/xverse-ai/XVERSE-65B
简介:由深圳元象科技自主研发的支持多语言的大语言模型,支持 16K 的上下文长度(Context Length),使用 2.6 万亿 token 的高质量、多样化的数据对模型进行充分训练,支持中、英、俄、西等 40 多种语言。包含增量预训练到 3.2 万亿 token 的 XVERSE-65B-2 模型。并包含GGUF、GPTQ量化版本的模型,支持在llama.cpp、vLLM在MacOS/Linux/Windows系统上推理。
XVERSE-MoE-A4.2B
地址:https://github.com/xverse-ai/XVERSE-MoE-A4.2B
简介:由深圳元象科技自主研发的支持多语言的大语言模型(Large Language Model),使用混合专家模型(MoE,Mixture-of-experts)架构,模型的总参数规模为 258 亿,实际激活的参数量为 42 亿,支持 8K 的上下文长度(Context Length),使用 3.2 万亿 token 的高质量、多样化的数据对模型进行充分训练,支持中、英、俄、西等 40 多种语言。
Skywork
地址:https://github.com/SkyworkAI/Skywork
简介:该项目开源了天工系列模型,该系列模型在3.2TB高质量多语言和代码数据上进行预训练,开源了包括模型参数,训练数据,评估数据,评估方法。具体包括Skywork-13B-Base模型、Skywork-13B-Chat模型、Skywork-13B-Math模型和Skywork-13B-MM模型,以及每个模型的量化版模型,以支持用户在消费级显卡进行部署和推理。
Yi
Chinese-LLaMA-Alpaca:
Chinese-LLaMA-Alpaca-2:
Chinese-LlaMA2:
地址:https://github.com/michael-wzhu/Chinese-LlaMA2
简介:该项目基于可商用的LLaMA-2进行二次开发决定在次开展Llama 2的中文汉化工作,包括Chinese-LlaMA2: 对Llama 2进行中文预训练;第一步:先在42G中文预料上进行训练;后续将会加大训练规模;Chinese-LlaMA2-chat: 对Chinese-LlaMA2进行指令微调和多轮对话微调,以适应各种应用场景和多轮对话交互。同时我们也考虑更为快速的中文适配方案:Chinese-LlaMA2-sft-v0: 采用现有的开源中文指令微调或者是对话数据,对LlaMA-2进行直接微调 (将于近期开源)。
Llama2-Chinese:
OpenChineseLLaMA:
BELLE:
Panda:
Robin (罗宾):
Fengshenbang-LM:
BiLLa:
地址:https://github.com/Neutralzz/BiLLa
简介:该项目开源了推理能力增强的中英双语LLaMA模型。模型的主要特性有:较大提升LLaMA的中文理解能力,并尽可能减少对原始LLaMA英文能力的损伤;训练过程增加较多的任务型数据,利用ChatGPT生成解析,强化模型理解任务求解逻辑;全量参数更新,追求更好的生成效果。
Moss:
Luotuo-Chinese-LLM:
Linly:
地址:https://github.com/CVI-SZU/Linly
简介:提供中文对话模型 Linly-ChatFlow 、中文基础模型 Linly-Chinese-LLaMA 及其训练数据。 中文基础模型以 LLaMA 为底座,利用中文和中英平行增量预训练。项目汇总了目前公开的多语言指令数据,对中文模型进行了大规模指令跟随训练,实现了 Linly-ChatFlow 对话模型。
Firefly:
地址:https://github.com/yangjianxin1/Firefly
简介:Firefly(流萤) 是一个开源的中文大语言模型项目,开源包括数据、微调代码、多个基于Bloom、baichuan等微调好的模型等;支持全量参数指令微调、QLoRA低成本高效指令微调、LoRA指令微调;支持绝大部分主流的开源大模型,如百川baichuan、Ziya、Bloom、LLaMA等。持lora与base model进行权重合并,推理更便捷。
ChatYuan
ChatRWKV:
CPM-Bee
地址:https://github.com/OpenBMB/CPM-Bee
简介:一个完全开源、允许商用的百亿参数中英文基座模型。它采用Transformer自回归架构(auto-regressive),在超万亿(trillion)高质量语料上进行预训练,拥有强大的基础能力。开发者和研究者可以在CPM-Bee基座模型的基础上在各类场景进行适配来以创建特定领域的应用模型。
TigerBot
Aquila
Aquila2
地址:https://github.com/FlagAI-Open/Aquila2
简介:由智源研究院发布,Aquila2 系列,包括基础语言模型 Aquila2-7B,Aquila2-34B 和 Aquila2-70B-Expr ,对话模型 AquilaChat2-7B ,AquilaChat2-34B 和 AquilaChat2-70B-Expr,长文本对话模型AquilaChat2-7B-16k 和 AquilaChat2-34B-16。
Anima
地址:https://github.com/lyogavin/Anima
简介:由艾写科技开发的一个开源的基于QLoRA的33B中文大语言模型,该模型基于QLoRA的Guanaco 33B模型使用Chinese-Vicuna项目开放的训练数据集guanaco_belle_merge_v1.0进行finetune训练了10000个step,基于Elo rating tournament评估效果较好。
KnowLM
地址:https://github.com/zjunlp/KnowLM
简介:KnowLM项目旨在发布开源大模型框架及相应模型权重以助力减轻知识谬误问题,包括大模型的知识难更新及存在潜在的错误和偏见等。该项目一期发布了基于Llama的抽取大模型智析,使用中英文语料对LLaMA(13B)进行进一步全量预训练,并基于知识图谱转换指令技术对知识抽取任务进行优化。
BayLing
地址:https://github.com/ictnlp/BayLing
简介:一个具有增强的跨语言对齐的通用大模型,由中国科学院计算技术研究所自然语言处理团队开发。百聆(BayLing)以LLaMA为基座模型,探索了以交互式翻译任务为核心进行指令微调的方法,旨在同时完成语言间对齐以及与人类意图对齐,将LLaMA的生成能力和指令跟随能力从英语迁移到其他语言(中文)。在多语言翻译、交互翻译、通用任务、标准化考试的测评中,百聆在中文/英语中均展现出更好的表现。百聆提供了在线的内测版demo,以供大家体验。
YuLan-Chat
PolyLM
huozi
地址:https://github.com/HIT-SCIR/huozi
简介:由哈工大自然语言处理研究所多位老师和学生参与开发的一个开源可商用的大规模预训练语言模型。 该模型基于 Bloom 结构的70 亿参数模型,支持中英双语,上下文窗口长度为 2048,同时还开源了基于RLHF训练的模型以及全人工标注的16.9K中文偏好数据集。
YaYi
地址:https://github.com/wenge-research/YaYi
简介:雅意大模型在百万级人工构造的高质量领域数据上进行指令微调得到,训练数据覆盖媒体宣传、舆情分析、公共安全、金融风控、城市治理等五大领域,上百种自然语言指令任务。雅意大模型从预训练初始化权重到领域模型的迭代过程中,我们逐步增强了它的中文基础能力和领域分析能力,并增加了多轮对话和部分插件能力。同时,经过数百名用户内测过程中持续不断的人工反馈优化,进一步提升了模型性能和安全性。已开源基于 LLaMA 2 的中文优化模型版本,探索适用于中文多领域任务的最新实践。
YAYI2
地址:https://github.com/wenge-research/YAYI2
简介:YAYI 2 是中科闻歌研发的新一代开源大语言模型,包括 Base 和 Chat 版本,参数规模为 30B。YAYI2-30B 是基于 Transformer 的大语言模型,采用了超过 2 万亿 Tokens 的高质量、多语言语料进行预训练。针对通用和特定领域的应用场景,我们采用了百万级指令进行微调,同时借助人类反馈强化学习方法,以更好地使模型与人类价值观对齐。本次开源的模型为 YAYI2-30B Base 模型。
Yuan-2.0
地址:https://github.com/IEIT-Yuan/Yuan-2.0
简介:该项目开源了由浪潮信息发布的新一代基础语言大模型,具体开源了全部的3个模型源2.0-102B,源2.0-51B和源2.0-2B。并且提供了预训练,微调,推理服务的相关脚本。源2.0是在源1.0的基础上,利用更多样的高质量预训练数据和指令微调数据集,令模型在语义、数学、推理、代码、知识等不同方面具备更强的理解能力。
Chinese-Mixtral-8x7B
BlueLM
TuringMM
Orion
OrionStar-Yi-34B-Chat
MiniCPM
Mengzi3
YuLan-Mini
MiniMax-Text-01
地址:https://github.com/MiniMax-AI/MiniMax-01
简介:MiniMax-Text-01 是由 MiniMax 推出的大规模语言模型,采用混合注意力机制(Lightning Attention + Softmax Attention)与 MoE 架构,总参数量 4560 亿(456B),每个 token 激活参数量 459 亿(45.9B)。该模型在 1M tokens 上下文长度上进行训练,推理时最大可处理 4M tokens(约 800 万汉字),支持超长文本理解和生成。在 MMLU、C-SimpleQA、IFEval、Arena-Hard 等多项学术基准上表现出与 GPT-4o、DeepSeek-V3 等顶级模型相当的性能。代码采用 MIT 许可证开源,模型权重可商用。
1.2 多模态LLM模型
2.
2.1 垂直领域微调
医疗
法律
金融
Cornucopia(聚宝盆):基于中文金融知识的LLaMA微调模型
BBT-FinCUGE-Applications
XuanYuan(轩辕):首个千亿级中文金融对话模型
FinGPT
DISC-FinLLM
Tongyi-Finance
地址:https://modelscope.cn/models/TongyiFinance/Tongyi-Finance-14B
简介:该模型是针对对金融行业推出的大语言模型,基于通义千问基础模型进行行业语料增量学习,强化金融领域知识和场景应用能力,覆盖金融知识问答、文本分类、信息抽取、文本创作、阅读理解、逻辑推理、多模态、Coding等能力象限。具有以下特点:行业语料增量学习:使用200B高质量金融行业语料进行增量学习,并进行金融行业词表扩展,覆盖丰富的数据类型,支持更大上下文(16k)输入和完整的语义表达。行业能力强化:自研SFT质量&多样性分析工具,筛选高质量SFT数据,解决大语言模型的alignment问题。行业后链路优化:借助multi-agent框架,实现知识库增强和工具API调用。
LLMs Meet Finance:基于Qwen2.5和DeepSeek-R1的金融领域三阶段微调
地址:https://arxiv.org/abs/2504.13125
简介:对Qwen2.5和DeepSeek-R1基础模型进行金融领域三阶段微调(SFT任务适配→DPO抑制过长输出→LLM自合成CoT数据迭代RL),在Open FinLLM Leaderboard上取得优异成绩。使用LoRA (r=128, α=256) + DeepSpeed Stage 2训练,NER F1从0.14提升至0.72,DPO将overlength ratio从54.7%降至1.7%。
教育
桃李(Taoli):
地址:https://github.com/blcuicall/taoli
简介:一个在国际中文教育领域数据上进行了额外训练的模型。项目基于目前国际中文教育领域流通的500余册国际中文教育教材与教辅书、汉语水平考试试题以及汉语学习者词典等,构建了国际中文教育资源库,构造了共计 88000 条的高质量国际中文教育问答数据集,并利用收集到的数据对模型进行指令微调,让模型习得将知识应用到具体场景中的能力。
EduChat:
地址:https://github.com/icalk-nlp/EduChat
简介:该项目华东师范大学计算机科学与技术学院的EduNLP团队研发,主要研究以预训练大模型为基底的教育对话大模型相关技术,融合多样化的教育垂直领域数据,辅以指令微调、价值观对齐等方法,提供教育场景下自动出题、作业批改、情感支持、课程辅导、高考咨询等丰富功能,服务于广大老师、学生和家长群体,助力实现因材施教、公平公正、富有温度的智能教育。
chatglm-maths:
MathGLM:
QiaoBan:
科技
天文大语言模型StarGLM:
TransGPT·致远:
Mozi:
电商
网络安全
农业
后稷(AgriMa):
稷丰(AgriAgent):
2.2 LangChain应用
2.3 其他应用
Lumen:
wenda:
JittorLLMs:
LMFlow:
地址:https://github.com/OptimalScale/LMFlow
简介:LMFlow是香港科技大学LMFlow团队开发的大模型微调工具箱。LMFlow工具箱具有可扩展性强、高效、方便的特性。LMFlow仅使用180K条数据微调,即可得到在Huggingface榜单第一名的Robin模型。LMFlow支持用户快速训练个性化模型,仅需单张3090和5个小时即可微调70亿参数定制化模型。
fastllm:
WebCPM
GPT Academic:
ChatALL:
CreativeChatGLM:
docker-llama2-chat:
ChatGLM2-Voice-Cloning:
Flappy
LazyLLM
地址:https://github.com/LazyAGI/LazyLLM
简介:LazyLLM是一款低代码构建多Agent大模型应用的开发工具,协助开发者用极低的成本构建复杂的AI应用,并可以持续的迭代优化效果。LazyLLM提供了更为灵活的应用功能定制方式,并实现了一套轻量级网管机制来支持一键部署多Agent应用,支持流式输出,兼容多个Iaas平台,且支持对应用中的模型进行持续微调。
MemFree
地址:https://github.com/memfreeme/memfree
简介:MemFree 是一个开源的 Hybrid AI 搜索引擎,可以同时对您的个人知识库(如书签、笔记、文档等)和互联网进行搜索, 为你提供最佳答案。MemFree 支持自托管的极速无服务器向量数据库,支持自托管的极速Local Embedding and Rerank Service,支持一键部署。
3.
预训练数据集
MNBVC
地址:https://github.com/esbatmop/MNBVC
数据集说明:超大规模中文语料集,不但包括主流文化,也包括各个小众文化甚至火星文的数据。MNBVC数据集包括新闻、作文、小说、书籍、杂志、论文、台词、帖子、wiki、古诗、歌词、商品介绍、笑话、糗事、聊天记录等一切形式的纯文本中文数据。数据均来源于互联网收集,且在持续更新中。
WuDaoCorporaText
CLUECorpus2020
WanJuan-1.0
地址:https://opendatalab.org.cn/WanJuan1.0
数据集说明:书生·万卷1.0为书生·万卷多模态语料库的首个开源版本,包含文本数据集、图文数据集、视频数据集三部分,数据总量超过2TB。 目前,书生·万卷1.0已被应用于书生·多模态、书生·浦语的训练。通过对高质量语料的“消化”,书生系列模型在语义理解、知识问答、视觉理解、视觉问答等各类生成式任务表现出的优异性能。
seq-monkey-data
SFT数据集
RefGPT:基于RefGPT生成大量真实和定制的对话数据集
COIG
generated_chat_0.4M:
Chinese-DeepSeek-R1-Distill-data-110k:
alpaca_chinese_dataset:
Alpaca-CoT:
pCLUE:
firefly-train-1.1M:
BELLE-data-1.5M:
Chinese Scientific Literature Dataset:
Chinese medical dialogue data:
Huatuo-26M:
Alpaca-GPT-4:
InstructionWild
ShareChat
地址:https://paratranz.cn/projects/6725
数据集说明:一个倡议大家一起翻译高质量 ShareGPT 数据的项目。
项目介绍:清洗/构造/翻译中文的ChatGPT数据,推进国内AI的发展,人人可炼优质中文 Chat 模型。本数据集为ChatGPT约九万个对话数据,由ShareGPT API获得(英文68000,中文11000条,其他各国语言)。项目所有数据最终将以 CC0 协议并入 Multilingual Share GPT 语料库。
Guanaco
chatgpt-corpus
SmileConv
地址:https://github.com/qiuhuachuan/smile
数据集说明:数据集通过ChatGPT改写真实的心理互助 QA为多轮的心理健康支持多轮对话(single-turn to multi-turn inclusive language expansion via ChatGPT),该数据集含有56k个多轮对话,其对话主题、词汇和篇章语义更加丰富多样,更加符合在长程多轮对话的应用场景。
偏好数据集
4. LLM训练微调框架
5. LLM推理部署框架
6.
FlagEval (天秤)大模型评测体系及开放平台
地址:https://github.com/FlagOpen/FlagEval
简介:旨在建立科学、公正、开放的评测基准、方法、工具集,协助研究人员全方位评估基础模型及训练算法的性能,同时探索利用AI方法实现对主观评测的辅助,大幅提升评测的效率和客观性。FlagEval (天秤)创新构建了“能力-任务-指标”三维评测框架,细粒度刻画基础模型的认知能力边界,可视化呈现评测结果。
C-Eval: 构造中文大模型的知识评估基准:
OpenCompass:
地址:https://github.com/InternLM/opencompass
简介:由上海AI实验室发布的面向大模型评测的一站式平台。主要特点包括:开源可复现;全面的能力维度:五大维度设计,提供 50+ 个数据集约 30 万题的的模型评测方案;丰富的模型支持:已支持 20+ HuggingFace 及 API 模型;分布式高效评测:一行命令实现任务分割和分布式评测,数小时即可完成千亿模型全量评测;多样化评测范式:支持零样本、小样本及思维链评测,结合标准型或对话型提示词模板;灵活化拓展。
SuperCLUElyb: SuperCLUE琅琊榜
GAOKAO-Bench:
AGIEval:
Xiezhi:
Open LLM Leaderboard:
CMMLU:
地址:https://github.com/haonan-li/CMMLU
简介:CMMLU是一个综合性的中文评估基准,专门用于评估语言模型在中文语境下的知识和推理能力。CMMLU涵盖了从基础学科到高级专业水平的67个主题。它包括:需要计算和推理的自然科学,需要知识的人文科学和社会科学,以及需要生活常识的中国驾驶规则等。此外,CMMLU中的许多任务具有中国特定的答案,可能在其他地区或语言中并不普遍适用。因此是一个完全中国化的中文测试基准。
MMCU:
chinese-llm-benchmark:
Safety-Prompts:
PromptCBLUE: 中文医疗场景的LLM评测基准
HalluQA: 中文幻觉评估基准
地址:https://github.com/xiami2019/HalluQA
简介:该项目提出了一个名为HalluQA的基准测试,用于衡量中文大型语言模型中的幻觉现象。HalluQA包含450个精心设计的对抗性问题,涵盖多个领域,并考虑了中国历史文化、风俗和社会现象。在构建HalluQA时,考虑了两种类型的幻觉:模仿性虚假和事实错误,并基于GLM-130B和ChatGPT构建对抗性样本。为了评估,设计了一种使用GPT-4进行自动评估的方法,判断模型输出是否是幻觉。
7.
LLM基础知识
HuggingLLM:
LLMsPracticalGuide:
提示工程教程
LLM应用教程
LLM实战教程
LLMs九层妖塔:
llm-action:
llm大模型训练专栏:
书生·浦语大模型实战营
8.
FindTheChatGPTer:
LLM_reviewer:
Awesome-AITools:
open source ChatGPT and beyond:
地址:https://github.com/SunLemuria/open_source_chatgpt_list
简介:This repo aims at recording open source ChatGPT, and providing an overview of how to get involved, including: base models, technologies, data, domain models, training pipelines, speed up techniques, multi-language, multi-modal, and more to go.
Awesome Totally Open Chatgpt:
Awesome-LLM:
地址:https://github.com/Hannibal046/Awesome-LLM
简介:This repo is a curated list of papers about large language models, especially relating to ChatGPT. It also contains frameworks for LLM training, tools to deploy LLM, courses and tutorials about LLM and all publicly available LLM checkpoints and APIs.
DecryptPrompt:
Awesome Pretrained Chinese NLP Models:
ChatPiXiu:
LLM-Zoo:
LLMs-In-China:
BMList:
awesome-free-chatgpt:
Awesome-Domain-LLM:
Awesome AI Startups:
Star History





 Тщательно подобранная коллекция open-source ресурсов по LLM для китайского языка, с упором на модели поменьше, которые можно развернуть у себя и дёшево дообучить. В ней собрано более 100 ресурсов: модели, приложения, датасеты и туториалы.