
darwin-skill README

The project's README from github.com/alchaincyf/darwin-skill. As one markdown file: README.md.

English | 中文

达尔文.skill

Darwin Skill Animation
动画由 huashu-design skill 制作

达尔文.skill 2.0

像训练模型一样优化你的 Agent Skills。

受 Andrej Karpathy 的 autoresearch 启发,将自主实验循环从模型训练搬到 Skill 优化领域。一个只能向前转的棘轮。

v2.0 · 更新于 2026-05-28 · 吸收微软研究院 SkillLens 与 SkillOpt 两篇论文做的系统性升级。

License: MIT Version Agent Skill Skills Microsoft SkillOpt

npx skills add alchaincyf/darwin-skill

[!NOTE] 🤝 微软研究院把达尔文列进了 SkillOpt 的官方集成名单。 2026-06-03,微软在 SkillOpt 仓库 的更新里写道: 「gbrain, gbrain-evals, and darwin-skill have all integrated SkillOpt.」 我们吸收了它的 validation-gated 框架,它把达尔文写进了自己的集成名单。这是一次双向的致意。👉 去 SkillOpt 仓库看看


What's New in 2.0

2.0 不是缝缝补补,是系统性吸收微软研究院 2026-05-22 两篇论文后的结构性升级。五个变化:

1. 评分标准 8 维 → 9 维(吸收 SkillLens 实证的 73.8% rubric 药方)

2. 验证机制对齐 SkillOpt 的 validation-gated 设计

3. Human in the Loop 三层守关(达尔文区别于 SkillOpt 全自动设计的核心)

4. 反例黑名单 8 条(明文禁止的反模式)

  1. 同一个 AI 又改又评(SkillLens 实证:LLM 自评准确率仅 46.4%)
  2. 用 git reset --hard 当回滚手段(应用 git revert)
  3. 为凑分而堆冗余
  4. 跳过测试提示词直接评分
  5. 一轮内改多个维度
  6. 干跑比例 > 30%
  7. 静默跳过异常
  8. 忽视维度相关簇

5. 实测验证数据


核心循环

Core Loop


为什么做这个

Agent Skill 生态在快速扩张。Claude Code、Codex、OpenClaw、Trae、CodeBuddy 等工具都支持 SKILL.md 格式。当你有 10 个 Skills 时可以手动维护;当你有 60+ 个 Skills 时,你需要一个系统。

传统的 Skill 审查是纯结构性的:检查格式对不对、步骤有没有编号、路径能不能访问。但一个格式完美的 Skill,跑出来的效果可能很差。

达尔文.skill 同时评估结构质量和实际效果,然后只保留真正有改进的修改。


从 autoresearch 到 Skill Optimizer

这个项目直接受 Karpathy autoresearch 启发。autoresearch 的做法是:写一个 program.md 定义目标和约束,让 agent 自主生成和测试代码变更,只保留可测量的改进。

我们把同样的思路搬到了 Skill 优化:

autoresearch 达尔文.skill 为什么这样映射
program.md 本 SKILL.md 定义评估标准和约束规则
train.py 每个待优化的 SKILL.md 被优化的资产,每次实验只改它
val_bpb 9 维加权总分(满分 100) 可量化的优化目标
git ratchet keep / revert 机制 只保留有改进的 commit
test set test-prompts.json 验证改进是否真的有效
全自主运行 人在回路 Skill 的好坏比 loss 更微妙,需要人的判断

五条核心原则

# 原则 说明
01 单一可编辑资产 每次只改一个 SKILL.md,变量可控,改进可归因
02 双重评估 结构评分(静态分析)+ 效果验证(跑测试看输出)
03 棘轮机制 只保留改进,自动回滚退步,分数只升不降
04 独立评分 评分用子 agent,避免「自己改自己评」的偏差(SkillLens 实证 LLM 自评仅 46.4% 准确率)
05 人在回路 每个 Skill 优化完后暂停,用户确认再继续下一个

9 维度评估体系

总分 100。结构维度靠静态分析,效果维度必须实测。v2.0 新增三个维度直接来自 SkillLens 论文的实证 rubric。

Evaluation Rubric

新增的三个维度(SkillLens 73.8% rubric 药方):

维度 说明
失败模式编码 显式编码已知失败路径,不是简单「别犯错」式叮嘱
可执行具体性 禁用「建议/可以考虑/根据情况/灵活把握/视情况而定」等模糊措辞
高风险行动黑名单 rm / git reset --hard / force push 等破坏性操作必须明文列禁

实测表现权重最高。Skill 写得再漂亮,跑出来效果不好就是零。


优化循环:5 个阶段

系统在每个阶段内自主运行,但在阶段之间暂停等待人类确认。

Optimization Lifecycle

Phase 2 的核心逻辑(v2.0 强化):

  1. 找出加权短板最大的维度(weighted_gap = weight × (10 − score) / 10,避免低权重维度制造进步幻觉)
  2. 针对该维度生成 1 个具体改进方案(一轮只改一个维度,反例黑名单第 5 条)
  3. 编辑 SKILL.md,git commit
  4. 启动 2 个独立子 agent 重新评分(下一轮换全新评委,避免锚定)
  5. 新分高于旧分 → 保留;否则 → git revert(禁用 git reset --hard,反例黑名单第 2 条)
  6. 单轮涨幅 < 1 分 → 自动早停(避免凑分堆冗余)
  7. 🔴 CHECKPOINT 暂停,展示 diff + 分数变化,等用户确认

棘轮机制

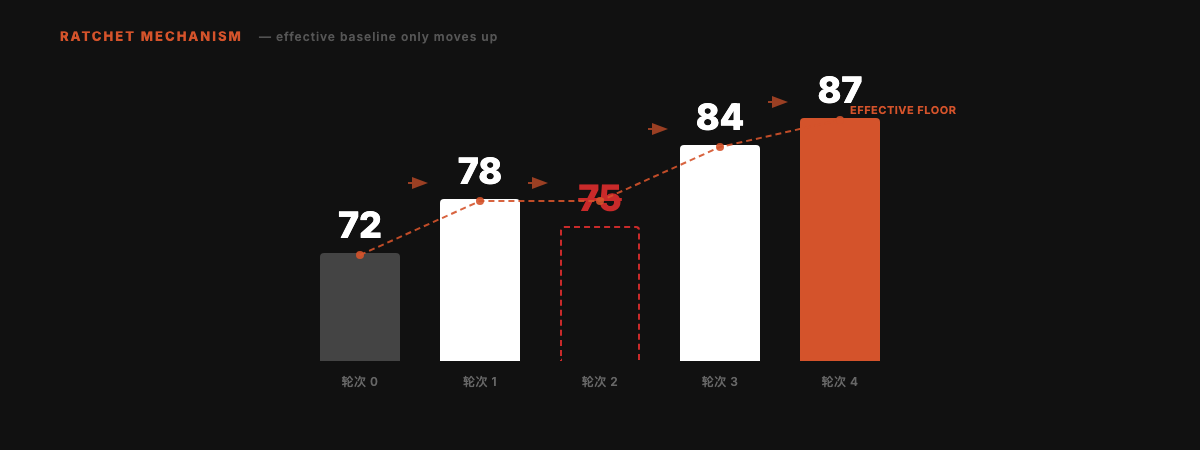
分数只能上升。每一轮要么改进 Skill,要么干净地回滚。不会随时间积累局部退化。

Ratchet Mechanism

轮次 2 的 75 分低于当前最优的 78 分,被自动回滚。有效基线始终锁定在 78,后续改进从 78 继续。


快速开始

npx skills add alchaincyf/darwin-skill

安装后在任何支持 Skill 的 Agent 工具中说「优化所有skills」或「优化某个skill」就行。

无法访问 GitHub 的朋友,可以直接下载 zip 包:darwin-skill.zip,解压后把 SKILL.md 放到 ~/.claude/skills/darwin-skill/ 目录即可。

安全提示:


设计灵感

这个项目的设计直接受 Andrej Karpathy 的 autoresearch 启发。

核心机制完全相同:只保留可测量的改进,其余全部回滚。

v2.0 在此基础上吸收了微软研究院 2026-05-22 发布的两篇论文:SkillLens 提供了实证验证的 rubric 设计,SkillOpt 提供了 validation-gated edits 的形式化框架。


References & Credits

v2.0 的设计直接基于以下学术工作。强烈推荐 skill 生态的研究者和工程师阅读:

SkillLens

Microsoft Research. From Raw Experience to Skill Consumption: A Systematic Study of Model-Generated Agent Skills. arXiv:2605.23899, 2026.

SkillOpt

Microsoft Research. SkillOpt: Executive Strategy for Self-Evolving Agent Skills. arXiv:2605.23904, 2026.

autoresearch

Andrej Karpathy. autoresearch. GitHub repository, 2026.

达尔文 vs SkillOpt 的关键区别:SkillOpt 是全自主系统,达尔文.skill 强调 human-in-the-loop——Skill 的好坏比 validation loss 更微妙,关键阶段(基线评估、单维度优化、回归测试)强制暂停,让人来做最终判断。


关于作者

🌐 官网 bookai.top · huasheng.ai
𝕏 Twitter @AlchainHust
📺 B站 花叔
▶️ YouTube @Alchain
📕 小红书 花叔
💬 公众号 微信搜「花叔」

许可证

MIT


女娲 造 Skill。
达尔文 让 Skill 进化。

只保留改进,时间就站在你这边。


MIT License © 花叔 Huashu


作者的其他项目 · also by 花叔

FanBox · Coding Agent 的驾驶舱

darwin-skill (alchaincyf/darwin-skill)

Searching Database…

这是什么?Darwin.skill 是一个通过自动化的“评估—改进—测试—保留或回退”循环来进化 Claude Code Agent Skills 的系统,灵感来自 Andrej Karpathy 的 autoresearch 项目。
这是独立工具,还是放进 Claude Code 的技能文件?它本身就是一个 SKILL.md,编写用于在 Claude Code 以及其他支持 SKILL.md 格式的工具(Codex、OpenClaw、Trae、CodeBuddy)中运行,教代理如何为其他技能打分并优化。
怎么用它开始优化一个技能?在 Claude Code 中把 darwin-skill 作为 Skill 加载,指定一个目标 SKILL.md,它会依次进行基线打分、结合 git 提交的单维度修改和回归测试,每个阶段结束后暂停等待你确认。
运行它需要什么条件?你只需要一个支持 SKILL.md 格式的代理工具和 git,因为优化循环是通过 git 提交和回退来编辑目标技能文件的。
它是全自动运行的吗?不是——它刻意采用人机协同设计:每次单维度优化后会强制出现 CHECKPOINT 暂停,若分数提升低于阈值则触发 STOP,这与 SkillOpt 的全自动设计不同。
它为技能打分的 9 个评估维度是什么?技能会在 9 个维度上获得满分 100 的加权评分,v2.0 新增了失败机制编码、可操作性具体度,以及基于微软 SkillLens 研究的高风险操作黑名单。
为什么要人机协同,而不是像 SkillOpt 那样全自动?作者认为技能质量比训练损失更主观,因此基线审查、每个维度的修改和回归测试都会强制设置人工检查点,而不是无人值守地运行。
它明确禁止哪些反模式?共有八种被禁止的模式,包括让同一个 AI 既修改又给技能打分(据 SkillLens 统计,LLM 自评准确率仅 46.4%)、用 'git reset --hard' 做回滚,以及用冗余内容刷分。
有没有真实数据证明优化确实有效?有——在 huashu-gpt-image 技能上,分数经过几轮从 80.8 提升到 91.5 再到 91.65,并经独立评估者一致确认;项目自身的自评分也从 86.05 提升到 92.7。
Creator
alchaincyf
Size
4.4 MB
Stars
6.4K
Updated
CommitSep 18
Age
6mo
Commits · 90 Days