1.5K ·GitHub
Что это такое?
 Набор навыков (skills) для агентов, которые помогают AI-агентам для кодинга создавать AI-оценки под конкретный продукт — а не бенчмарки базовых моделей. В них заложены ошибки, которые авторы видели более чем в 50 компаниях и у тысяч студентов на своём курсе AI Evals.
То есть это инструмент, который я запускаю сам, или инструкции, которым следует мой агент для кодинга?Это не приложение — это набор навыков, которые ваш AI-агент для кодинга загружает и выполняет. 'evals-start' — входная точка: она оценивает вашу ситуацию и направляет вас к нужному навыку.
Это не приложение — это набор навыков, которые ваш AI-агент для кодинга загружает и выполняет. 'evals-start' — входная точка: она оценивает вашу ситуацию и направляет вас к нужному навыку.Как установить эти навыки?Выполните 'npx skills', чтобы установить их в ваш агент для кодинга. Можно установить и всего один навык, а проверять обновления — отдельными командами.
Выполните 'npx skills', чтобы установить их в ваш агент для кодинга. Можно установить и всего один навык, а проверять обновления — отдельными командами.Нужно ли устанавливать что-то ещё, кроме агента для кодинга?Нет — достаточно вашего существующего AI-агента для кодинга. Единственный компонент времени выполнения — сгенерированное error-discovery приложение для ревью: одностраничный HTML-файл, который раздаётся сервером из стандартной библиотеки Python без каких-либо зависимостей.
Нет — достаточно вашего существующего AI-агента для кодинга. Единственный компонент времени выполнения — сгенерированное error-discovery приложение для ревью: одностраничный HTML-файл, который раздаётся сервером из стандартной библиотеки Python без каких-либо зависимостей.Какие части работы с оценками эти навыки не охватывают?Только то, что универсально для любых проектов. Продакшн-мониторинг, регрессионные наборы для CI/CD и оптимизация затрат явно выходят за рамки — их разбирает курс AI Evals от этой команды.
Только то, что универсально для любых проектов. Продакшн-мониторинг, регрессионные наборы для CI/CD и оптимизация затрат явно выходят за рамки — их разбирает курс AI Evals от этой команды.Я делаю AI-продукт, но никогда не занимался оценками — с чего начать?Эти навыки рассчитаны на разработчиков, которые строят оценки для своего продукта, и в них заложены ошибки из опыта работы более чем с 50 компаниями и обучения тысяч студентов. evals-start направит вас к eval-audit, если пайплайн оценок у вас уже есть, или к error-discovery, если у вас есть неразобранные трейсы.
Эти навыки рассчитаны на разработчиков, которые строят оценки для своего продукта, и в них заложены ошибки из опыта работы более чем с 50 компаниями и обучения тысяч студентов. evals-start направит вас к eval-audit, если пайплайн оценок у вас уже есть, или к error-discovery, если у вас есть неразобранные трейсы.Какие навыки входят в набор?Восемь: evals-start (входная точка, которая вас маршрутизирует), eval-audit (проверяет существующий пайплайн оценок и помечает проблемы по серьёзности), error-discovery (создаёт приложение для ревью и раскладывает трейсы по типам сбоев), generate-synthetic-data (генерация кортежей по измерениям), write-judge-prompt (проектирует LLM-as-Judge оценщики), validate-evaluator (калибрует судей по человеческим разметкам с учётом TPR/TNR и поправки на смещение), evaluate-rag (качество поиска и генерации) и build-review-interface (кастомные интерфейсы для разметки).
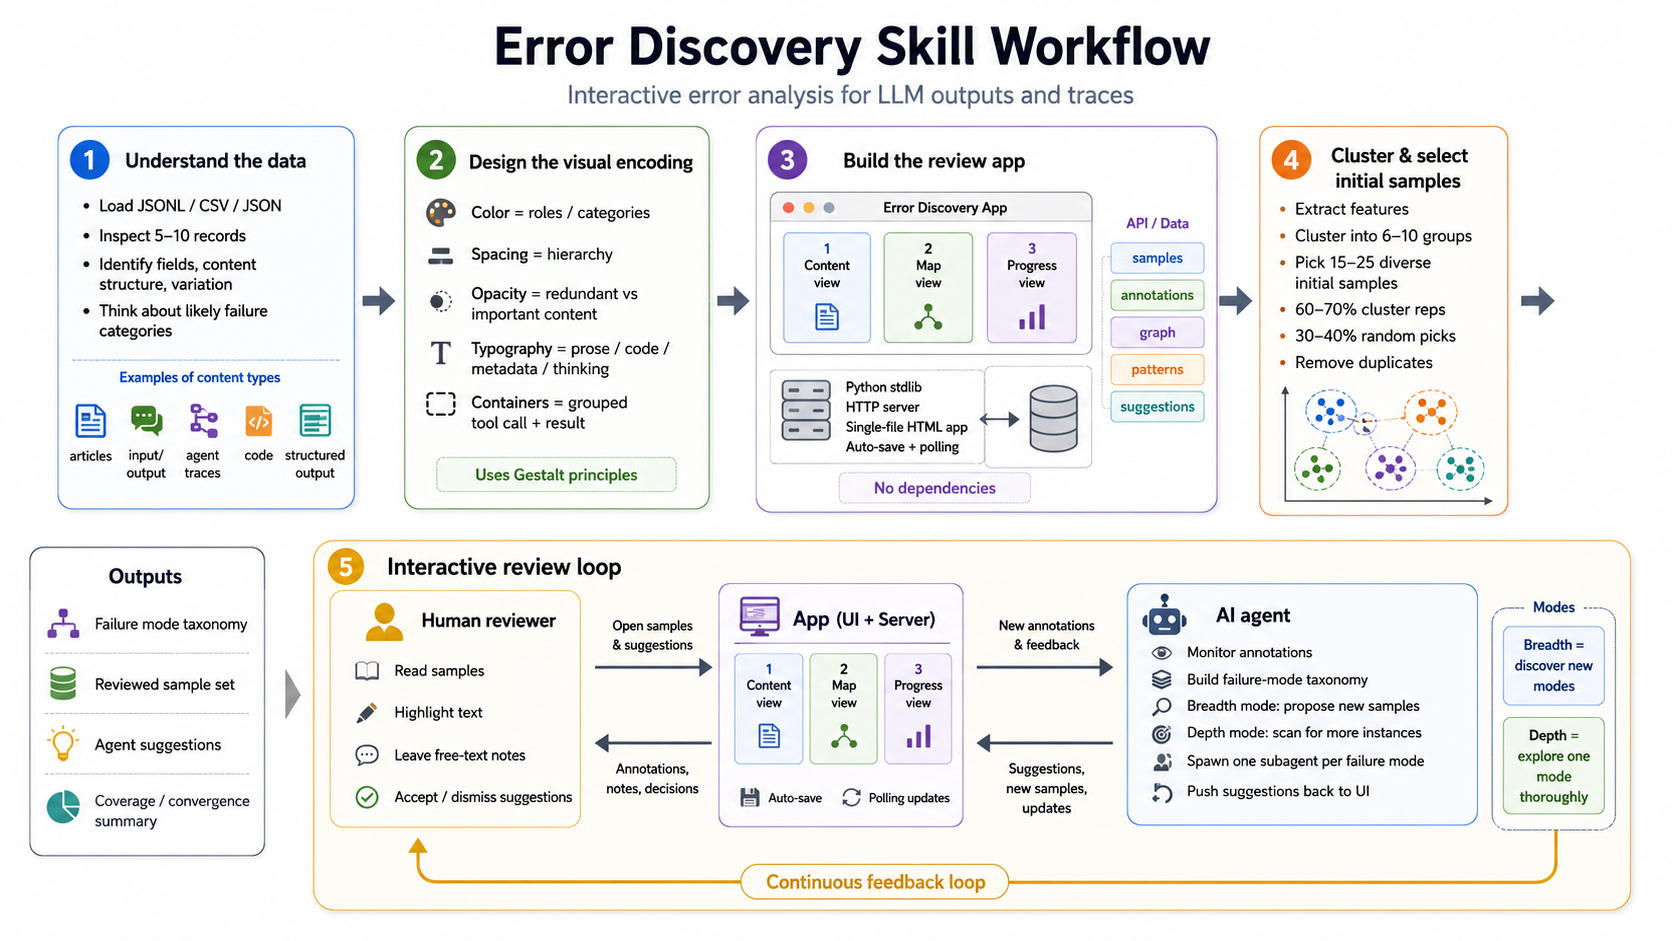
Восемь: evals-start (входная точка, которая вас маршрутизирует), eval-audit (проверяет существующий пайплайн оценок и помечает проблемы по серьёзности), error-discovery (создаёт приложение для ревью и раскладывает трейсы по типам сбоев), generate-synthetic-data (генерация кортежей по измерениям), write-judge-prompt (проектирует LLM-as-Judge оценщики), validate-evaluator (калибрует судей по человеческим разметкам с учётом TPR/TNR и поправки на смещение), evaluate-rag (качество поиска и генерации) и build-review-interface (кастомные интерфейсы для разметки).Почему error-discovery называют самым важным навыком?Потому что оценками стоит заниматься только после анализа ошибок. Вы указываете ему на JSONL/CSV/JSON-файл с выводами или трейсами LLM: он создаёт приложение для ревью, кластеризует данные и отбирает разнообразную выборку, а затем запускает интерактивный цикл — ваши заметки в свободной форме раскладываются по типам сбоев, пока он подбирает новые примеры, чтобы закрыть пробелы в покрытии.
Потому что оценками стоит заниматься только после анализа ошибок. Вы указываете ему на JSONL/CSV/JSON-файл с выводами или трейсами LLM: он создаёт приложение для ревью, кластеризует данные и отбирает разнообразную выборку, а затем запускает интерактивный цикл — ваши заметки в свободной форме раскладываются по типам сбоев, пока он подбирает новые примеры, чтобы закрыть пробелы в покрытии.Почему навыки, а не просто гайд по оценкам?В оценках легко наступить на одни и те же грабли. Навыки кодируют типичные ошибки, с которыми команда курса AI Evals сталкивалась, помогая более чем 50 компаниям, — так ваш агент обходит их стороной, строя оценки именно для вашего продукта.
В оценках легко наступить на одни и те же грабли. Навыки кодируют типичные ошибки, с которыми команда курса AI Evals сталкивалась, помогая более чем 50 компаниям, — так ваш агент обходит их стороной, строя оценки именно для вашего продукта.Могу ли я написать свои навыки для оценок?Да, и авторы это только приветствуют: эти навыки покрывают лишь то, что универсально для любых проектов, а навыки, опирающиеся на ваши собственные данные и предметную область, будут работать лучше. Хорошая отправная точка — writing-for-ai-agents от Matt Pocock.
Да, и авторы это только приветствуют: эти навыки покрывают лишь то, что универсально для любых проектов, а навыки, опирающиеся на ваши собственные данные и предметную область, будут работать лучше. Хорошая отправная точка — writing-for-ai-agents от Matt Pocock.What are similar projects?skills, SwiftUI-Agent-Skill, ruflo, jev-align, claude-plugins-official, superpowers-zh, Coding-Agent-Skills, compound-engineering-plugin
skills, SwiftUI-Agent-Skill, ruflo, jev-align, claude-plugins-official, superpowers-zh, Coding-Agent-Skills, compound-engineering-pluginWhich topics is it in?annotation-tool, ai-skills, claude-plugin, annotation, llm-evaluation, human-in-the-loop, best-practices, evaluation, prompt-engineering, rag, skills, testing
annotation-tool, ai-skills, claude-plugin, annotation, llm-evaluation, human-in-the-loop, best-practices, evaluation, prompt-engineering, rag, skills, testing