

What is this?
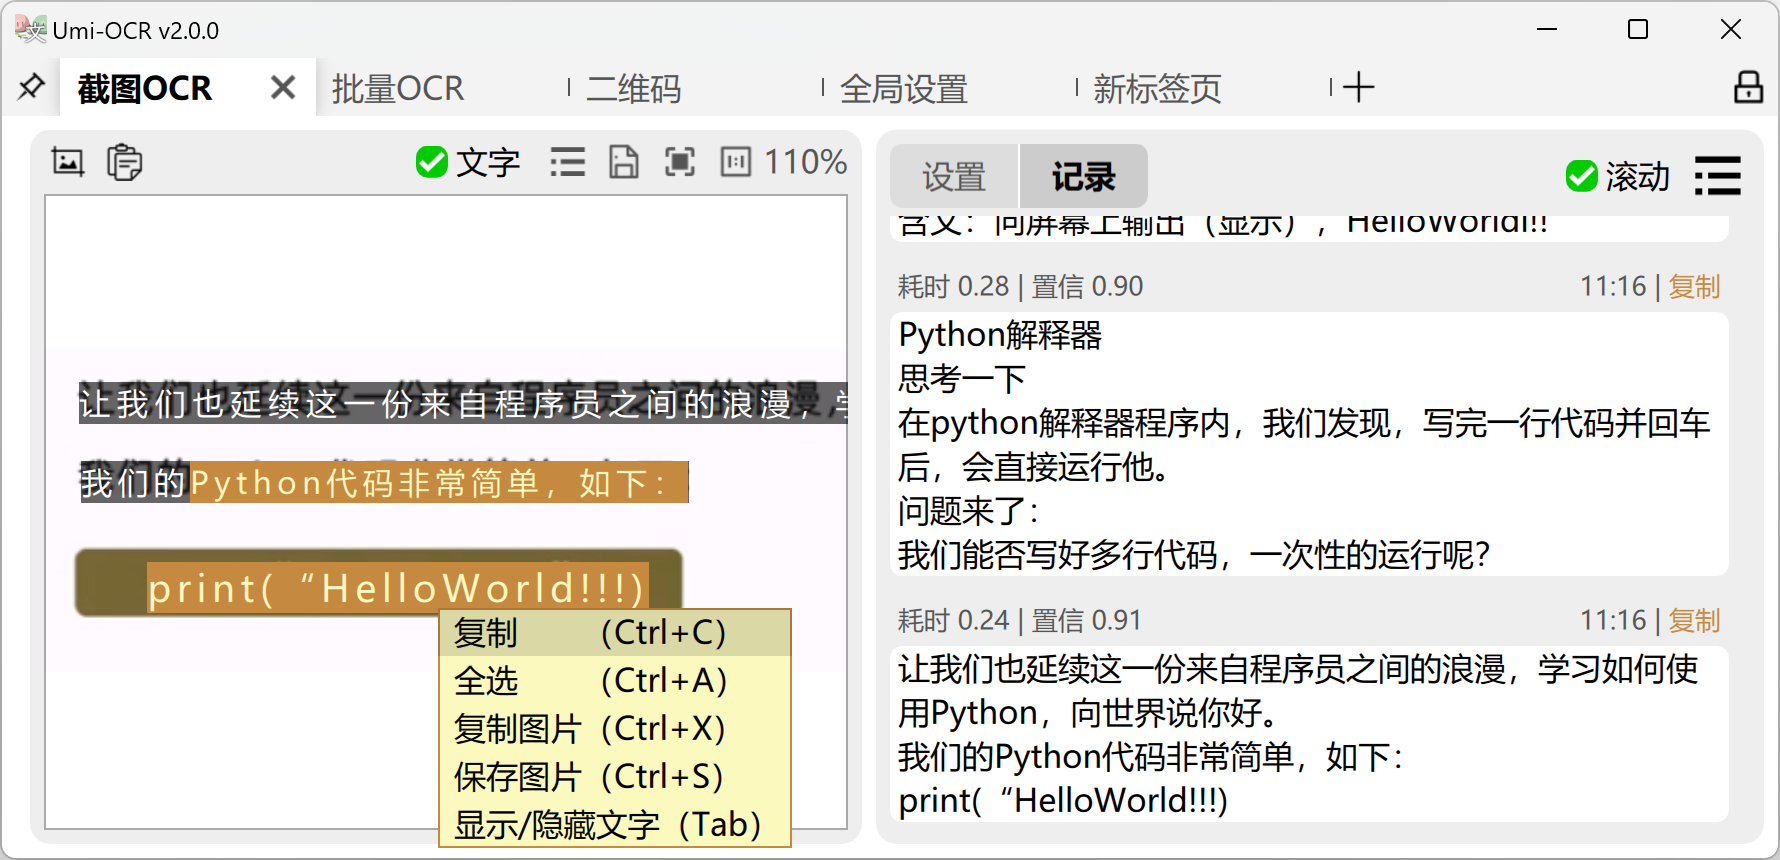
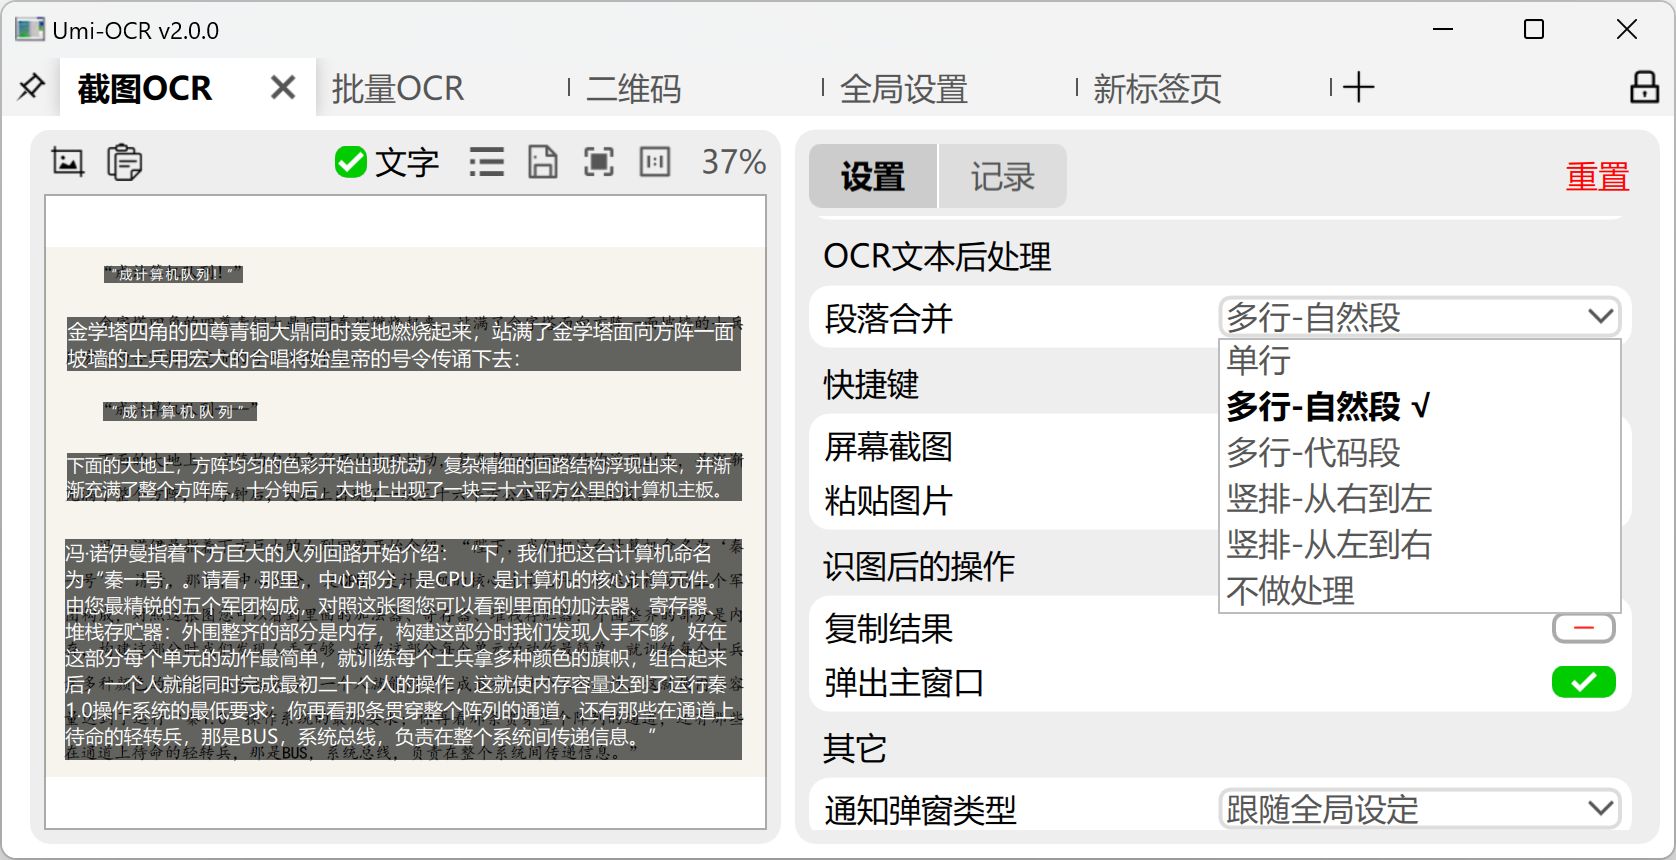
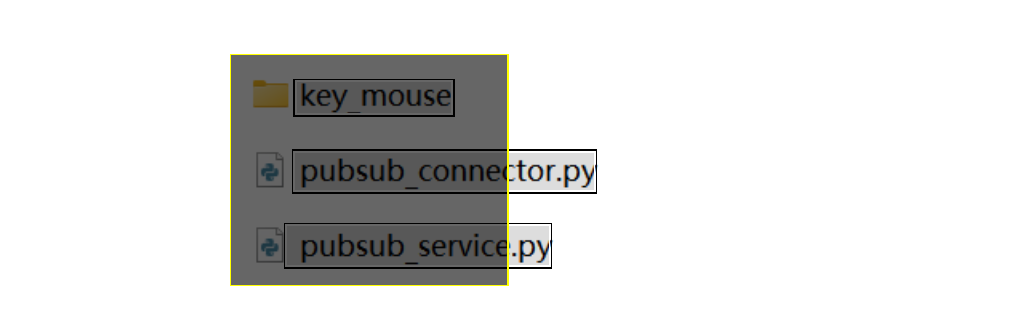
 Umi-OCR is a free, open-source, offline OCR tool that extracts text from screenshots, batches of images, and PDF documents, and can also scan or generate QR codes.
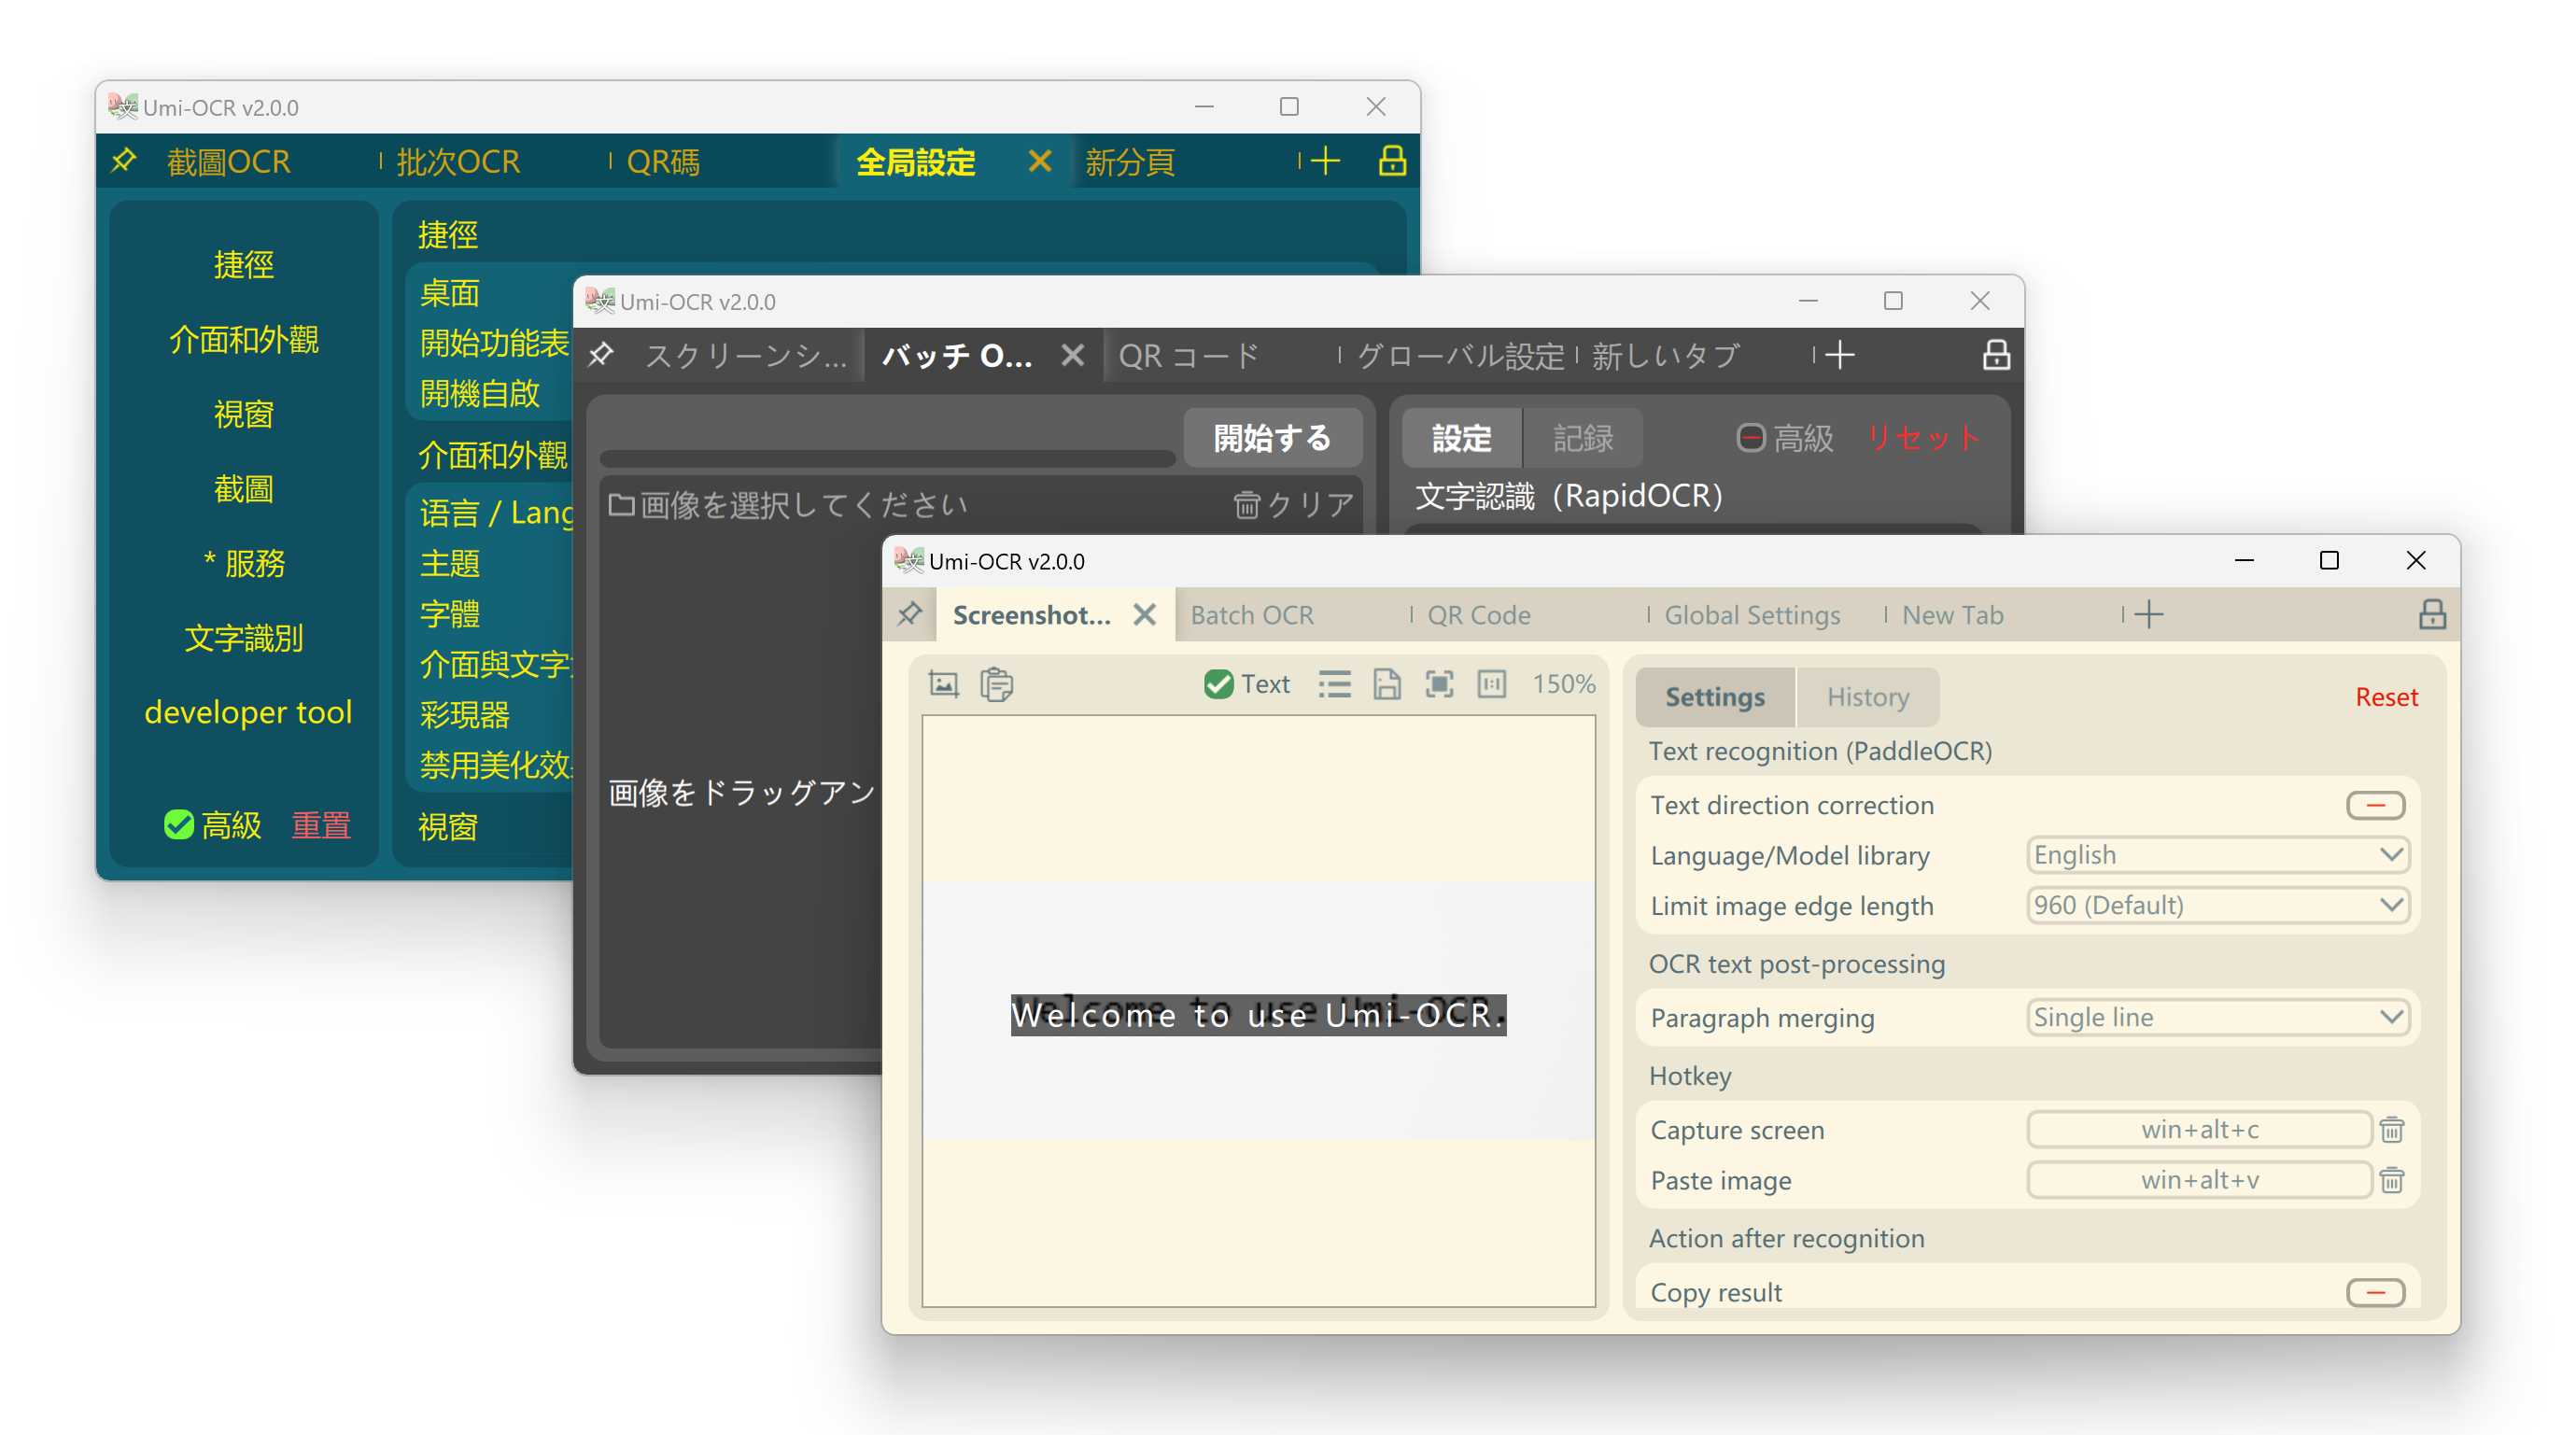
Is this a desktop app, or just a command-line tool?It is mainly a desktop GUI app built with Qt/QML, but it also exposes a command-line mode and an HTTP interface for external calls.
It is mainly a desktop GUI app built with Qt/QML, but it also exposes a command-line mode and an HTTP interface for external calls.How do I get it running?Download the .7z release archive (or self-extracting .7z.exe), extract it, and launch Umi-OCR.exe — no installer needed. Windows users can alternatively install it with Scoop.
Download the .7z release archive (or self-extracting .7z.exe), extract it, and launch Umi-OCR.exe — no installer needed. Windows users can alternatively install it with Scoop.Do I need to install an OCR engine or Python separately?No — it bundles its own offline OCR engines (PaddleOCR-json or RapidOCR-json) and includes multiple language models, so nothing extra needs to be installed.
No — it bundles its own offline OCR engines (PaddleOCR-json or RapidOCR-json) and includes multiple language models, so nothing extra needs to be installed.Does it run on macOS?Not yet — official builds only cover Windows7 x64 and Linux x64; macOS/Ubuntu support is listed as a future development goal, not a current feature.
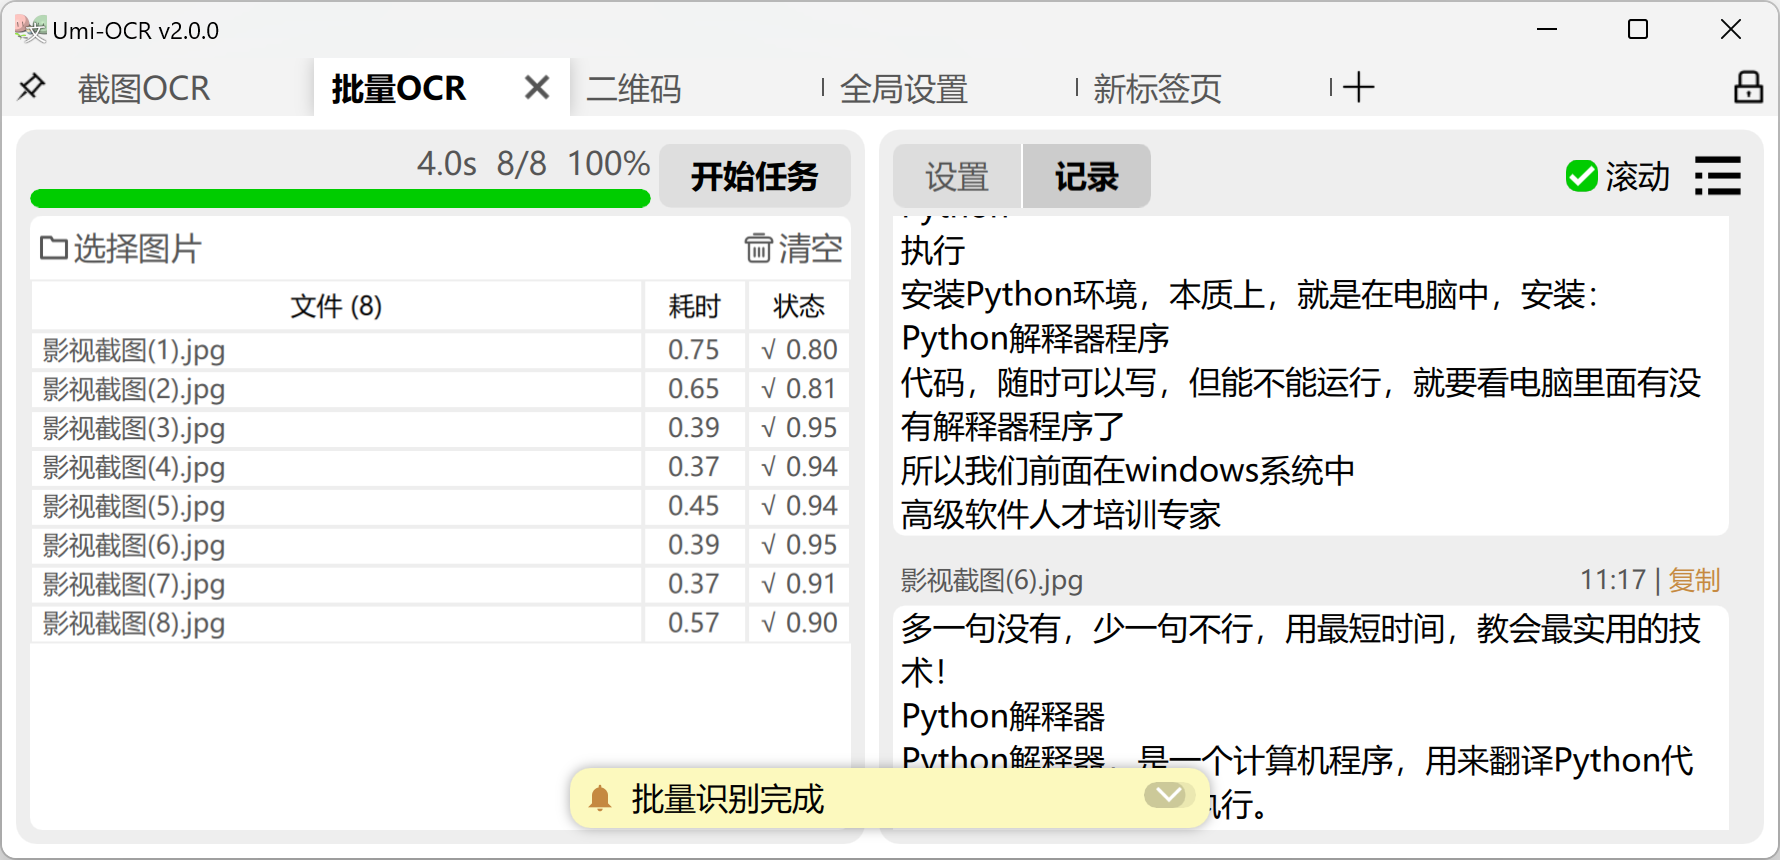
Not yet — official builds only cover Windows7 x64 and Linux x64; macOS/Ubuntu support is listed as a future development goal, not a current feature.What file formats can batch OCR import and export?It can import common image formats like jpg, png, webp, bmp and tif/tiff, and export results as txt, jsonl, md, or csv (Excel).
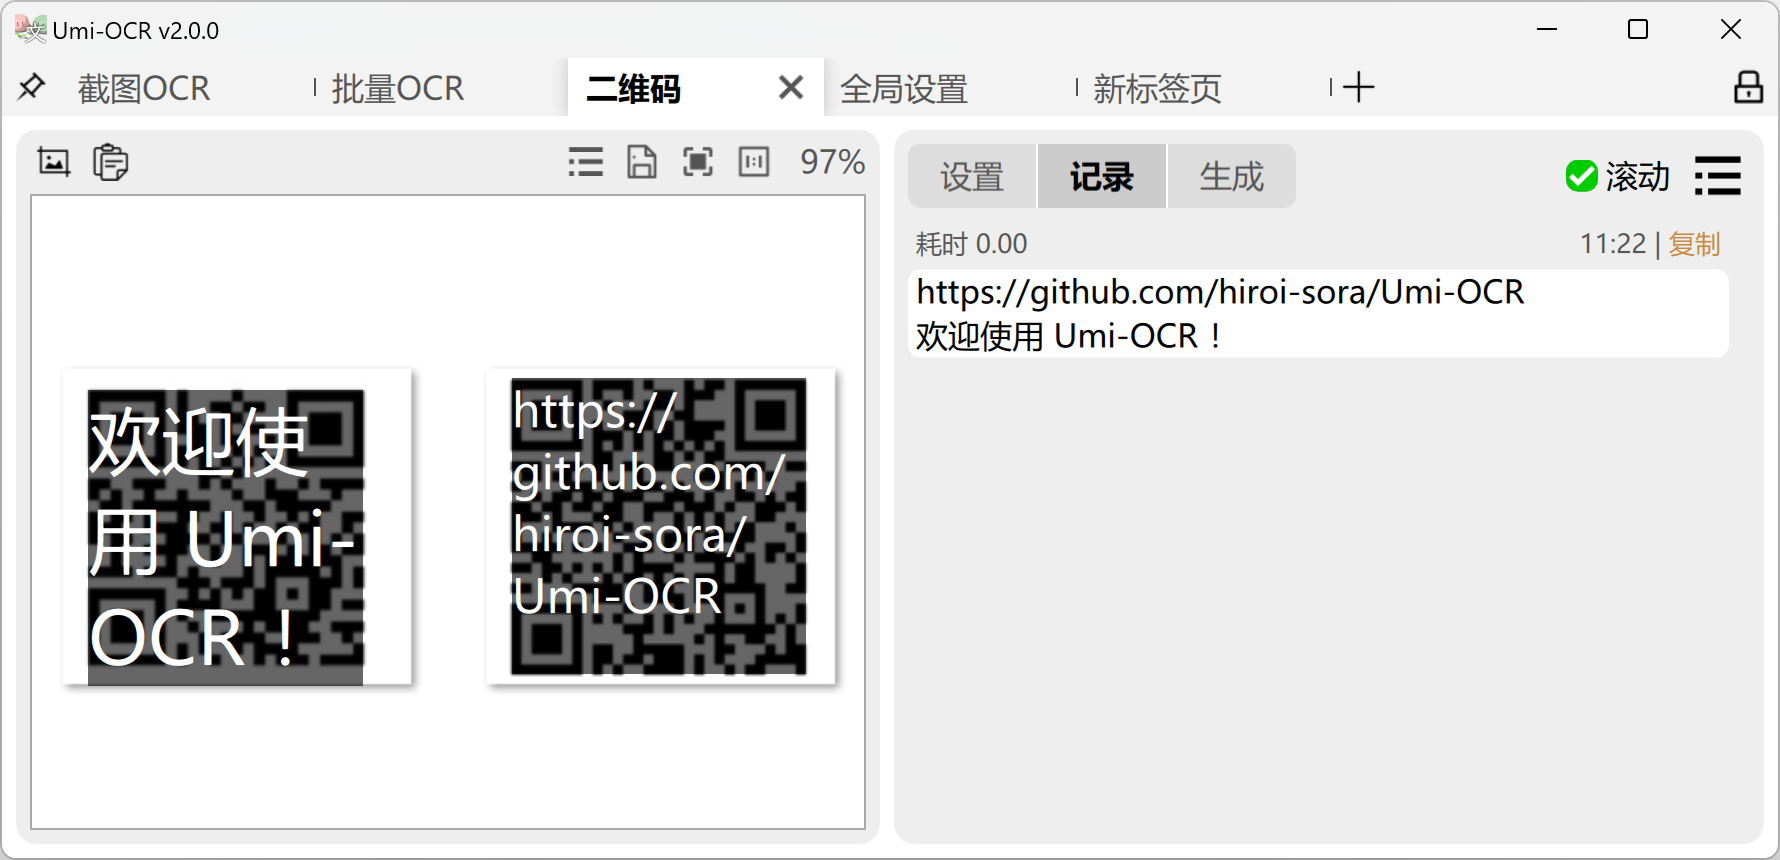
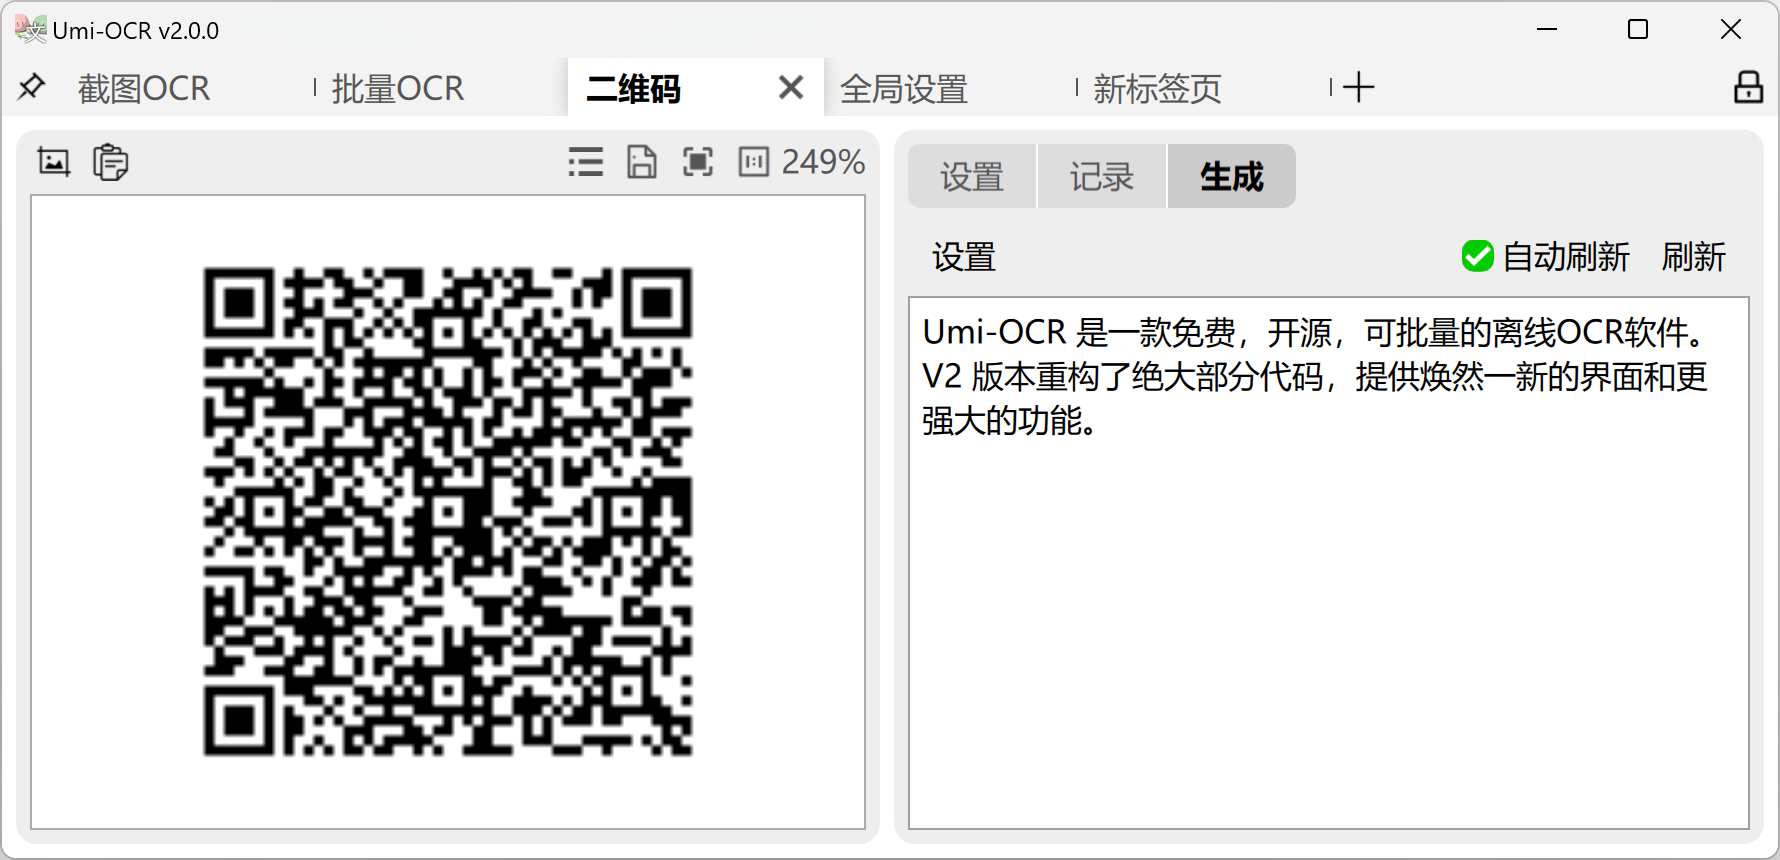
It can import common image formats like jpg, png, webp, bmp and tif/tiff, and export results as txt, jsonl, md, or csv (Excel).Can it read or generate QR codes?Yes — it scans QR codes and barcodes across 19 protocols (QRCode, Code128, DataMatrix, EAN13, etc.) and can also generate QR code images from text.
Yes — it scans QR codes and barcodes across 19 protocols (QRCode, Code128, DataMatrix, EAN13, etc.) and can also generate QR code images from text.What document formats can it process besides images?Besides scanned PDFs, it supports xps, epub, mobi, fb2 and cbz files, and can output a searchable two-layer PDF with the extracted text overlaid.
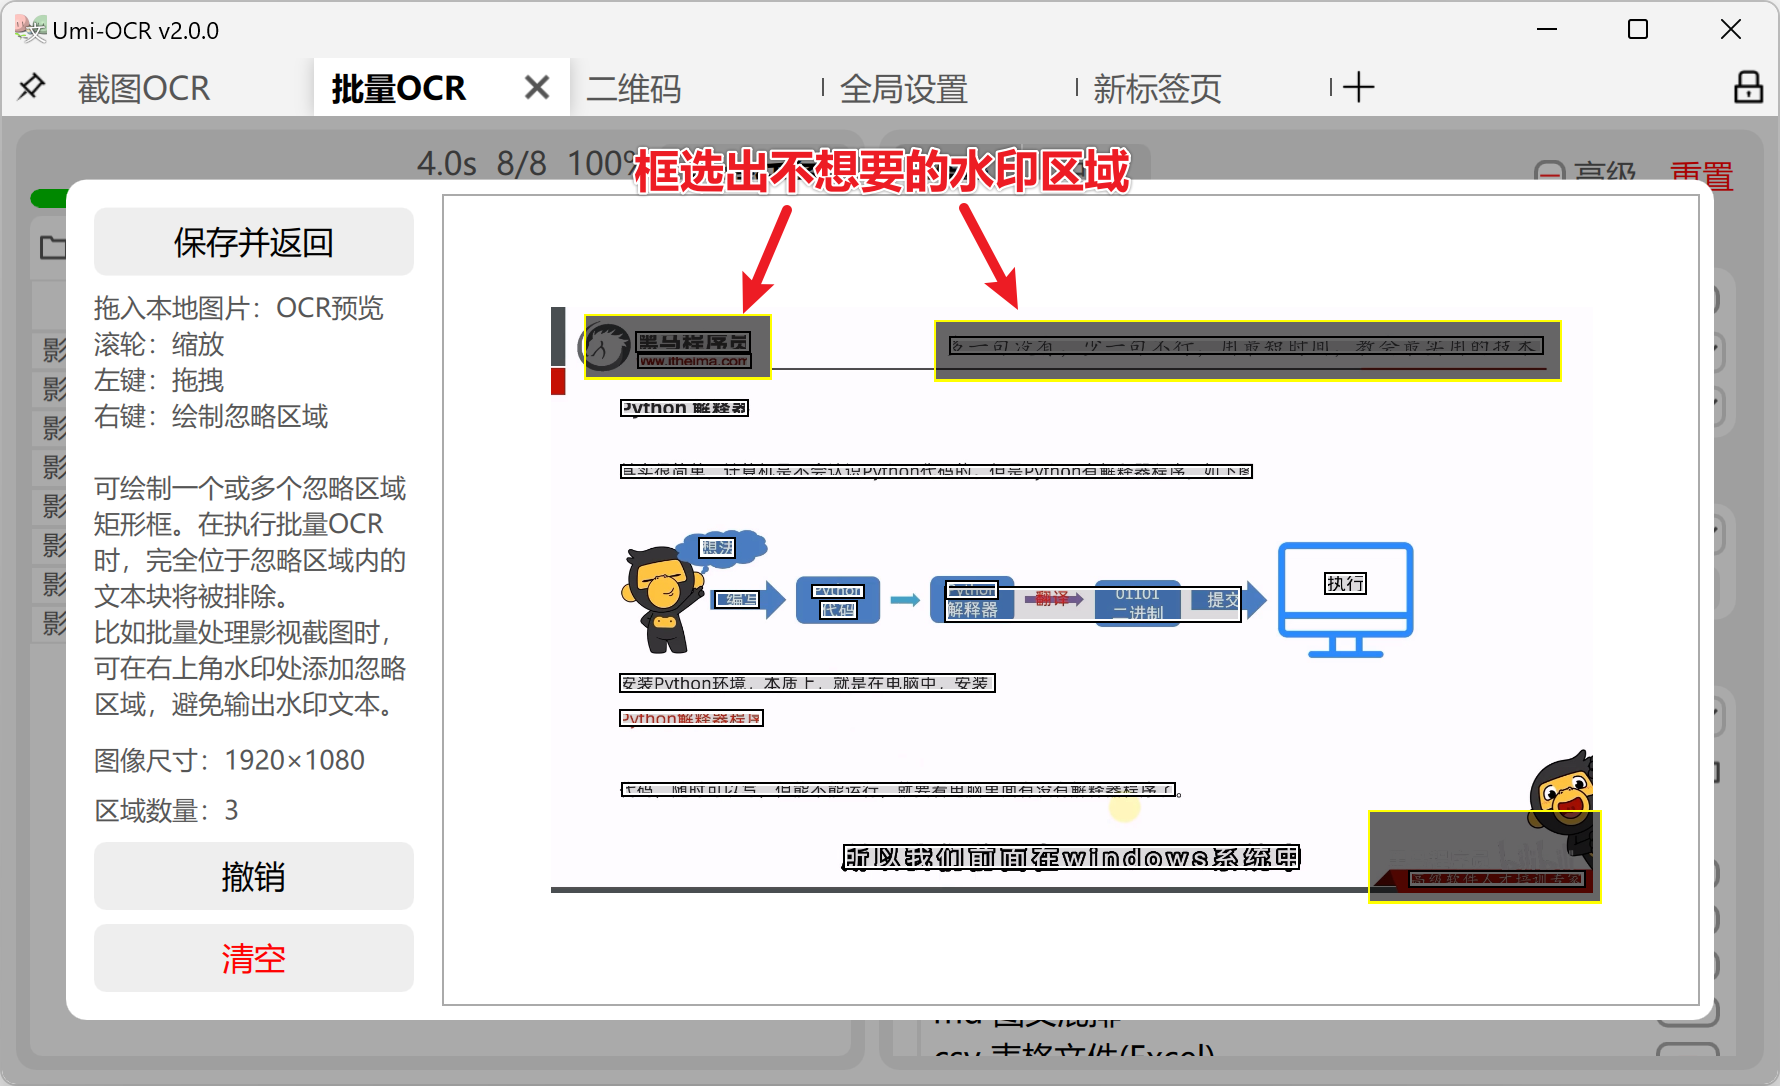
Besides scanned PDFs, it supports xps, epub, mobi, fb2 and cbz files, and can output a searchable two-layer PDF with the extracted text overlaid.Can it exclude watermarks or headers/footers from recognition?Yes — the 'ignore area' editor lets you draw rectangles over watermark, header or footer zones, and any text block fully inside those boxes is skipped during recognition.
Yes — the 'ignore area' editor lets you draw rectangles over watermark, header or footer zones, and any text block fully inside those boxes is skipped during recognition.What are similar projects?Filee, flyingmouse-format, OCRmyPDF, X-AnyLabeling, March7thAssistant, ok-wuthering-waves, palette-from-image-ai, KillerPDF
Filee, flyingmouse-format, OCRmyPDF, X-AnyLabeling, March7thAssistant, ok-wuthering-waves, palette-from-image-ai, KillerPDFWhich topics is it in?qml, batch-processing, qt, qr-code, screenshot, ocr, document-processing, multilingual, image-processing, pdf, offline, computer-vision
qml, batch-processing, qt, qr-code, screenshot, ocr, document-processing, multilingual, image-processing, pdf, offline, computer-vision